
CMU数据库(15-445)实验2-B+树索引实现(下+课上笔记)
4. Index_Iterator实现
这里就是需要实现迭代器的一些操作,比如begin、end、isend等等
下面是对于IndexIterator的构造函数
template <typename KeyType, typename ValueType, typename KeyComparator>

IndexIterator<KeyType, ValueType, KeyComparator>::

IndexIterator(BPlusTreeLeafPage<KeyType, ValueType, KeyComparator> *leaf,

              int index_, BufferPoolManager *buff_pool_manager):

    leaf_(leaf), index_(index_), buff_pool_manager_(buff_pool_manager) {}
1. 首先我们来看begin函数的实现
- 利用key值找到叶子结点
- 然后获取当前key值的index就是begin的位置
INDEX_TEMPLATE_ARGUMENTS

INDEXITERATOR_TYPE BPLUSTREE_TYPE::Begin(const KeyType &key) {

  auto leaf = reinterpret_cast<BPlusTreeLeafPage<KeyType, ValueType,KeyComparator> *>(FindLeafPage(key, false));

  int index = 0;

  if (leaf != nullptr) {

    index = leaf->KeyIndex(key, comparator_);

  }

  return IndexIterator<KeyType, ValueType, KeyComparator>(leaf, index, buffer_pool_manager_);

}
2. end函数的实现
- 找到最开始的结点
- 然后一直向后遍历直到
nextPageId=-1结束 - 这里注意需要重载
!=和==
end函数
INDEX_TEMPLATE_ARGUMENTS

INDEXITERATOR_TYPE BPLUSTREE_TYPE::end() {

  KeyType key{};

  auto leaf= reinterpret_cast<BPlusTreeLeafPage<KeyType, ValueType,KeyComparator> *>( FindLeafPage(key, true));

  page_id_t new_page;

  while(leaf->GetNextPageId()!=INVALID_PAGE_ID){

    new_page=leaf->GetNextPageId();

    leaf=reinterpret_cast<BPlusTreeLeafPage<KeyType, ValueType,KeyComparator> *>(buffer_pool_manager_->FetchPage(new_page));

  }

  buffer_pool_manager_->UnpinPage(new_page,false);

  return IndexIterator<KeyType, ValueType, KeyComparator>(leaf, leaf->GetSize(), buffer_pool_manager_);

}
==和 !=函数
bool operator==(const IndexIterator &itr) const {

  return this->index_==itr.index_&&this->leaf_==itr.leaf_;

}

bool operator!=(const IndexIterator &itr) const {

  return !this->operator==(itr);

}
3. 重载++和*(解引用符号)
- 重载++
简单的index++然后设置nextPageId即可
template <typename KeyType, typename ValueType, typename KeyComparator>

IndexIterator<KeyType, ValueType, KeyComparator> &IndexIterator<KeyType, ValueType, KeyComparator>::

operator++() {

//

 // std::cout<<"++"<<std::endl;

  ++index_;

  if (index_ == leaf_->GetSize() && leaf_->GetNextPageId() != INVALID_PAGE_ID) {

    // first unpin leaf_, then get the next leaf

    page_id_t next_page_id = leaf_->GetNextPageId();

    auto *page = buff_pool_manager_->FetchPage(next_page_id);

    if (page == nullptr) {

      throw Exception("all page are pinned while IndexIterator(operator++)");

    }

    // first acquire next page, then release previous page

    page->RLatch();

    buff_pool_manager_->FetchPage(leaf_->GetPageId())->RUnlatch();

    buff_pool_manager_->UnpinPage(leaf_->GetPageId(), false);

    buff_pool_manager_->UnpinPage(leaf_->GetPageId(), false);

    auto next_leaf =reinterpret_cast<BPlusTreeLeafPage<KeyType, ValueType,KeyComparator> *>(page->GetData());

    assert(next_leaf->IsLeafPage());

    index_ = 0;

    leaf_ = next_leaf;

  }

  return *this;

};
- 重载*
return array[index]即可
template <typename KeyType, typename ValueType, typename KeyComparator>

const MappingType &IndexIterator<KeyType, ValueType, KeyComparator>::

operator*() {

  if (isEnd()) {

    throw "IndexIterator: out of range";

  }

  return leaf_->GetItem(index_);

}
5. 并发机制的实现
0. 首先复习一下读写机制
- 读操作是可以多个进程之间共享latch的而写操作则必须互斥
- 加入
MaxReader数就是为了防止等待的️写进程饥饿
首先来看如果没有机制多线程会发生什么问题
- 线程T1想要删除44。
- 线程T2 想要查找41
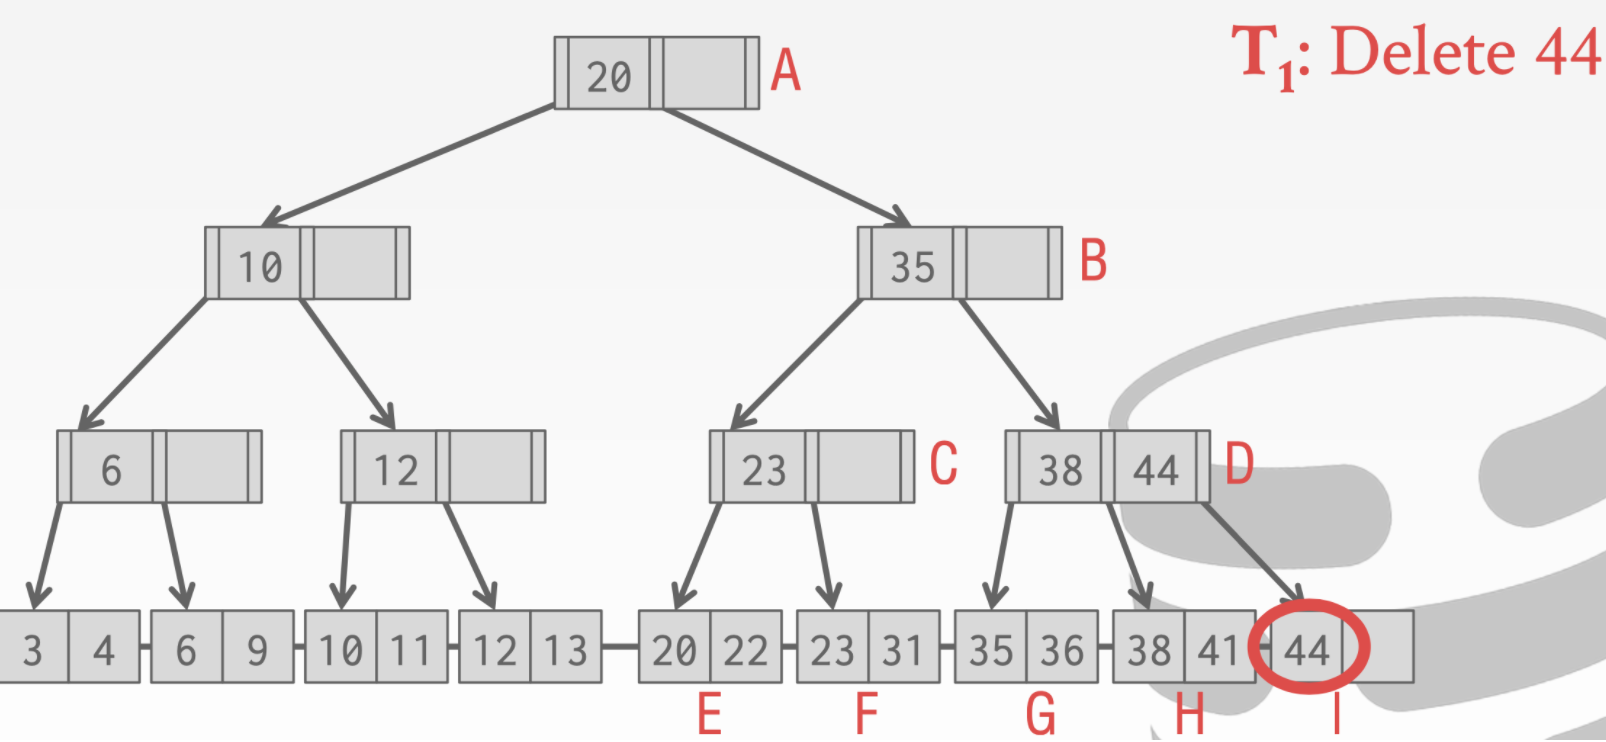
- 假设T2在执行到D位置的时候又切换到线程T1
- 这个时候T1进行重新分配,会把41借到I结点上
- T1执行完成切换回T2这时候T2再去原来的执行寻找41就会找不到
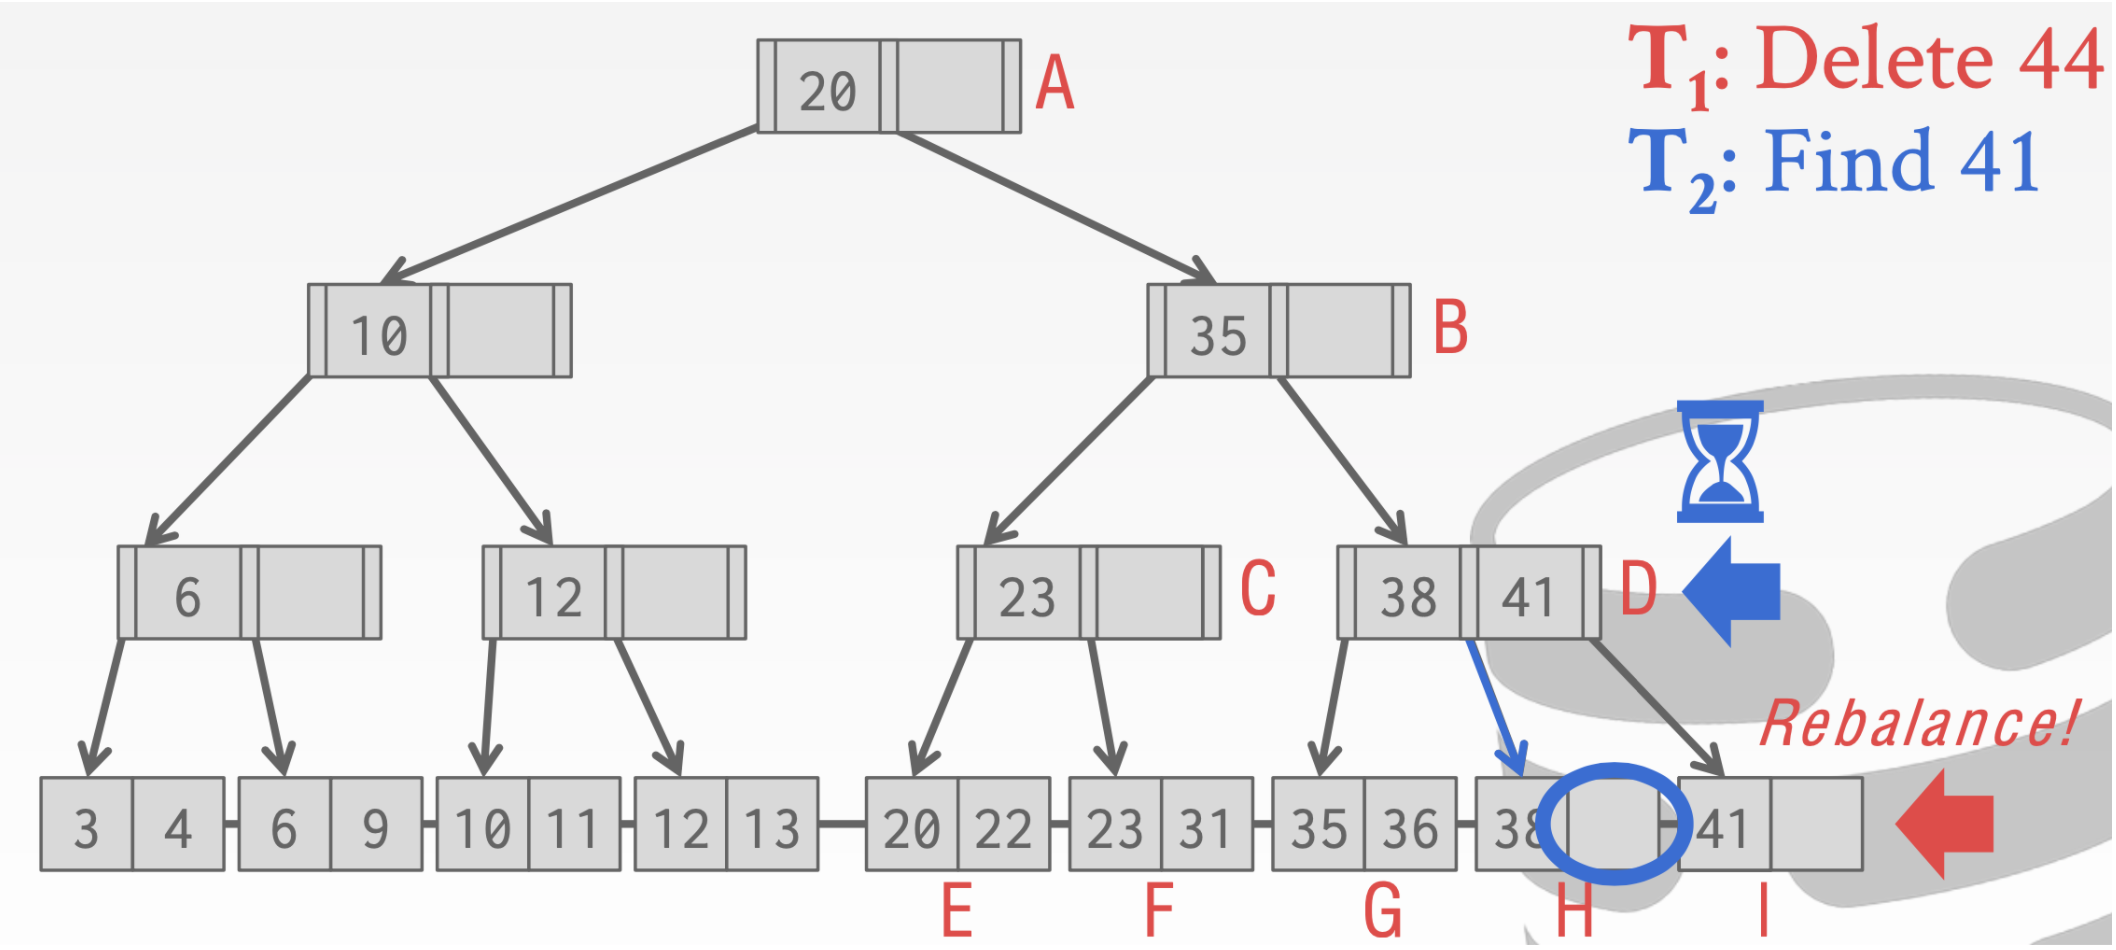
就会出现下面的情况。

由此我们需要读写的存在
- 对于find操作
由于我们是只读操作,所以我们到下一个结点的时候就可以释放上一个结点的Latch

剩下的操作都是一样的
- 对于
delete则不一样
因为我们需要写操作
这里我们不能释放结点A的Latch。因为我们的删除操作可能会合并根节点。

到D的时候。我们会发现D中的38删除之后不需要进行合并,所以对于A和B的写Write是可以安全释放了

- 对于
Insert操作
这里我们就可以安全的释放掉A的锁。因为B中还有空位,我们插入是不会对A造成影响的

当我们执行到D这里发现D中已经满了。所以此时我们不会释放B的锁,因为我们会对B进行写操作

上面的算法虽然是正确的但是有瓶颈问题。由于只有一个线程可以获得写Latch。而插入和删除的时候都需要对头结点加写Latch。所以多线程在有许多个插入或者删除操作的时候,性能就会大打折扣

这里要引入乐观
乐观的假设大部分操作是不需要进行合并和分裂的。因此在我们向下的时候都是读Latch而不是写Latch。只有在叶子结点才是write Latch
- 从上到下都是读Latch。而且逐步释放
- 到叶子结点需要修改的时候才为写Latch。这个删除是安全的所以直接结束

- 当我们到最后一步发现不安全的时候。则需要像上面我们没有引入乐观的时候一样。重新执行一遍

B-Link Tree简介
延迟更新父结点
这里用一个来标记这里需要被更新但是还没有执行

这个时候我们执行其他操作也是正确的比如查找31

这里我们执行insert 33
当执行到结点C的时候。因为这个时候有另一个线程持有了write Latch。所以这个时候操作要执行。随后在插入33

最后一点补充关于扫描操作的
- 线程1在C结点上持有write Latch
- 线程2已经扫描完了结点B想要获得结点C的read Latch
这时候会发生问题,因为线程2无法拿到read Latch
这里有几种解决方法
- 可以等到T1的写操作完成
- 可以重新执行T2
- 可以直接让线程T2停止抢得这个Latch。

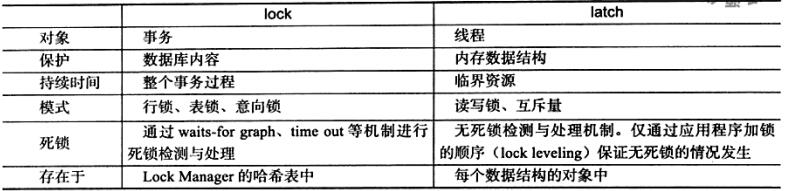
注意这里的Latch和Lock并不一样
1. 辅助函数UnlockUnpinPages的实现
- 如果是读操作则释放read锁
- 否则释放write锁
INDEX_TEMPLATE_ARGUMENTS

void BPLUSTREE_TYPE::

UnlockUnpinPages(Operation op, Transaction *transaction) {

  if (transaction == nullptr) {

    return;

  }

  for (auto page:*transaction->GetPageSet()) {

    if (op == Operation::READ) {

      page->RUnlatch();

      buffer_pool_manager_->UnpinPage(page->GetPageId(), false);

    } else {

      page->WUnlatch();

      buffer_pool_manager_->UnpinPage(page->GetPageId(), true);

    }

  }

  transaction->GetPageSet()->clear();

  for (const auto &page_id: *transaction->GetDeletedPageSet()) {

    buffer_pool_manager_->DeletePage(page_id);

  }

  transaction->GetDeletedPageSet()->clear();

  // if root is locked, unlock it

  node_mutex_.unlock();

  }
四个自带的解锁和上锁操作
/** Acquire the page write latch. */

inline void WLatch() { rwlatch_.WLock(); }

/** Release the page write latch. */

inline void WUnlatch() { rwlatch_.WUnlock(); }

/** Acquire the page read latch. */

inline void RLatch() { rwlatch_.RLock(); }

/** Release the page read latch. */

inline void RUnlatch() { rwlatch_.RUnlock(); }
这里的rwlatch是自己实现的读写锁类下面来探究一下这个类
由于c++ 并发编程我现在还不太会。。。所以就简单看一下啦后面学完并发编程再补充
WLock函数- 首先获取一个锁
- 用一个记号
writer_entered表示是否有写操作 - 如果之前已经有了现在的操作就需要等(这个线程处于阻塞状态)
- 当前如果有其他线程执行读操作。则仍需要阻塞(别人读的时候你不能写)
void WLock() {

  std::unique_lock<mutex_t> latch(mutex_);

  while (writer_entered_) {

    reader_.wait(latch);

  }

  writer_entered_ = true;

  while (reader_count_ > 0) {

    writer_.wait(latch);

  }

}
WunLock函数- 写标记置为false
- 然后通知所有的线程
void WUnlock() {

  std::lock_guard<mutex_t> guard(mutex_);

  writer_entered_ = false;

  reader_.notify_all();

}
RLock函数- 如果当前有人在写或者已经有最多的人读了则阻塞
- 否则只需要让读的计数++
因为是允许多个线程一起读这样并不会出错
void RLock() {

  std::unique_lock<mutex_t> latch(mutex_);

  while (writer_entered_ || reader_count_ == MAX_READERS) {

    reader_.wait(latch);

  }

  reader_count_++;

}
RUnLatch函数- 计数--
- 如果当前有人在写并且无人读的话需要通知所有其他线程
- 如果在计数--之前达到了最大读数,释放这个锁之后需要通知其他线程,现在又可以读了。
void RUnlock() {

  std::lock_guard<mutex_t> guard(mutex_);

  reader_count_--;

  if (writer_entered_) {

    if (reader_count_ == 0) {

      writer_.notify_one();

    }

  } else {

    if (reader_count_ == MAX_READERS - 1) {

      reader_.notify_one();

    }

  }

}
6. Summary
好了终于磕磕绊绊的写完了Lab2.关于数据库的Lab2应该会停一段时间。这段时间要补一补深度学习(毕竟要毕业)然后赶工一下老师给的活。同时学一下c++并发编程和看一下侯捷老师的课程。
最后附上GitHub的
CMU数据库(15-445)实验2-B+树索引实现(下+课上笔记)的更多相关文章
- [已完结]CMU数据库(15-445)实验2-B+树索引实现(下)
4. Index_Iterator实现 这里就是需要实现迭代器的一些操作,比如begin.end.isend等等 下面是对于IndexIterator的构造函数 template <typena ...
- InnoDB的B+树索引使用
何时使用索引 并不是在所有的查询条件下出现的列都需要添加索引.对于什么时候添加B+树索引,我的经验是访问表中很少一部分行时,使用B+树索引才有意义.对于性别字段.地区字段.类型字段,它们可取值的范围很 ...
- 搞懂MySQL InnoDB B+树索引
一.InnoDB索引 InnoDB支持以下几种索引: B+树索引 全文索引 哈希索引 本文将着重介绍B+树索引.其他两个全文索引和哈希索引只是做简单介绍一笔带过. 哈希索引是自适应的,也就是说这个不能 ...
- MySQL InnoDB引擎B+树索引简单整理说明
本文出处:http://www.cnblogs.com/wy123/p/7211742.html (保留出处并非什么原创作品权利,本人拙作还远远达不到,仅仅是为了链接到原文,因为后续对可能存在的一些错 ...
- CMU数据库(15-445)实验2-b+树索引实现(上)
Lab2 在做实验2之前请确保实验1结果的正确性.不然你的实验2将无法正常进行 环境搭建地址如下 https://www.cnblogs.com/JayL-zxl/p/14307260.html 实验 ...
- CMU数据库(15-445)Lab3- QUERY EXECUTION
Lab3 - QUERY EXECUTION 实验三是添加对在数据库系统中执行查询的支持.您将实现负责获取查询计划节点并执行它们的executor.您将创建执行下列操作的executor Access ...
- CMU数据库(15-445)Lab0-环境搭建
0.写在前面 从这篇文章开始.开一个新坑,记录以下自己做cmu数据库实验的过程,同时会分析一下除了要求我们实现的代码之外的实验自带的一些代码.争取能够对实现一个数据库比较了解.也希望能写进简历.让自己 ...
- CMU数据库(15-445) Lab4-CONCURRENCY CONTROL
Lab4- CONCURRENCY CONTROL 拖了很久终于开始做实验4了.lab4有三个大任务1. Lock Manager.2. DEADLOCK DETECTION .3. CONCURRE ...
- B树索引最通俗易懂的介绍
先来一段有莫的对话: 前几天下班回到家后正在处理一个白天没解决的bug,厕所突然传来对象的声音: 对象:xx,你有<时间简史>吗? 我:我去!妹子,你这啥癖好啊,我有时间也不会去捡屎 ...
随机推荐
- Kali Linux破解wifi密码(无须外置网卡)
环境准备: 方式一(选择该方式):Kali Linux.笔记本一台.U盘(至少8G) 方式二:Kali Linux.外置网卡.笔记本一台.VM 特别说明,主要是使用方式一进行破解,如果有外置网 ...
- rocketMq 消息偏移量 Offset
消息偏移量 Offset queue0 offset 0 0-20 offset 4 20-40 纠错:每条消息的tag对应的HashCode. queue1 offset 1 0-20 ...
- 阿里云Centos7.6中部署nginx1.16+uwsgi2.0.18+Django2.0.4
当你购买了阿里云的ecs,涉及ecs的有两个密码,一定要搞清楚,一个密码是远程链接密码,也就是通过浏览器连接服务器的密码,另外一个是实例密码,这个密码就是ecs的root密码,一般情况下,我们经常用到 ...
- Erlang那些事儿第2回之我是模块(module),一文件一模块
前几篇文章会写得比较基础,但是既然要写一系列的文章,还是得从基础开始写.我刚学Erlang碰到最大的问题是,想网上搜索下语法,结果却是寥寥无几,而且介绍得不是很系统,对我了解一些细节是有影响的,正好我 ...
- Appium App UI 自动化测试理论知识
(一)App自动化测试背景 随着移动终端的普及,手机应用越来越多,也越来越重要.App的回归测试用例数量越来越多,全量回归也越来越消耗时间.另外移动端碎片化严重(碎片化:兼容性测试,手机品牌多样.An ...
- C# 汉字转拼音 取汉字拼音的首字母
using System.Text.RegularExpressions; namespace DotNet.Utilities { /// <summary> /// 汉字转拼音类 // ...
- 你好,Spring!
交个朋友 拿人钱财替人干活儿,在不影响工作的前提下,想做到很高频率的更新很难,但是我也尽力输出,不能为了写而写,宁缺毋滥吧. 我的想法是这样的,接下来的一段时间专门写Spring框架.整体思路就是:入 ...
- Offer快到碗里来,Volatile问题终结者
微信公众号:大黄奔跑关注我,可了解更多有趣的面试相关问题. 写在之前面试问题概览面试回顾大黄可见性Demo演示小插曲大黄可见性Demo演示小插曲大黄可见性Demo演示小插曲总结番外 写在之前 Hell ...
- 2020年Python文章盘点,我选出了个人TOP10
大家好,我是猫哥.2020年过得真快啊!总感觉这一年里还没有做成多少事,一眨眼就又到了写年度总结的时候了-- 去年1月1日的时候,我写了<我的 2019 年 Python 文章榜单>,简单 ...
- SonarQube学习(三)- 项目代码扫描
一.前言 元旦三天假,两天半都在玩86版本DNF,不得不说,这个服真的粘度太高了,但是真的很良心. 说明: 注册账号上线100w点券,一身+15红字史诗装备以及+21强化新手武器.在线泡点一分钟888 ...