
Hadoop理论基础
- namenode 50070
- datenode 50075
- secondarynamenode 50090
- yarn.resoucemanager 8088
- 历史服务器 19888
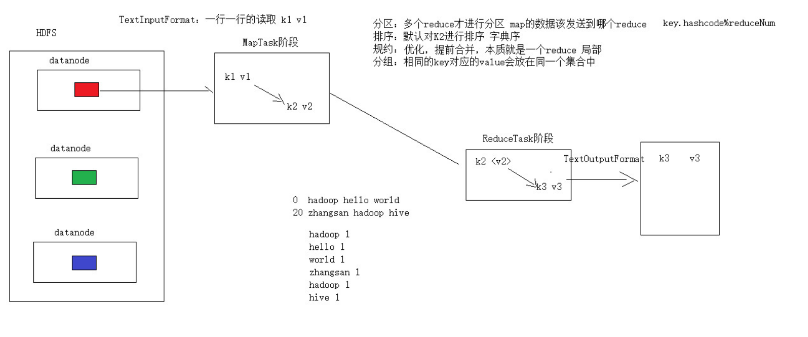
- MRAppMaster:负责整个程序的过程调度及状态协调
- MapTask:负责 map 阶段的整个数据处理流程
- ReduceTask:负责 reduce 阶段的整个数据处理流程
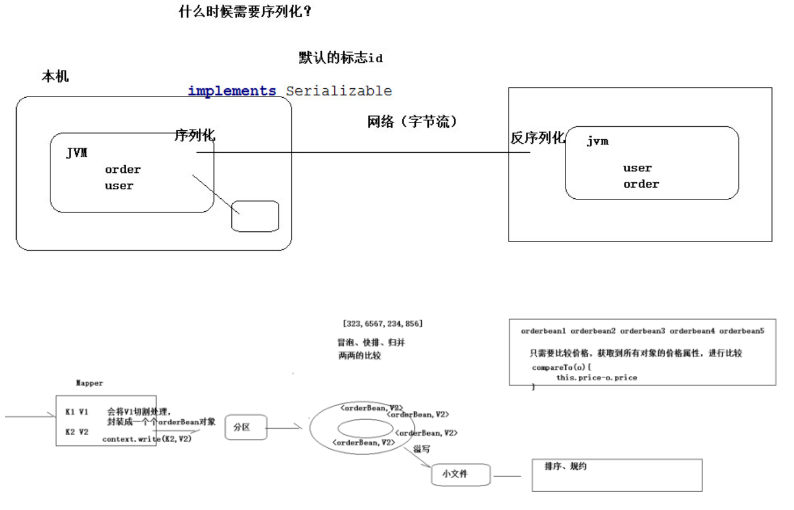
//反序列化的方法,反序列化时,

//从流中读取到的各个字段的顺序应该与序列化时

//写出去的顺序保持一致

 @Override

 public void readFields(DataInput in) throws IOException {

  upflow = in.readLong();

  dflow = in.readLong();

  sumflow = in.readLong();

 }

 //序列化的方法

 @Override

 public void write(DataOutput out) throws IOException {

  out.writeLong(upflow);

  out.writeLong(dflow);

  out.writeLong(sumflow);

 }

 @Override

 public int compareTo(FlowBean o) {

//实现按照 sumflow 的大小倒序排序

  return sumflow>o.getSumflow()?-1:1;

 }
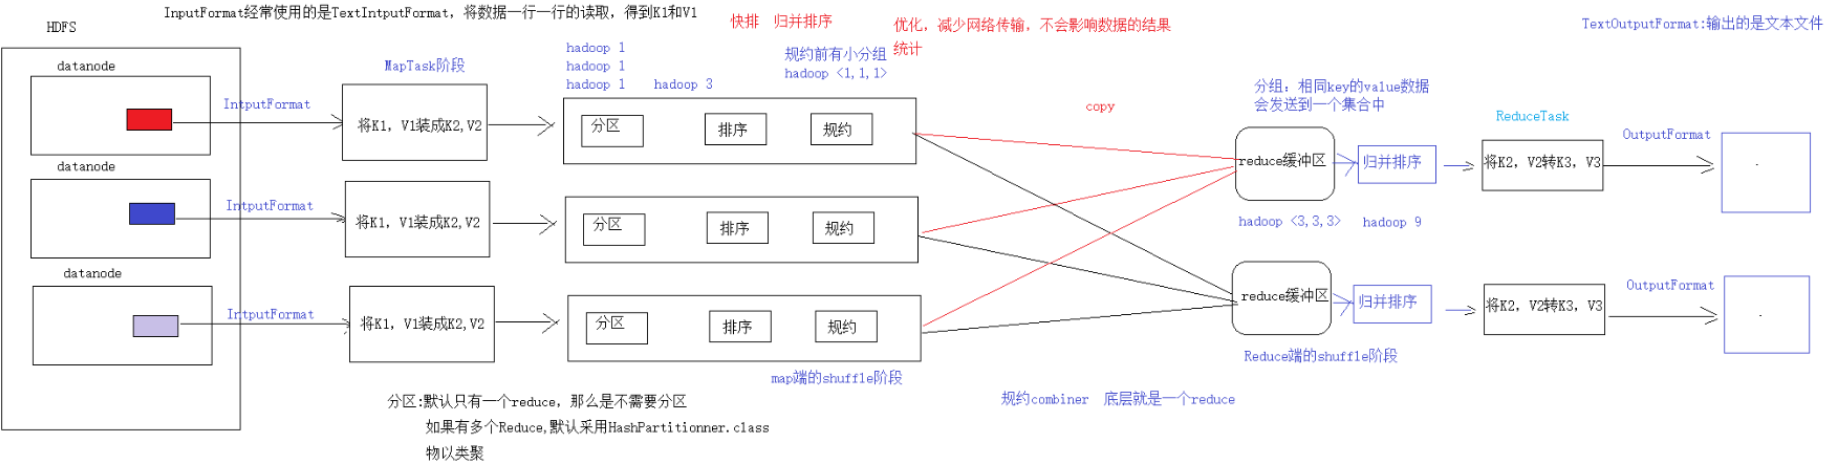
- combiner 是 MR 程序中 Mapper 和 Reducer 之外的一种组件
- combiner 组件的父类就是 Reducer
- combiner 和 reducer 的区别在于运行的位置:
- combiner 是在每一个 maptask 所在的节点运行
- reducer 是接收全局所有 Mapper 的输出结果;
- combiner 的意义就是对每一个 maptask 的输出进行局部汇总,以减小网络传输量
- 自定义一个 combiner 继承 Reducer,重写 reduce 方法
- 在 job 中设置: job.setCombinerClass(CustomCombiner.class)
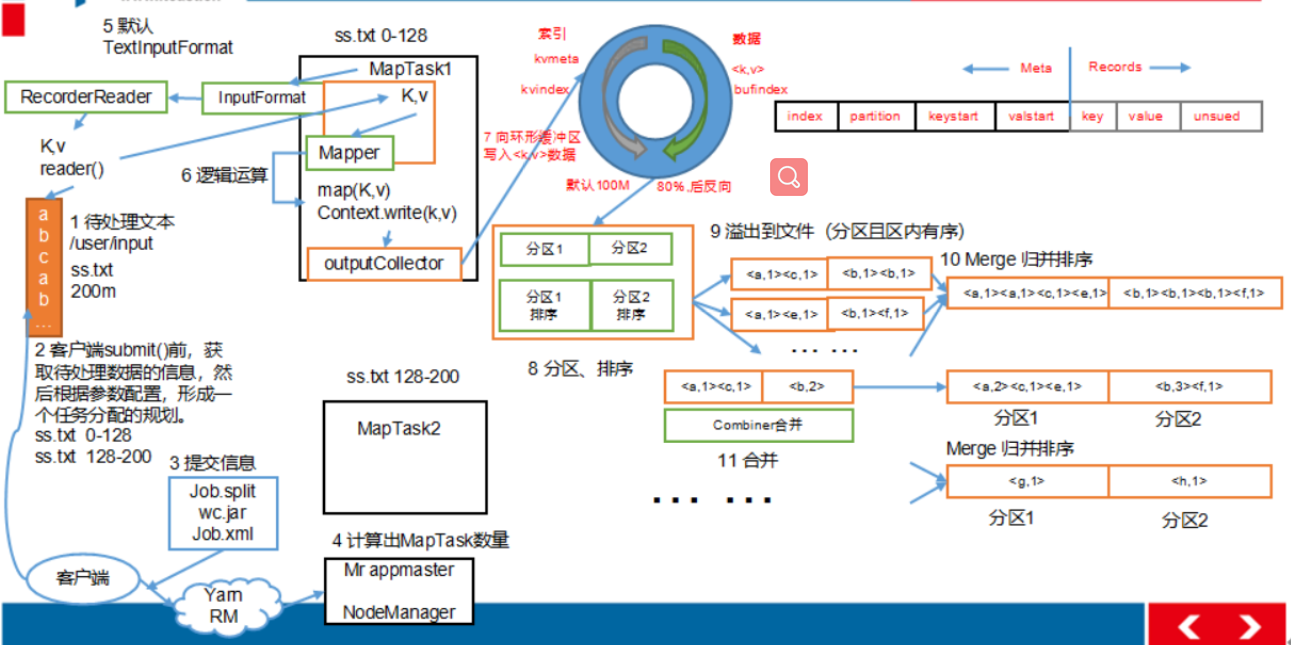
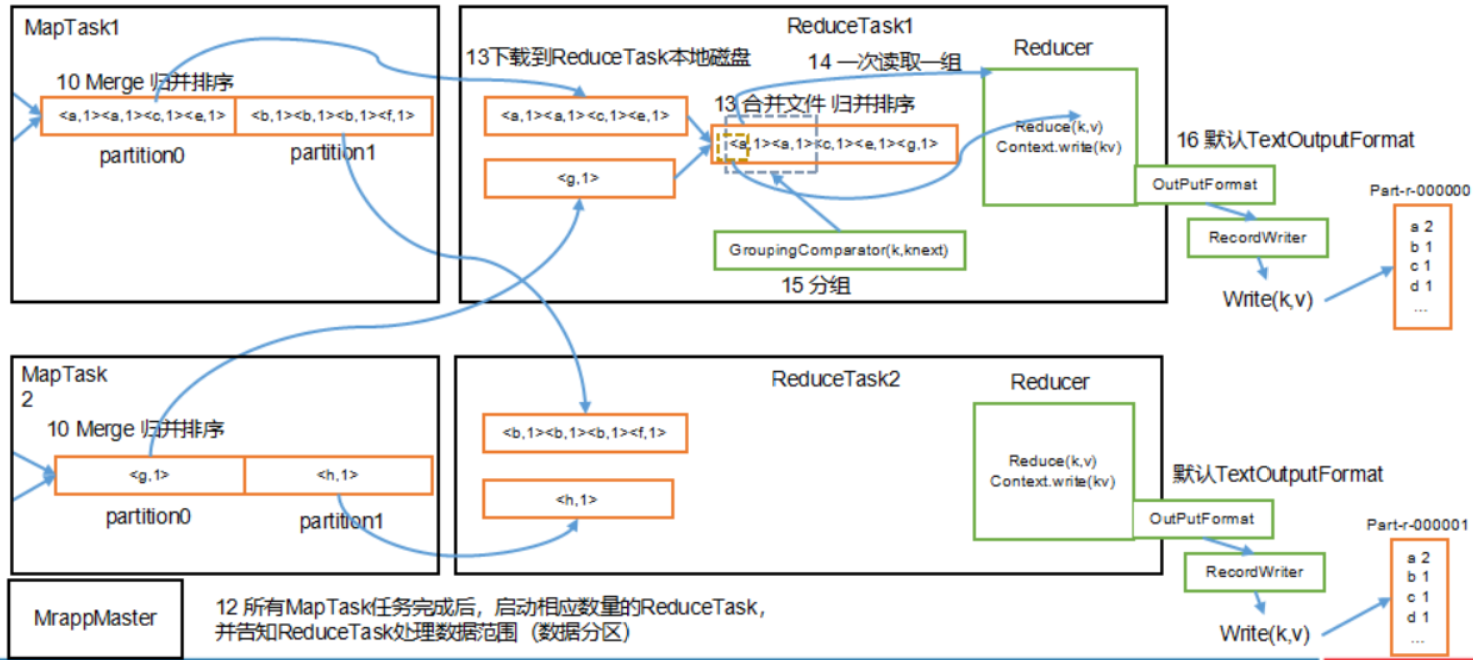
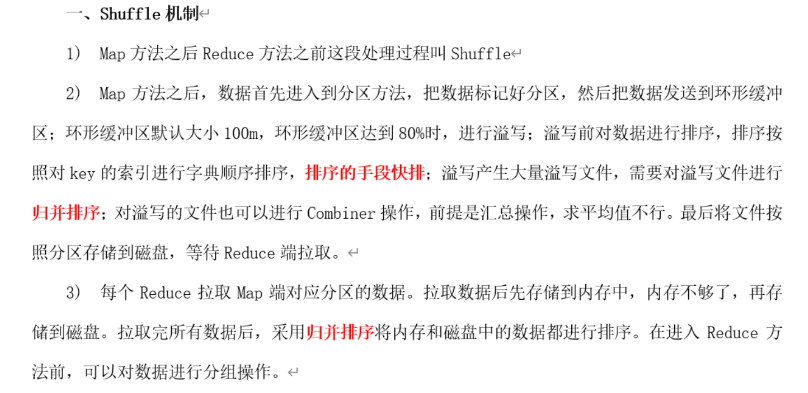
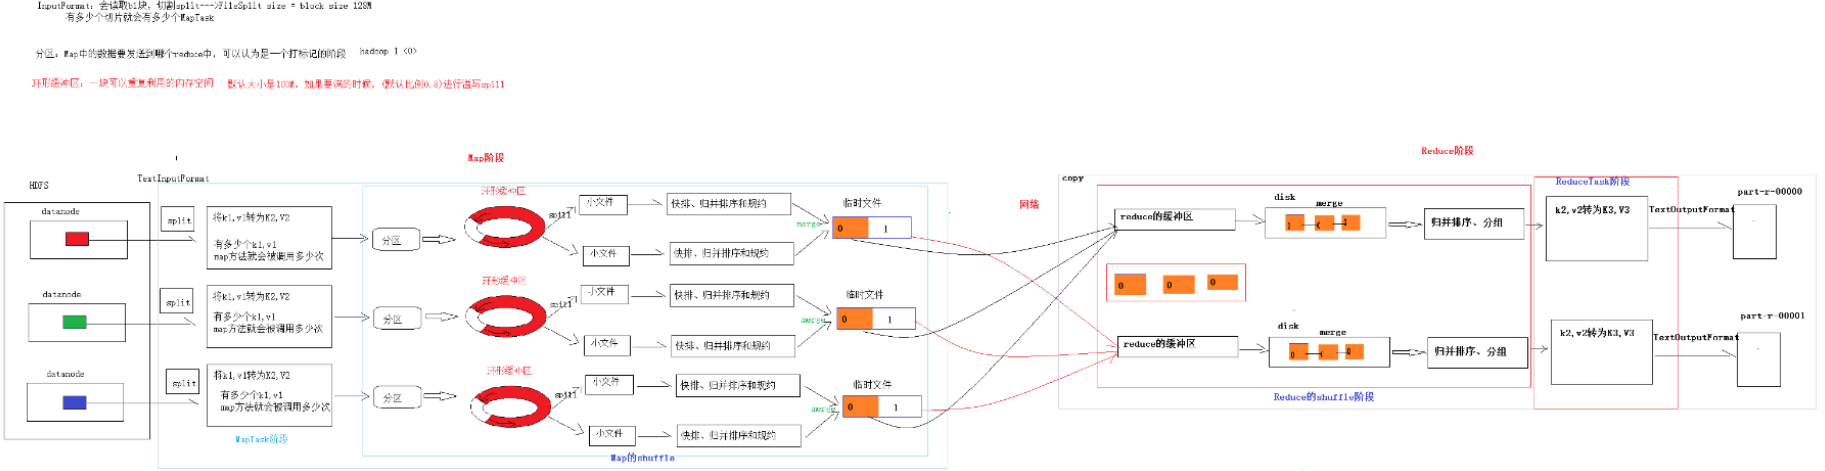
- 将map端结果输出到环形缓冲区, 默认为100M, 保存的是<key, value>和分区信息多个ReduceTask时才需要分区
- 当环形缓冲去到达80%时, 写入磁盘中, 在写入之前对数据进行快排, 如果配置了combiner, 还会对有相同分区号和key进行排序
- 将所有溢出的临时文件进行一次合并操作, 确保一个MapTask最终只生成一个文件
- Reduce复制一份数据, 默认保存在内存的缓冲区中, 到达阈值, 将数据写到磁盘
- Reduce复制数据同时, 开启两个线程对内存到本地的数据进行合并
- 进行合并数据同时, 进行排序, 因为Map端已进行局部排序, Reduce只需保证数据整体有效
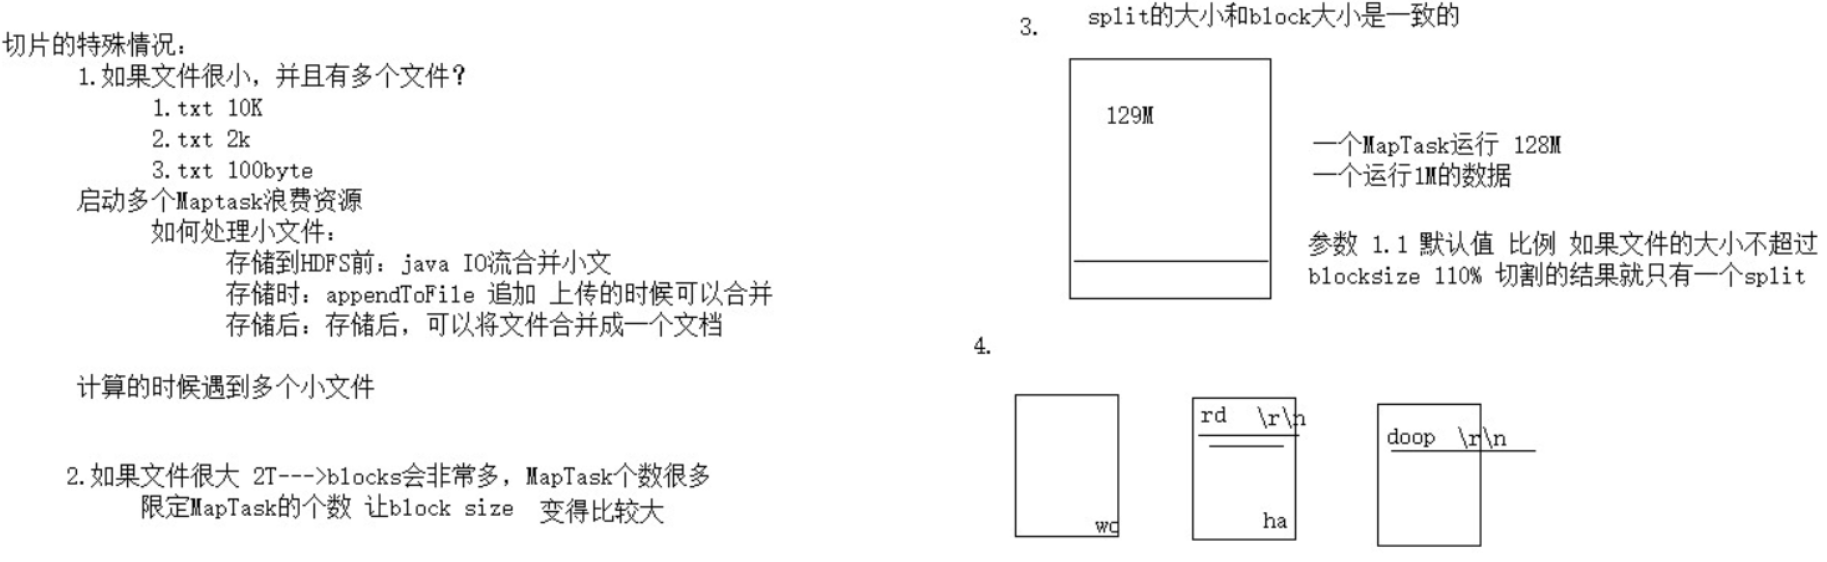
- 单纯按照文件内容切分
- 切片大小等于block块大小
- 不考虑数据集整体, 逐个针对文件切片
- 切片公式: max(0, min(Long_max, blockSize))
- 内存元数据:文件信息、块信息、datanode节点信息
- 文件元数据:只包含文件信息,其他信息是在datanode启动的时候进行上报
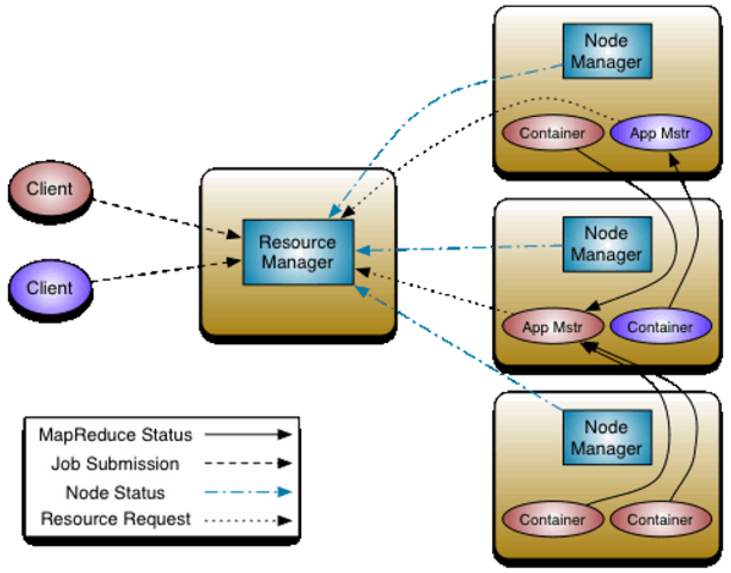
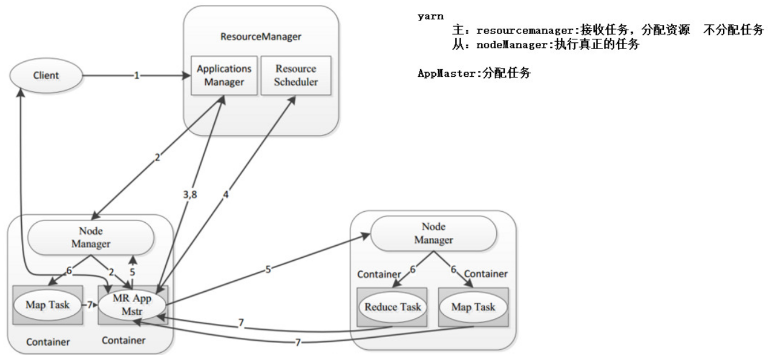
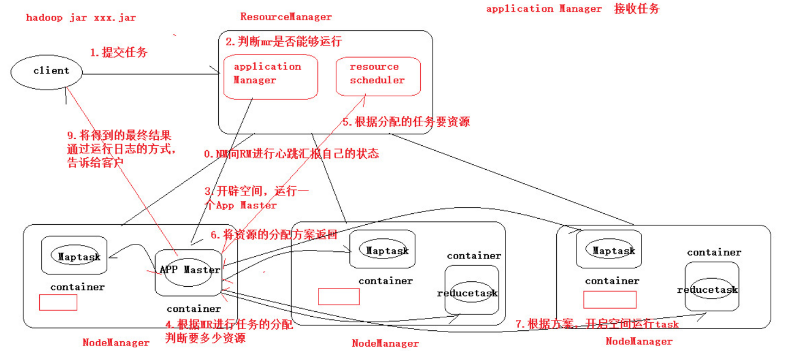
- 客户端向RM提交程序, 包括AppMaster的必须信息,例如 ApplicationMaster 程序、启动 ApplicationMaster 的命令、用户程序等。
- RM启动Container用来运行AppMaster
- 启动中的AppMaster向RM注册, 启动完成后与RM保持心跳
- AppMaster向RM申请相应数量的Container
- RM返回AppMaster申请的Container信息, 由AppMaster对其进行初始化
- AppMaster与NM进行通信, 要求NM启动Container, 两者保持心跳, 从而对NM运行的任务进行管理和监控
- AppMaster对运行中的Container进行监控, Container通过RPC协议对相应的NM汇报信息
- 客户端通过AppMaster获取运行状态进度等信息
- 结束后, AppMaster向RM进行注销, 并回收Container
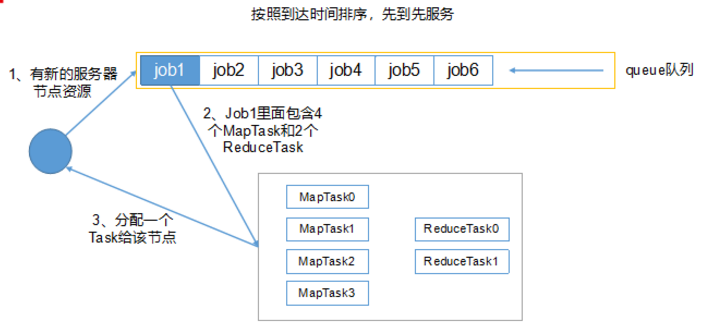
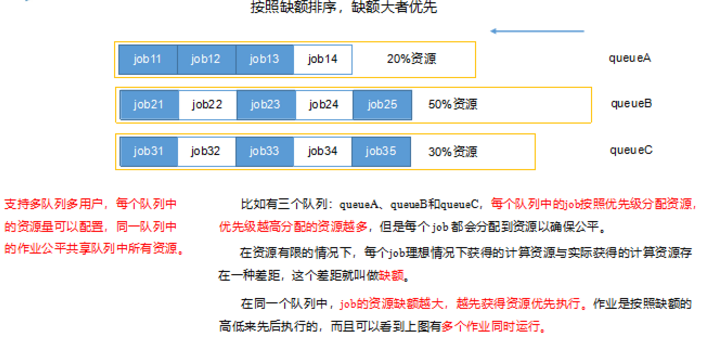
- 每个队列可配置资源
- 对同一用户提交的作业所占资源进行限定
- 首先, 计算每个队列中正在进行的任务与所分得资源的比值, 选出一个值最小的队列, 也就是最闲的
- 其次, 按照作业优先级和提交时间顺序, 同时考虑用户资源量限制和内存限制, 对队列中的任务排序
- 队列同时按照提交任务的顺序并行运行

- 每个队列的任务按照优先级分配资源, 优先级越高资源越多, 但是每个任务都可以分配到资源能保证公平
- 任务理想计算资源与实际计算资源的差值叫做缺额
- 同一队列中, 缺额越大, 任务优先级越高, 可多个作业同时运行

- 多个 NN 共用一个集群里的存储资源,每个 NN 都可以单独对外提供服务。
- 每个 NN 都会定义一个存储池,有单独的 id,每个 DN 都为所有存储池提供存储。
- DN 会按照存储池 id 向其对应的 NN 汇报块信息,同时,DN 会向所有 NN 汇报本地存储可用资源情况。
- 在hdfs-site.xml文件中配置多目录,最好提前配置好,否则更改目录需要重新启动集群
- NameNode有一个工作线程池,用来处理不同DataNode的并发心跳以及客户端并发的元数据操作。
- dfs.namenode.handler.count=20 * log2(Cluster Size),比如集群规模为10台时,此参数设置为60
- 编辑日志存储路径dfs.namenode.edits.dir设置与镜像文件存储路径dfs.namenode.name.dir尽量分开,达到最低写入延迟
- 服务器节点上YARN可使用的物理内存总量,默认是8192(MB),注意,如果你的节点内存资源不够8GB,则需要调减小这个值,而YARN不会智能的探测节点的物理内存总量。 yarn.nodemanager.resource.memory-mb
- 单个任务可申请的最多物理内存量,默认是8192(MB)。yarn.scheduler.maximum-allocation-mb
- 如果MR造成系统宕机。此时要控制Yarn同时运行的任务数,和每个任务申请的最大内存。调整参数:yarn.scheduler.maximum-allocation-mb(单个任务可申请的最多物理内存量,默认是8192MB)
- 如果写入文件过量造成NameNode宕机。那么调高Kafka的存储大小,控制从Kafka到HDFS的写入速度。高峰期的时候用Kafka进行缓存,高峰期过去数据同步会自动跟上。
Hadoop理论基础的更多相关文章
- 大数据-hdfs技术
hadoop 理论基础:GFS----HDFS:MapReduce---MapReduce:BigTable----HBase 项目网址:http://hadoop.apache.org/ 下载路径: ...
- hadoop入门(3)——hadoop2.0理论基础:安装部署方法
一.hadoop2.0安装部署流程 1.自动安装部署:Ambari.Minos(小米).Cloudera Manager(收费) 2.使用RPM包安装部署:Apache ...
- Hadoop生态圈学习-1(理论基础)
一.大数据技术产生的背景 1. 计算机和信息技术(尤其是移动互联网)的迅猛发展和普及,行业应用系统的规模迅速扩大(用户数量和应用场景,比如facebook.淘宝.微信.银联.12306等),行业应用所 ...
- Hadoop学习之路(一)理论基础和逻辑思维
三个题目 第一题 问题描述 统计出当前这个一行一个IP的文件中,到底哪个IP出现的次数最多 解决思路 //必须要能读取这个内容 BufferedReader br = new BuffedReader ...
- hadoop是什么
Hadoop一直是我想学习的技术,正巧最近项目组要做电子商城,我就开始研究Hadoop,虽然最后鉴定Hadoop不适用我们的项目,但是我会继续研究下去,技多不压身. <Hadoop基础教程> ...
- Hadoop基础学习框架
我们主要使用Hadoop的2个部分:分布式文件存储系统(HDFS)和MapReduce计算模型. 关于这2个部分,可以参考一下Google的论文:The Google File System 和 Ma ...
- 初识Hadoop入门介绍
初识hadoop入门介绍 Hadoop一直是我想学习的技术,正巧最近项目组要做电子商城,我就开始研究Hadoop,虽然最后鉴定Hadoop不适用我们的项目,但是我会继续研究下去,技多不压身. < ...
- [转]《Hadoop基础教程》之初识Hadoop
原文地址:http://blessht.iteye.com/blog/2095675 Hadoop一直是我想学习的技术,正巧最近项目组要做电子商城,我就开始研究Hadoop,虽然最后鉴定Hadoop不 ...
- hadoop初识
搞什么东西之前,第一步是要知道What(是什么),然后是Why(为什么),最后才是How(怎么做).但很多开发的朋友在做了多年项目以后,都习惯是先How,然后What,最后才是Why,这样只会让自己变 ...
随机推荐
- MonoBehaviour生命周期与对象数据池应用
预热游戏对象: tempObject = Instantiate(cubePrefab) as GameObject ; tempObject .SetActive( false ); 游戏对象tem ...
- hdu6704 2019CCPC网络选拔赛1003 K-th occurrence 后缀数组
题意:给你一个长度为n的字符串,有q个询问,每次询问一个子串s(l,r)第k次出现的位置,若子串出现次数少于k次输出-1. 解题思路:先把SA跑出来,然后对于每次询问可以由l和rank[]找到l在所有 ...
- vue、react等SPA应用页脚组件闪烁的解决办法
大家好,我是木瓜太香.大家在开发单页应用的时候,经常会遇到这样的需求,头部和尾部两个组件是大多数组件公用的,而中间的内容区域则是单独存在的,而且一般内容组件逻辑会比较多,如果我们不停刷新页面可能会出现 ...
- Q200510-01: 求部门工资最高的员工
问题: 求部门工资最高的员工 Employee 表包含所有员工信息,每个员工有其对应的 Id, salary 和 department Id. +----+-------+--------+----- ...
- [Java]取得当前代码所在函数的函数名
要取得当前运行代码的函数名,可以用: Thread.currentThread().getStackTrace()[1].getMethodName(); 但是,这行代码有些过长,嵌入业务代码稍显突兀 ...
- 零基础一分钟入门Python
这篇文章面向所有想学python的小伙伴(甚至你从没听过编程),这篇文章将会带你以最快的速度入门python.赶快上车,时间来不及了... 一,下载和安装python 1.下载: 1.1 python ...
- java集合类源码学习二
我们查看Collection接口的hierarchy时候,可以看到AbstractCollection<E>这样一个抽象类,它实现了Collection接口的部分方法,Collection ...
- flutter driver 集成测试
最近一直断断续续的学习flutter,今天跟大家介绍一下flutter driver测试. flutter测试基础 Flutter的测试遵循Android的测试规范进行了分层. 单元测试:测试单一功能 ...
- tomcat在linux服务器启动时报错Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x0000000794500000, 576716800, 0) failed; error='Cannot allocate memory' (errno=12)
原因是内存不足了 解决办法:1.top命令查看后台进程,看哪些可以关闭 2.ps -ef |grep tomcat看哪些不用的tomcat起着,也可以从这里关 3.加大这个tomcat的内存, 在ca ...
- JAVA知识点 I/O流框架简要笔记
I/O 框架 流的概念 内存与存储设备之间传输数据的通道 流的分类 按方向[重点] 输入流:将<存储设备>中的内容读到<内存>中 输出流:将<内存>中的内容写到&l ...