
python大作业二
一、存入csv
上次爬取到了所需要的内容,但是没有存入到csv中,这次存入了csv文件中,代码如下:
import requests

from bs4 import BeautifulSoup

import csv

import io

import sys

sys.stdout=io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030')

def get_url():#得到A-Z所有网站

    urls=[]

    for i in range(1,27):

        i = chr(i+96)

        urls.append('http://www.thinkbabynames.com/start/0/%s'%i)

    return urls

    pass

def get_text(url):#得到所有名字以及连接,爬取所需内容

    headers = {'Cookie':"User-Agent:Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Mobile Safari/537.36"}

    docx=requests.get(url)

    soup=BeautifulSoup(docx.content,'html.parser')

    c_txt1=soup.find('section',{'id':'index'}).findAll('b')

    for x in c_txt1:

        s=[]

        if x.find('a'):

            name=x.find('a')['href'].split("/")[-1]#使用正则表达式获得所有名字

            #url.append('http://www.thinkbabynames.com/meaning/0/%s'%i)#获得所有名字详情页链接

            if name:

                r=requests.get('http://www.thinkbabynames.com/meaning/0/%s'%name)

            result=r.text

            bs=BeautifulSoup(result,'html.parser')

            li=bs.find('div',class_='content').find('h1')

            Enname=li.text[8::1]#使用切片语法获得详情页名字(s[x:y:z]x为起始,y为终止,z为步长)

            Gender=li.text[1:8:1]#使用切片语法获得详情页名字性别

            li1=bs.find('section',id='meaning').find('p')

            Description=li1.text

            #保存名字,性别,简介到s中

            s.append(Enname)

            s.append(Gender)

            s.append(Description)

        save_text(s)

    return s

    pass

def save_text(s):#保存到csv中

    with open('text.csv','a',encoding='utf_8_sig',newline='')as f:

        writer = csv.writer(f)

        writer.writerow(s)

if __name__ == '__main__':

    urls=get_url();

    for url in urls:

        get_text(url)
如上把得到的名字,性别,以及简介存入s中,再把s存到csv中。
二、csv文件截图

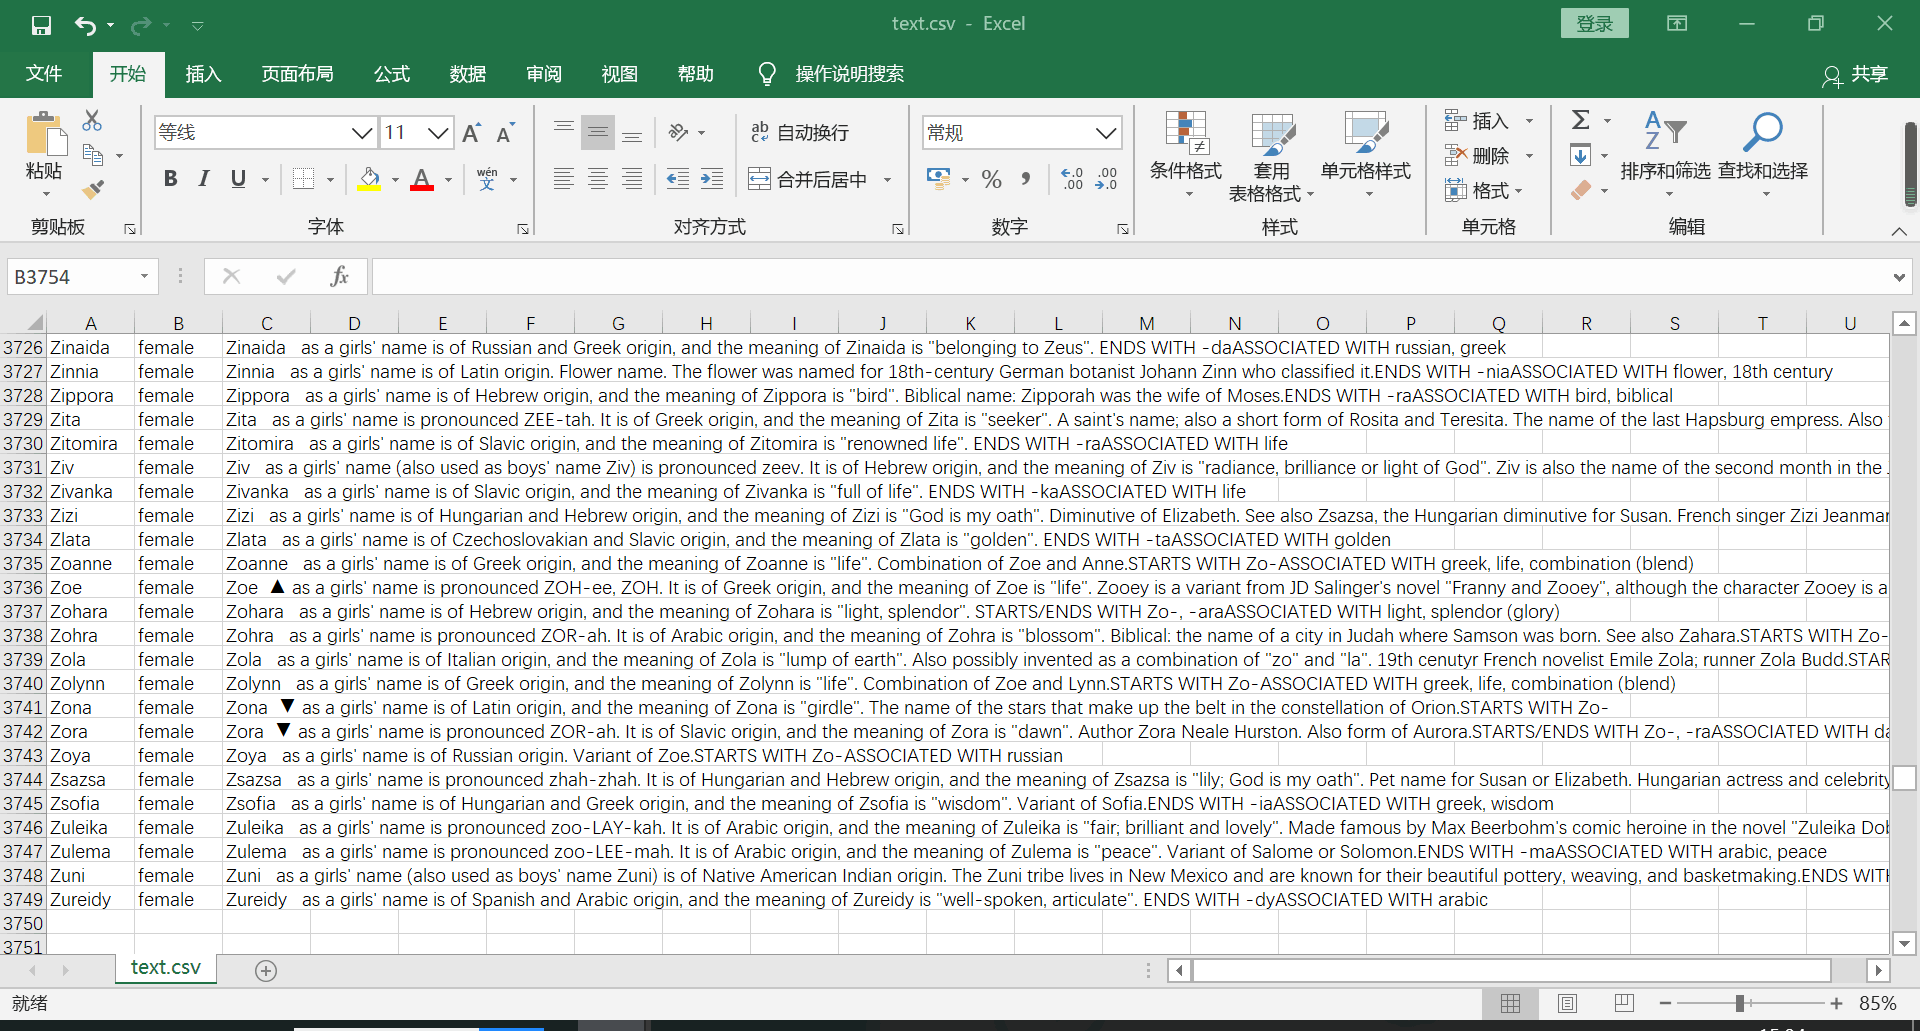
三、遇到的问题及解决方案
(1)爬取到所有名字时不能获得文本内容
解决方案:选择合适的正则表达式
docx=requests.get(url)

    soup=BeautifulSoup(docx.content,'html.parser')

    c_txt1=soup.find('section',{'id':'index'}).findAll('b')

    for x in c_txt1:

        s=[]

        if x.find('a'):

            name=x.find('a')['href'].split("/")[-1]#使用正则表达式获得所有名字
(2)获取名字详情页内容时,名字和性别在一起。
解决方案:使用切片语法分别获得名字和姓名分开存取
li=bs.find('div',class_='content').find('h1')

            Enname=li.text[8::1]#使用切片语法获得详情页名字(s[x:y:z]x为起始,y为终止,z为步长)

            Gender=li.text[1:8:1]#使用切片语法获得详情页名字性别
(3)在笔记本上运行时,访问量大
解决方案:分开来爬
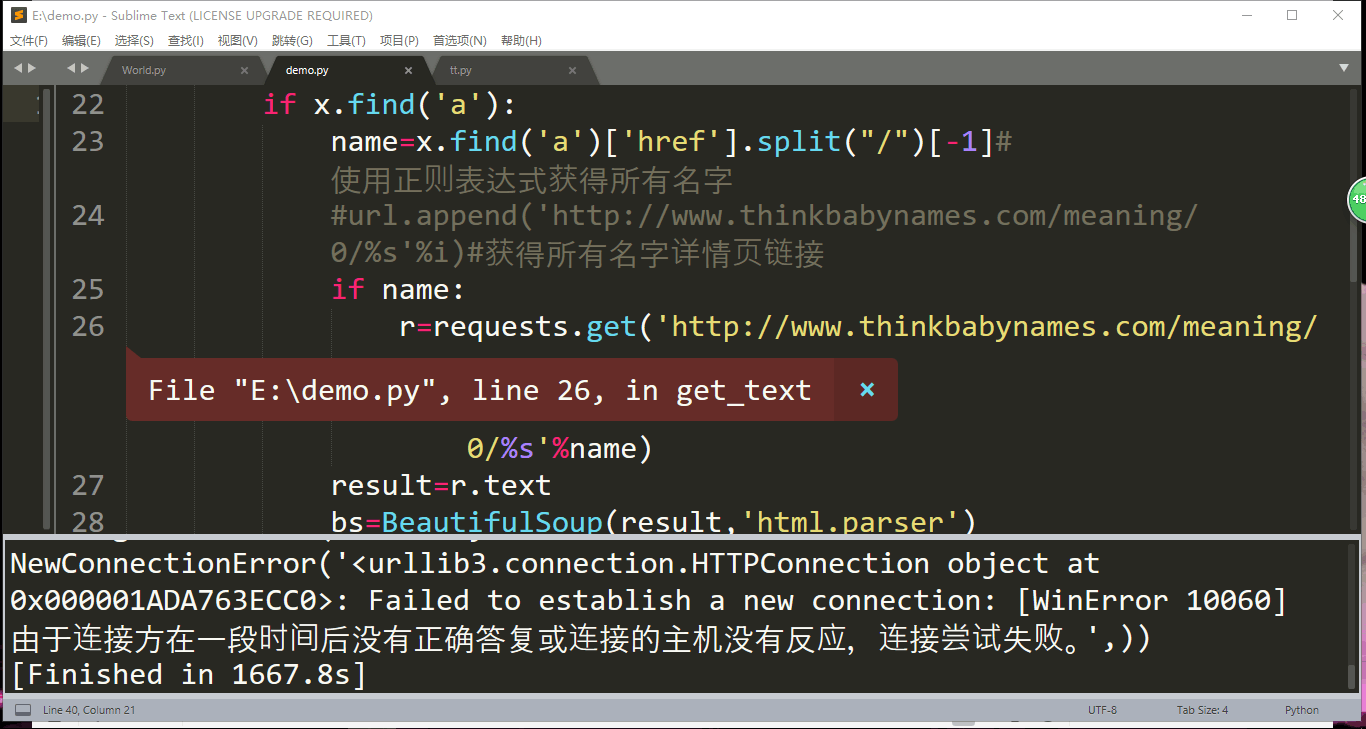
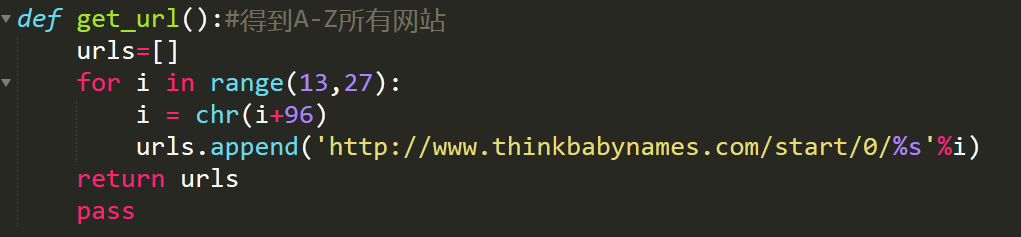
如上图,改变range()函数中的数字来选择爬取部分网站以减少访问量。
这样既能够满足爬取要求,也不会被网站禁止爬取。
python大作业二的更多相关文章
- python大作业
爬取西刺代理 生成请求头 #encoding = utf-8; __all__ = ("Header"); import random; class Header(object): ...
- python大作业-图书管理系统
#缺少循环执行和错误处理 #add()函数 添加了循环执行 #错误处理:regist()函数 登录和退出选择的时候添加了错误处理 import sys import importlib importl ...
- 数据库大作业--由python+flask
这个是项目一来是数据库大作业,另一方面也算是再对falsk和python熟悉下,好久不用会忘很快. 界面相比上一个项目好看很多,不过因为时间紧加上只有我一个人写,所以有很多地方逻辑写的比较繁琐,如果是 ...
- Python学习之编写三级菜单(Day1,作业二)
作业二:多级菜单 三级菜单 可依次进入各子菜单 在各级菜单中输入B返回上一级Q退出程序 知识点:字典的操作,while循环,for循环,if判断 思路: 1.开始,打印一级菜单让用户进行选择(可以输入 ...
- c++小学期大作业攻略(二)整体思路+主界面
写在前面:如果我曾经说过要在第一周之内写完大作业,那……肯定是你听错了.不过如果我在写的时候有攻略看的话应该可以轻松地在4~5天内做完,然后觉得写攻略的人是个小天使吧(疯狂暗示).出于给大家自由发挥的 ...
- 【大数据应用技术】作业十二|Hadoop综合大作业
本次作业的要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 前言 本次作业是在<爬虫大作业>的基础上进行的 ...
- 爬虫综合大作业——网易云音乐爬虫 & 数据可视化分析
作业要求来自于https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3075 爬虫综合大作业 选择一个热点或者你感兴趣的主题. 选择爬取的对象 ...
- 程设大作业xjb写——魔方复原
鸽了那么久总算期中过[爆]去[炸]了...该是时候写写大作业了 [总不能丢给他们不会写的来做吧 一.三阶魔方的几个基本定义 ↑就像这样,可以定义面的称呼:上U下D左L右R前F后B UD之间的叫E,LR ...
- Python 数据分析(二 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识
Python 数据分析(二) 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识 第1节 groupby 技术 第2节 数据聚合 第3节 分组级运算和转换 第4 ...
随机推荐
- Asp.net Core dotnet 发布类库文件 带上注释,发布预发行版,带上所有引用
带上注释 效果图 带上所有引用 效果图 预发行版 效果图 由于微软取消了 project.json 这个json 转而用了csproj 用于保存配置 所以懵逼很大一会 资料来源 project.j ...
- 笔记||Python3之异常处理
异常概念:1 - 代码执行产生错误,无法继续 2 - 在异常前面代码是可以执行的 ---python是解释型的 3 - 异常作用 --- 程序不要退出 - 可以继续执行 同时给予程序员一定的异常提 ...
- Java题整
Java面试题整 http://www.cnblogs.com/remember-forget/p/6140166.html 上:http://blog.csdn.net/jackfrued/arti ...
- Docker swarm实战总结
一.简介 Swarm 是 Docker 官方提供的一款集群管理工具,其主要作用是把若干台 Docker 主机抽象为一个整体,并且通过一个入口统一管理这些 Docker 主机上的各种 Docker 资源 ...
- Vue ---- vue的基本使用 文本/事件/属性指令 补充: js面向对象 js函数
目录 日考题(知识点)
- ubuntu19_nginx_uwsgi_flask_apt安装
ubuntu19_nginx_uwsgi_flask_apt安装 转载注明来源: 本文链接 来自osnosn的博客,写于 2019-12-21. 在 ubuntu 19.04 apt 安装 apt i ...
- Asp.Net MVC中记录错误日志保存到本地txt文件
为了方便查询系统出错弄个错误日志出来对于维护运维来说是很有必要的. 1.在Asp.Net MVC项目中的App_Start添加一个用于处理异常类的文件ErrorLog让他继承HandleErrorAt ...
- cuckoo沙箱技术分析全景图
从事信息安全技术行业的小伙伴们都知道沙箱技术(有些也称沙盒),用来判断一个程序或者文件是否是恶意的病毒.木马.漏洞攻击exp或其他恶意软件.其原理简单来说就是提供了一个虚拟的环境,把分析目标放到这个虚 ...
- Thread.Sleep线程休眠-小白向
try { Thread.sleep(); } catch (InterruptedException e) { } 首先这段代码的作用是使当前进程沉睡2S,展现给用户的结果就是画面维持两秒,有个“正 ...
- 【后端C#】后台通过http post 调用 webservice 的方法
定义http post 调用webservice的某个方法 /// <summary> /// http Post调用 WebService /// </summary> pu ...