
使用 Django 项目中的 ORM 编写伪造测试数据脚本
文中所涉及的示例代码,已同步更新到 HelloGitHub-Team 仓库
为了防止博客首页展示的文章过多以及提升加载速度,可以对文章列表进行分页展示。不过这需要比较多的文章才能达到分页效果,但本地开发时一般都只有几篇测试文章,如果一篇篇手工添加将会非常麻烦。
解决方案是我们可以写一个脚本,自动生成任意数量的测试数据。脚本写好后,只需运行脚本就可以往数据库填充大量测试数据。脚本就是一段普通的 Python 代码,非常简单,但是通过这个脚本你将学会如何在 django 外使用 ORM,而不仅仅在 django 应用的内部模块使用。
脚本目录结构
一般习惯于将项目有关的脚本统一放在项目根目录的 scripts 包中,当然这只是一个惯例,你也可以采用自己觉得合理的目录结构,只要保证这个包所在目录能够被 Python 找到。
依据惯例,我们博客项目中脚本的目录结构如下:
HelloDjango-blog-tutorial\

	blog\

	blogproject\

	...

	scripts\

		__init__.py

		fake.py

		md.sample
其中 fake.py 是生成测试数据的脚本,md.sample 是一个纯文本文件,内容是用于测试 Markdown 的文本。
使用 Faker 快速生成测试数据
博客文章包含丰富的内容元素,例如标题、正文、分类、标签。如果手工输入这些相关元素的文本会非常耗时,我们将借助一个 Python 的第三方库 Faker 来快速生成这些测试用的文本内容。Faker 意为造假工厂,顾名即可思义。
首先安装 Faker:
$ pipenv install Faker
Faker 通过不同的 Provider 来提供各种不同类型的假数据,我们将在下面的脚本中讲解它的部分用法,完整的用法可以参考其官方文档。
批量生成测试数据
现在我们来编写一段 Python 脚本用于自动生成博客测试数据。思路非常简单,博客内容包括作者、分类、标签、文章等元素,只需依次生成这些元素的内容即可。当然为了使脚本能够正常运行,很多细节需要注意,我们会对需要注意的地方进行详细讲解。
先来看脚本 fake.py 开头的内容:
import os

import pathlib

import random

import sys

from datetime import timedelta

import django

import faker

from django.utils import timezone

# 将项目根目录添加到 Python 的模块搜索路径中

back = os.path.dirname

BASE_DIR = back(back(os.path.abspath(__file__)))

sys.path.append(BASE_DIR)
这一段很简单,只是导入一些会用到的模块,然后通过脚本所在文件找到项目根目录,将根目录添加到 Python 的模块搜索路径中,这样在运行脚本时 Python 才能够找到相应的模块并执行。
接下来是脚本的逻辑,先看第一段:
if __name__ == '__main__':

    os.environ.setdefault("DJANGO_SETTINGS_MODULE", "blogproject.settings.local")

    django.setup()

    from blog.models import Category, Post, Tag

    from comments.models import Comment

    from django.contrib.auth.models import User
这是整个脚本最为重要的部分。首先设置 DJANGO_SETTINGS_MODULE 环境变量,这将指定 django 启动时使用的配置文件,然后运行 django.setup() 启动 django。这是关键步骤,只有在 django 启动后,我们才能使用 django 的 ORM 系统。django 启动后,就可以导入各个模型,以便创建数据。
接下来的逻辑就很简单了,不断生成所需的测试数据即可,我们来一段一段地看:
    print('clean database')

    Post.objects.all().delete()

    Category.objects.all().delete()

    Tag.objects.all().delete()

    Comment.objects.all().delete()

    User.objects.all().delete()
这一段脚本用于清除旧数据,因此每次运行脚本,都会清除原有数据,然后重新生成。
    print('create a blog user')

    user = User.objects.create_superuser('admin', 'admin@hellogithub.com', 'admin')

    category_list = ['Python学习笔记', '开源项目', '工具资源', '程序员生活感悟', 'test category']

    tag_list = ['django', 'Python', 'Pipenv', 'Docker', 'Nginx', 'Elasticsearch', 'Gunicorn', 'Supervisor', 'test tag']

    a_year_ago = timezone.now() - timedelta(days=365)

    print('create categories and tags')

    for cate in category_list:

        Category.objects.create(name=cate)

    for tag in tag_list:

        Tag.objects.create(name=tag)

    print('create a markdown sample post')

    Post.objects.create(

        title='Markdown 与代码高亮测试',

        body=pathlib.Path(BASE_DIR).joinpath('scripts', 'md.sample').read_text(encoding='utf-8'),

        category=Category.objects.create(name='Markdown测试'),

        author=user,

    )
这个脚本没什么说的,简单地使用 django 的 ORM API 生成博客用户、分类、标签以及一篇 Markdown 测试文章。
    print('create some faked posts published within the past year')

    fake = faker.Faker()  # English

    for _ in range(100):

        tags = Tag.objects.order_by('?')

        tag1 = tags.first()

        tag2 = tags.last()

        cate = Category.objects.order_by('?').first()

        created_time = fake.date_time_between(start_date='-1y', end_date="now",

                                              tzinfo=timezone.get_current_timezone())

        post = Post.objects.create(

            title=fake.sentence().rstrip('.'),

            body='\n\n'.join(fake.paragraphs(10)),

            created_time=created_time,

            category=cate,

            author=user,

        )

        post.tags.add(tag1, tag2)

        post.save()
这段脚本用于生成 100 篇英文博客文章。博客文章通常内容比较长,因此我们使用了之前提及的 Faker 库来自动生成文本内容。脚本逻辑很清晰,只对其中涉及的几个知识点进行讲解:
fake = faker.Faker(),要使用 Faker 自动生成数据,首先实例化一个Faker对象,然后我们可以在脚本中使用这个实例的一些方法生成需要的数据。Faker 默认生成英文数据,但也支持国际化。至于如何生成中文数据在下一段脚本中会看到。order_by('?')将返回随机排序的结果,脚本中这块代码的作用是达到随机选择标签(Tag) 和分类(Category) 的效果。然后就是 2 个 Faker 的 API 了:
fake.date_time_between这个方法将返回 2 个指定日期间的随机日期。三个参数分别是起始日期,终止日期和时区。我们在这里设置起始日期为 1 年前(-1y),终止日期为当下(now),时区为
get_current_timezone返回的时区,这个函数是django.utils.timezone模块的辅助函数,它会根据 django 设置文件中TIME_ZONE的值返回对应的时区对象。'\n\n'.join(fake.paragraphs(10))fake.paragraphs(10)用于生成 10 个段落文本,以列表形式返回,列表的每个元素即为一个段落。要注意使用 2 个换行符连起来是为了符合 Markdown 语法,Markdown 中只有 2 个换行符分隔的文本才会被解析为段落。
    fake = faker.Faker('zh_CN')

    for _ in range(100):  # Chinese

        tags = Tag.objects.order_by('?')

        tag1 = tags.first()

        tag2 = tags.last()

        cate = Category.objects.order_by('?').first()

        created_time = fake.date_time_between(start_date='-1y', end_date="now",

                                              tzinfo=timezone.get_current_timezone())

        post = Post.objects.create(

            title=fake.sentence().rstrip('.'),

            body='\n\n'.join(fake.paragraphs(10)),

            created_time=created_time,

            category=cate,

            author=user,

        )

        post.tags.add(tag1, tag2)

        post.save()
这一段脚本和上一段几乎完全一样,唯一不同的是构造 Faker 实例时,传入了一个语言代码 zh_CN,这将生成中文的虚拟数据,而不是默认的英文。
    print('create some comments')

    for post in Post.objects.all()[:20]:

        post_created_time = post.created_time

        delta_in_days = '-' + str((timezone.now() - post_created_time).days) + 'd'

        for _ in range(random.randrange(3, 15)):

            Comment.objects.create(

                name=fake.name(),

                email=fake.email(),

                url=fake.uri(),

                text=fake.paragraph(),

                created_time=fake.date_time_between(

                     start_date=delta_in_days,

                     end_date="now",

                     tzinfo=timezone.get_current_timezone()),

                post=post,

            )

    print('done!')
最后依葫芦画瓢,给前 20 篇文章(Post) 生成评论数据。要注意的是评论的发布时间必须位于被评论文章的发布时间和当前时间之间,这就是 delta_in_days = '-' + str((timezone.now() - post_created_time).days) + 'd' 这句代码的作用。
执行脚本
脚本写好了,在项目根目录执行下面的命令运行整个脚本:
$ pipenv run python -m scripts.fake
看到如下的输出说明脚本执行成功了。
clean database

create a blog user

create categories and tags

create a markdown sample post

create some faked posts published within the past year

create some comments

done!
运行开发服务器,访问博客首页可以看到生成的测试数据,是不是有点以假乱真的感觉?
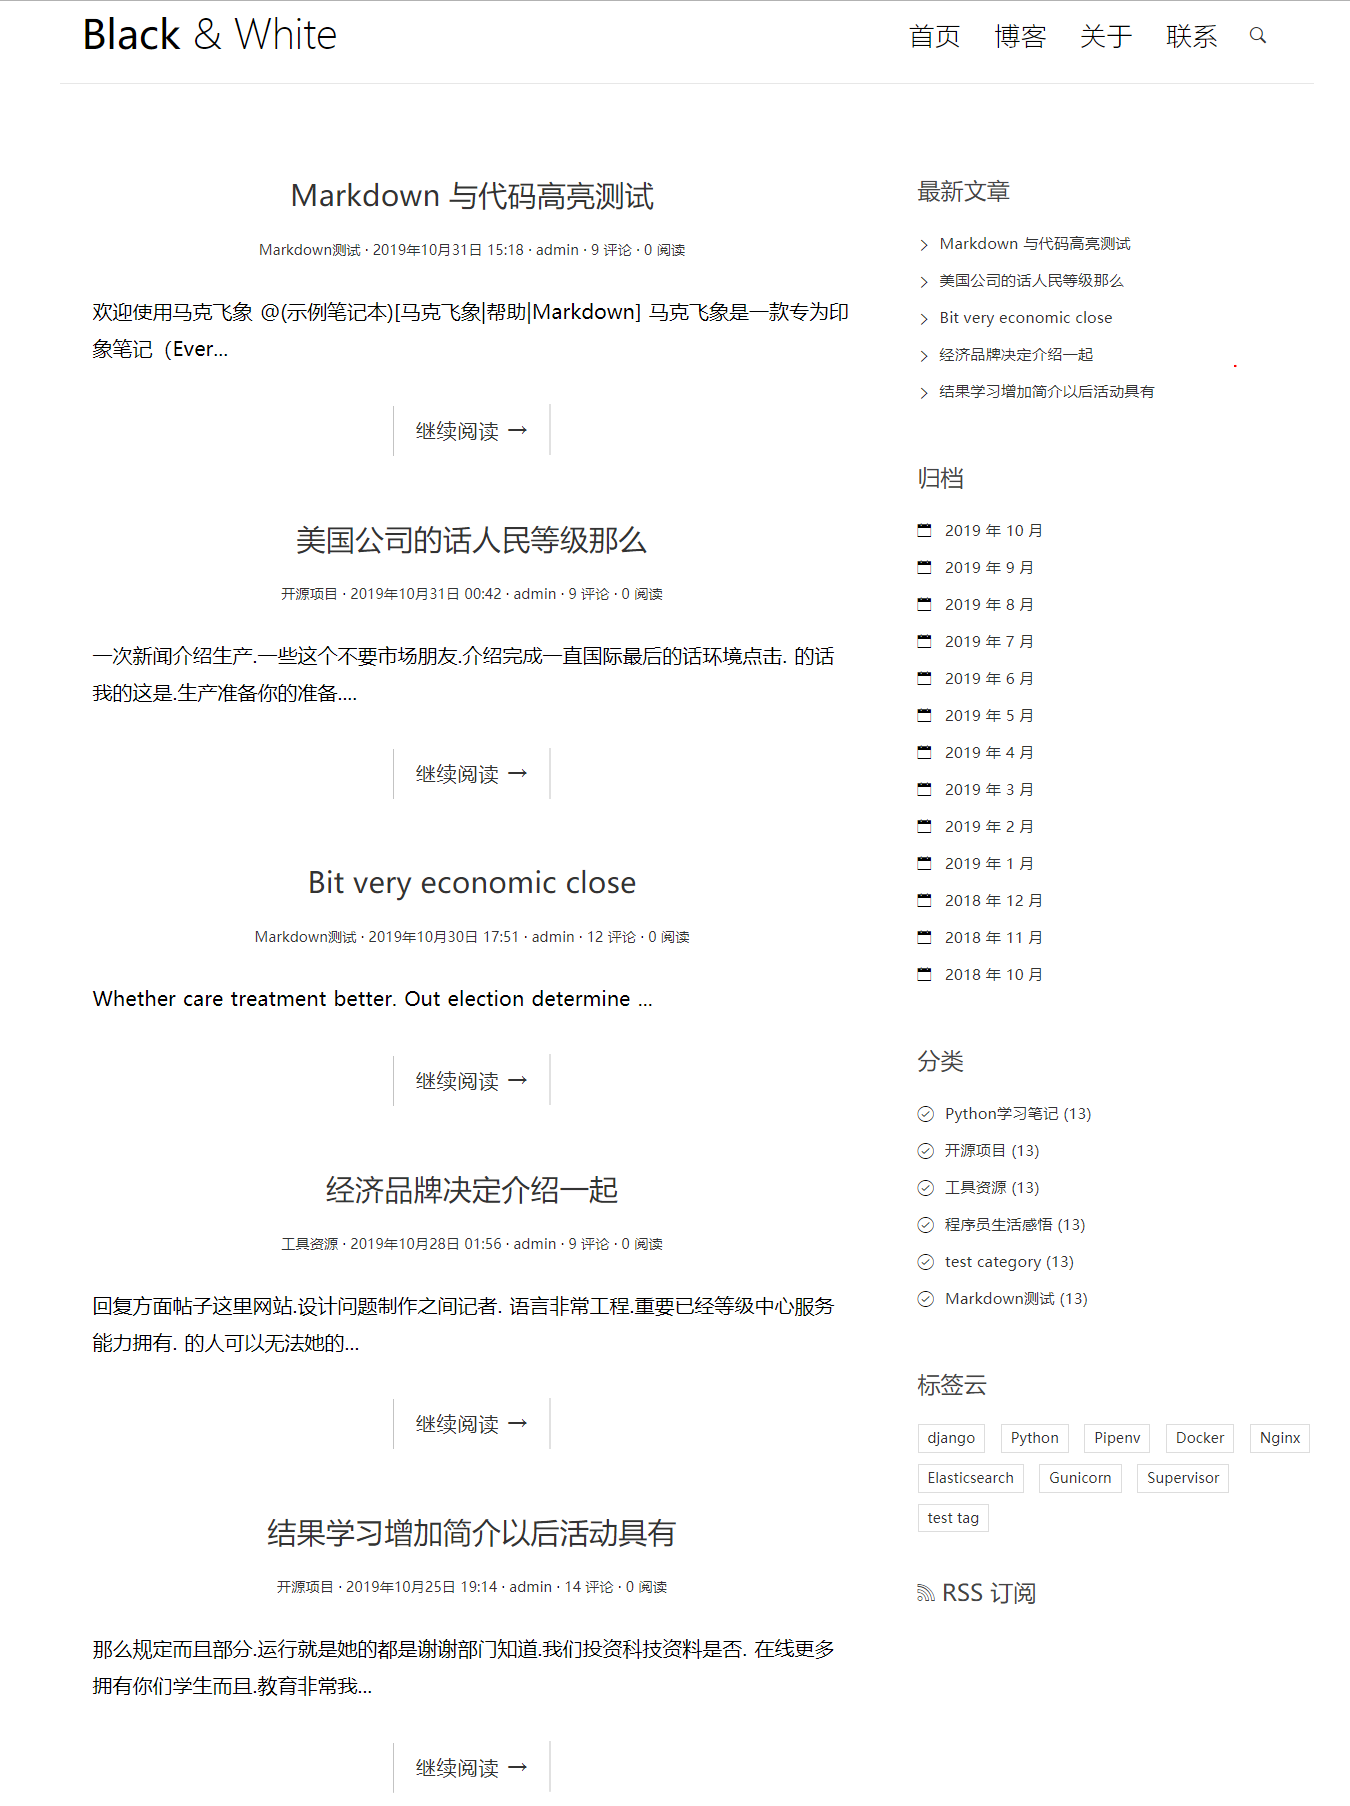
现在,我们有了 200 多篇测试文章,用来测试分页效果就十分简单了,接下来让我们来实现功能完整的分页效果。
『讲解开源项目系列』——让对开源项目感兴趣的人不再畏惧、让开源项目的发起者不再孤单。跟着我们的文章,你会发现编程的乐趣、使用和发现参与开源项目如此简单。欢迎留言联系我们、加入我们,让更多人爱上开源、贡献开源~
使用 Django 项目中的 ORM 编写伪造测试数据脚本的更多相关文章
- django项目创建启动 ORM操作
. HTTP协议消息的格式: . 请求(request) 请求方法 路径 HTTP/1.1\r\n k1:v1\r\n ...\r\n \r\n 请求体 <-- 可以有,可以没有 . 响应(re ...
- Django项目中"expected str, bytes or os.PathLike object, not list"错误解决:
对于这个错误,也在于自己对django基础的掌握不是很牢固,忽略了MEDIA_ROOT的类型是string,而不是list. 错误的写法: MEDIA_ROOT = [ os.path.join(BA ...
- celery 分布式异步任务框架(celery简单使用、celery多任务结构、celery定时任务、celery计划任务、celery在Django项目中使用Python脚本调用Django环境)
一.celery简介: Celery 是一个强大的 分布式任务队列 的 异步处理框架,它可以让任务的执行完全脱离主程序,甚至可以被分配到其他主机上运行.我们通常使用它来实现异步任务(async tas ...
- [翻译]在Django项目中添加谷歌统计(Google Analytics)
原文:<Google Analytics tracking code into Django projects, the easy way> 对我来说,制作一个可扩展的Django应用随时 ...
- Django项目中使用Redis
Django项目中使用Redis DjangoRedis 1 redis Redis 是一个 key-value 存储系统,常用于缓存的存储.django-redis 基于 BSD 许可, 是一个使 ...
- 擦他丫的,今天在Django项目中引用静态文件jQuery.js 就是引入报错,终于找到原因了!
擦 ,今天在Django项目中引用静态文件jQuery.js 就是引入报错,终于找到原因了! 问题在于我使用的谷歌浏览器,默认使用了缓存,导致每次访问同一个url时,都返回的是缓存里面的东西.通过谷歌 ...
- django 项目中使用多数据库 multiple databases
假如在一个django项目中使用到了不只一个数据库, 其实这在大一点的工程中很常见,比如主从库 那么会涉及到如下一些东西 1, 定义 在settings中的DATABASE中定义会使用到的数据,比如除 ...
- django 项目中的 favicon.ico 处理
django 项目中的 favicon.ico 处理 (django == 2.0.6) 1. 引入模块: from django.views.generic.base import Redirec ...
- Django项目中模板标签及模板的继承与引用【网站中快速布置广告】
Django项目中模板标签及模板的继承与引用 常见模板标签 {% static %} {% for x in range(x) %}{% endfor %} 循环的序号{% forloop %} 循环 ...
随机推荐
- elastic集群单节点停机维护
为了elastic时时提供服务,需要elastic至少状态维持在yellow状态.所有,维护时需要依次对elastic单个节点进行维护. 操作步骤如下: 1.停止elastic的自动分配功能 curl ...
- 报错:ORA-25150:不允许对区参数执行ALERING
alter table 表名 MOVE storage ( next 128 ) ; -- Add/modify columns alter table 表名 add 列名 var ...
- 一行命令安装docker和docker-compose(CentOS7)
想快速装好docker和docker-compose ?那就随本文用一次复制粘贴来完成安装: 环境信息 操作系统:CentOS Linux release 7.7.1908 (Core, 操作账号:r ...
- @Data注解getset不起作用
在idea的setting安装Lombok插件,重启idea
- Angular Cli 升级到最新版本
1. 卸载当前版本 npm uninstall -g angular-cli 2. 清除未卸载干净的angular-cli缓存 npm cache clean -f 3. 到安装目录查看是否卸载干净 ...
- Java源码解析|String源码与常用方法
String源码与常用方法 1.栗子 代码: public class JavaStringClass { public static void main(String[] args) { Strin ...
- 滴滴热力图-php版(后面有js版本)
) * ) ) * ) {) * *pi() / ) * ]) % ) {//在多边形外return false;} else { //在多边形内return true;} }
- 写了那么多年 Java 代码,终于 debug 到 JVM 了
继上篇文章 原创 | 全网最新最简单的 openjdk13 代码编译 之后,我们有了自己编译后的 jdk 和 hotspot,如下图所示.接下来就来干一番事情. 搭建调试环境 1.下载 CLion 软 ...
- 294 div2 C. A and B and Team Training
C. A and B and Team Training 题目:A and B are preparing themselves for programming contests. An import ...
- python编程基础之三十
时间模块: 时间戳:就是当前是键距离1970年1月1日0:0:0的秒数,后面还带小数,可以说是非常精确 时间的表示形式: a.以整数或者浮点数表示一个以秒为单位的时间间隔,这个时间的基础值1970.1 ...