
11. Scala数据结构(下)-集合操作
11.1 集合元素的映射-map映射操作
11.1.1 看一个实际需求
要求:请将List(3,5,8)中所有的元素都*2,将其结果放到一个新的集合中返回,即返回一个新的List(6,10,16),请编写程序实现
11.1.2 map映射操作
11.1.3 使用传统方法
-案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    /*

    请将List(3,5,8) 中的所有元素都 * 2 ,

    将其结果放到一个新的集合中返回,即返回一个新的List(6,10,16), 请编写程序实现.

     */

    val list1 = List(3, 5, 8) //集合

    var list2 = List[Int]() //新的集合,准备放入新的内容

    for (item <- list1) { //遍历

      list2 = list2 :+ item * 2 // 对元素*2 ,然后加入list2集合

    }

    println("list2=" + list2) //List(6,10,16)

  }

}
-上述案例演示的分析和小结
1) 优点
处理方法比较直接,好理解
2) 缺点
不够简洁高效
没有体现函数式编程特点 集合 => 函数 => 新的集合 => 函数 ...
不利于处理复杂的数据处理业务
11.1.4 高阶函数基本使用案例1
-案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    //使用高阶函数

    val res = test(sum2 _, 3.5)

    println("res=" + res)

    //在scala中,可以把一个函数直接赋给一个变量,但是不执行函数

    val f1 = myPrint _

    f1() //执行

  }

  def myPrint(): Unit = {

    println("hello,world!")

  }

  //说明

  //1. test就是一个高阶函数

  //2. f: Double => Double 表示一个函数, 该函数可以接受一个Double,返回Double

  //3. n1: Double 普通参数

  //4. f(n1) 在test函数中,执行 你传入的函数

  def test(f: Double => Double, n1: Double) = {

    f(n1)

  }

  //普通的函数, 可以接受一个Double,返回Double

  def sum2(d: Double): Double = {

    println("sum2被调用")

    d + d

  }

}
11.1.5 高阶函数应用案例2
-案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    test2(sayOK)

  }

  //说明test2是一个高阶函数,可以接受一个 没有输入,返回为Unit的函数

  def test2(f: () => Unit) = {

    f()

  }

  def sayOK() = {

    println("sayOKKK...")

  }

  def sub(n1: Int): Unit = {

  }

}
11.1.6 使用map映射函数来解决
//请将 List(3,5,8) 中的所有元素都 * 2 , 将其结果放到一个新的集合中返回,即返回一个新的 List(6,10,16), 请编写程序实现.

  val list = List(3, 5, 8)

  //说明 list.map(multiple) 做了什么

  //1. 将 list 这个集合的元素 依次遍历

  //2. 将各个元素传递给 multiple 函数 => 新 Int

  //3. 将得到新 Int ,放入到一个新的集合并返回

  //4. 因此 multiple 函数调用 3

  val list2 = list.map(multiple)

  println("list2=" + list2) //List(6,10,16)

  def multiple(n: Int): Int = {

    println("multiple 被调用~~")

    2 * n

  }
11.1.7 深刻理解map映射函数的机制-模拟实现
//深刻理解 map 映射函数的机制-模拟实现

  class MyList {

    val list1 = List(3, 5, 8, 9) //新的集合

    var list2 = List[Int]()

    //写 map

    def map(f: Int => Int): List[Int] = {

      //遍历集合

      for (item <- this.list1) {

        //过滤,扁平化。。。

        list2 = list2 :+ f(item)

      }

      list2

    }

  }

  object MyList {

    def apply(): MyList = new MyList()

  }
11.1.9 flatmap映射: flat即压扁,压平,扁平化映射
-扁平化说明
flatmap:flat即压扁,压平,扁平化,效果就是将集合中的每个元素的子元素映射到某个函数并返回新的集合
-案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val names = List("Alice", "Tom", "Nick")

    //需求是将List集合中的所有元素,进行扁平化操作,即把所有元素打散

    val names2 = names.flatMap(upper)

    println("names2=" + names2)

  }

  def upper(s: String): String = {

    s.toUpperCase

  }

}
11.2 集合元素的过滤-filter
-基本说明
filter:将符合要求的数据(筛选)放置到新的集合中
-案例演示
应用案例:将 val names = List("Alice","Tom","Nick") 集合中首字母为'A'的筛选到新的集合
思考:如果这个使用传统的方法,如何完成?
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    /*

    选出首字母为A的元素

     */

    val names = List("Alice", "Tom", "Nick")

    val names2 = names.filter(startA)

    println("names=" + names)

    println("names2=" + names2)

  }

  def startA(str: String): Boolean = {

    str.startsWith("A")

  }

}
11.3 化简
11.3.1 看一个需求
val list = List(1,20,30,4,5),求出list的和
11.3.2 化简的介绍:
化简:将二元函数引用于集合中的函数
上面的问题当然可以使用遍历list方法来解决,这里使用scala的简化方式来完成
11.3.3 案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    /*

    使用化简的方式来计算list集合的和

     */

    val list = List(1, 20, 30, 4, 5)

    val res = list.reduceLeft(sum) //接收一个函数时,也可以直接传入一个匿名函数

    //执行的流程分析

    //步骤 1 (1 + 20)

    //步骤 2 (1 + 20) + 30

    //步骤 3 ((1 + 20) + 30) + 4

    //步骤 4 (((1 + 20) + 30) + 4) + 5 = 60

    println("res=" + res) // 60

  }

  def sum(n1: Int, n2: Int): Int = {

    println("sum被调用~~")

    n1 + n2

  }

}
11.3.4 对reduceLeft的运行机制的说明
1) def reduceLeft[B >: A](@deprecatedName('f) op: (B,A) => B): B
2) reduceLeft(f) 接收的函数需要的形式为 op: (B,A) => B): B
3) reduceLeft(f) 的运行规则是 从左边开始执行将得到的结果返回给第一个参数
4) 然后继续和下一个元素运行,将得到的结果继续返回给第一个参数,继续...
即: //((((1+2)+3)+4)+5) = 15
11.4 折叠
11.4.1 基本介绍
-fold函数将上一步返回的值作为函数的第一参数继续传递参与运算,直到list中的所有元素被遍历
-可以把reduceLeft看做简化版的foldLeft
如何理解:
  def reduceLeft[B >: A](@deprecatedName('f) op: (B, A) => B): B =

    if (isEmpty) throw new UnsupportedOperationException("empty.reduceLeft")

    else tail.foldLeft[B](head)(op)

  //可以看到. reduceLeft 就是调用的 foldLeft[B](head),并且是默认从集合的 head 元素开始操作的。
-相关函数:fold,foldLeft,foldRight,可以参考reduce的相关方法理解
11.4.2 应用案例
看下面代码看看输出什么,并分析原因
案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val list = List(1, 2, 3, 4)

    def minus(num1: Int, num2: Int): Int = {

      num1 - num2

    }

    //说明

    //1. 折叠的理解和化简的运行机制几乎一样.

    //理解 list.foldLeft(5)(minus) 理解成 list(5,1, 2, 3, 4) list.reduceLeft(minus)

    //步骤  (5-1)

    //步骤  ((5-1) - 2)

    //步骤  (((5-1) - 2) - 3)

    //步骤  ((((5-1) - 2) - 3)) - 4 = - 5

    println(list.foldLeft(5)(minus)) // 函数的柯里化

    ////理解 list.foldRight(5)(minus) 理解成 list(1, 2, 3, 4, 5) list.reduceRight(minus)

    // 步骤 (4 - 5)

    // 步骤 (3- (4 - 5))

    // 步骤 (2 -(3- (4 - 5)))

    // 步骤 1- (2 -(3- (4 - 5))) = 3

    println(list.foldRight(5)(minus)) //

  }

}
11.4.3 foldLeft和foldRight缩写方法分别是:/:和:\
-案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val list4 = List(1, 9)

    def minus(num1: Int, num2: Int): Int = {

      num1 - num2

    }

    var i6 = (1 /: list4) (minus) // =等价=> list4.foldLeft(1)(minus)

    println("i6=" + i6)

    i6 = (100 /: list4) (minus) //=等价=> list4.foldLeft(100)(minus)

    println(i6) // 输出?

    i6 = (list4 :\ 10) (minus) // list4.foldRight(10)(minus)

    println(i6) // 输出? 2

  }

}
11.5 扫描
11.5.1 基本介绍
扫描,即对某个集合的所有元素做fold操作,但是会把产生的所有中间结果放置于一个集合中保存
11.5.2 应用案例
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    //普通函数

    def minus( num1 : Int, num2 : Int ) : Int = {

      num1 - num2

    }

    //5 (1,2,3,4,5) =>(5, 4, 2, -1, -5, -10) //Vector(5, 4, 2, -1, -5, -10)

    val i8 = (1 to 5).scanLeft(5)(minus) //IndexedSeq[Int]

    println("i8=" + i8)

    //普通函数

    def add( num1 : Int, num2 : Int ) : Int = {

      num1 + num2

    }

    //(1,2,3,4,5) 5 => (20,19,17,14, 10,5)

    val i9 = (1 to 5).scanRight(5)(add) //IndexedSeq[Int]

    println("i9=" + i9)

  }

}
11.7 扩展-拉链(合并)
11.7.1 基本介绍
在开发中,当我们需要将两个集合进行 对偶元组合并,可以使用拉链
11.7.2 应用案例
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    // 拉链

    val list1 = List(1, 2, 3)

    val list2 = List(4, 5, 6)

    val list3 = list1.zip(list2) // (1,4),(2,5),(3,6)

    println("list3=" + list3)

  }

}
11.7.3 拉链的使用注意事项
1) 拉链的本质就是两个集合的合并操作,合并后每个元素是一个 对偶元组
2) 操作的规则如下图
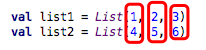
3) 如果两个集合个数不对应,会造成数据丢失
4) 集合不限于List,也可以是其它集合,比如:Array
5) 如果要取出合并后的各个对偶元组的数据,可以遍历
    for(item<-list3) {

      print(item._1 + " " + item._2) //取出时,按照元组的方式取出即可

    }
11.8 扩展-迭代器
11.8.1 基本说明
通过iterator方法从集合获得一个迭代器,通过while循环和for表达式对集合进行遍历(学习使用迭代器来遍历)
11.8.2 应用案例
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val iterator = List(1, 2, 3, 4, 5).iterator // 得到迭代器

    /*

    这里我们看看iterator 的继承关系

     def iterator: Iterator[A] = new AbstractIterator[A] {

    var these = self

    def hasNext: Boolean = !these.isEmpty

    def next(): A =

      if (hasNext) {

        val result = these.head; these = these.tail; result

      } else Iterator.empty.next()

     */

    println("--------遍历方式1 while -----------------")

    while (iterator.hasNext) {

      println(iterator.next())

    }

    println("--------遍历方式2 for -----------------")

    for (enum <- iterator) {

      println(enum) //

    }

  }

}
11.8.3 对案例演示的小结
1) iterator的构建实际是AbstractIterator的一个匿名子类,该子类提供了
    def iterator: Iterator[A] = new AbstractIterator[A] {

      var these = self

      def hasNext: Boolean = !these.isEmpty

      def next(): A =

        if (hasNext) {

          val result = these.head;

          these = these.tail;

          result

        } else Iterator.empty.next()

    }
2) 该AbstractIterator子类提供了hasNext,next等方法
3) 因此,我们可以使用while的方式,使用hasNext,next方法变量
11.9 扩展-流Stream
11.9.1 基本说明
stream是一个集合。这个集合,可以用于存放无穷多个元素,但是这无穷个元素并不会一次性生产出来,而是需要用到多大的区间,就会动态的生产,末尾元素遵循lazy规则(即:要使用结果才进行计算)
11.9.2 创建Stream对象
-案例
  def numsForm(n: BigInt): Stream[BigInt] = n #:: numsForm(n + 1)

  val stream1 = numsForm(1)
-说明
1) Stream集合存放的数据类型是BigInt
2) numsForm是自定义的一个函数,函数名是程序员指定的
3) 创建的集合的第一个元素是n,后续元素生成的规则是n+1
4) 后续元素生成的规则是可以程序员指定的
11.9.3 流的应用案例
  //创建 Stream

  def numsForm(n: BigInt) : Stream[BigInt] = n #:: numsForm(n + 1)

  val stream1 = numsForm(1)

  println(stream1) //

  //取出第一个元素

  println("head=" + stream1.head) //

  println(stream1.tail) // 当对流执行 tail 操作时,就会生成一个新的数据.

  println(stream1) //
11.10 扩展-视图View
11.10.1 基本介绍
Stream的懒加载特性,也可以对其他集合应用view方法来得到类似的效果,具体有如下特点
1) view方法产出一个总是被懒执行的集合
2) view不会缓存数据,每次都要重新计算,比如遍历View时
11.10.2 应用案例
请找到1-100中,数字倒叙排列和它本身相同的所有数
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    def multiple(num: Int): Int = {

      num

    }

    //如果这个数,逆序后和原来数相等,就返回true,否则返回false

    def eq(i: Int): Boolean = {

      println("eq 被调用..")

      i.toString.equals(i.toString.reverse)

    }

    //说明: 没有使用view,常规方式

    val viewSquares1 = (1 to 100).filter(eq)

    println(viewSquares1)

    //使用view,来完成这个问题,程序中,对集合进行map,filter,reduce,fold...

    //你并不希望立即执行,而是在使用到结果才执行,则可以使用view来进行优化.

    val viewSquares2 = (1 to 100).view.filter(eq)

    println(viewSquares2)

    //遍历

    for (item <- viewSquares2) {

      println("item=" + item)

    }

  }

}
11.11扩展-并行集合
11.11.1基本介绍
1) Scala为了充分使用多核CPU,提供了并行集合(有别于前面的串行集合),用于多核环境的并行计算
2) 主要用到的算法有:
Divide and conquer: 分治算法,Scala通过splitters(分解器),combiners(组合器)等抽象层来实现,主要原理是将计算工作分解很多任务,分发给一些处理器去完成,并将它们处理结果合并返回
Work stealin算法,主要用于任务调度负载均衡(load-balancing),通俗点完成自己的所有任务之后,发现其他人还有活没干完,主动(或被安排)帮他人一起干,这样达到尽早干完的目的
11.11.2 应用案例
-parallel(并行)
打印1~5
    (1 to 5).foreach(println(_))

    println()

    (1 to 5).par.foreach(println(_))
-查看并行集合中元素访问的线程
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val result1 = (0 to 100).map { case _ => Thread.currentThread.getName }.distinct

    val result2 = (0 to 100).par.map { case _ => Thread.currentThread.getName }.distinct

    println(result1) //非并行

    println("--------------------------------------------")

    println(result2) //并行

  }

}
11.12 扩展-操作符
11.12.1 基本介绍
这部分内容没有必要刻意去记忆,语法使用的多了,自然就会熟练的使用,该部分内容了解就可以
11.12.2 操作符扩展
1) 如果想在变量名、类名等定义中使用语法关键字(保留字),可以配合反引号反引号,比如 val `val` = 23
2) 中置操作符:A操作符B 等同于 A.操作符(B)
3) 后置操作符:A操作符 等同于 A.操作符,如果操作符定义的时候不带()则调用时不能加括号
4) 前置操作符:+、-、!、~等操作符A 等同于 A.unary_操作符
5) 赋值操作符:A操作符=B 等同于 A=A 操作符B,比如A +=B 等价 A = A + B
6) 案例演示
object boke_demo01 {

  def main(args: Array[String]): Unit = {

    val n1 = 1

    val n2 = 2

    val r1 = n1 + n2 // 3

    val r2 = n1.+(n2) // 3 看Int的源码即可说明

    val monster = new Monster

    monster + 10

    monster.+(10)

    println("monster.money=" + monster.money) // 20

    println(monster ++)

    println(monster.++)

    println("monster.money=" + monster.money) // 22

    !monster

    println("monster.money=" + monster.money) // -22

  }

}

class Monster {

  var money: Int = 0

  //对操作符进行重载 (中置操作符)

  def +(n: Int): Unit = {

    this.money += n

  }

  //对操作符进行重载(后置操作符)

  def ++(): Unit = {

    this.money += 1

  }

  //对操作符进行重载(前置操作符,一元运算符)

  def unary_!(): Unit = {

    this.money = -this.money

  }

}
11. Scala数据结构(下)-集合操作的更多相关文章
- 大数据技术之_16_Scala学习_08_数据结构(下)-集合操作+模式匹配
第十一章 数据结构(下)-集合操作11.1 集合元素的映射-map11.1.1 map 映射函数的操作11.1.2 高阶函数基本使用案例1+案例211.1.3 使用 map 映射函数来解决11.1.4 ...
- 10. Scala数据结构(上)-集合操作
10.1 数据结构特点 10.1.1 Scala集合基本介绍 uml => 统一建模语言 1) Scala同时支持不可变集合和可变集合,不可变集合可以安全的并发访问 两个主要的包 不可变集合:s ...
- 9、scala函数式编程-集合操作
一.集合操作1 1.Scala的集合体系结构 // Scala中的集合体系主要包括:Iterable.Seq.Set.Map.其中Iterable是所有集合trait的根trai.这个结构与Java的 ...
- Day04:集合框架(下) / 集合操作——线性表(一)
对象转型 向上转型: 什么是向上造型? 子类对象赋给父类引用 父类引用指向子类对象 父类类型 引用=子类对象; 子类转成父类 默认进行(父类引用指用子类对象). 为什么需要向上造型? 子类对象可 ...
- Scala集合操作
大数据技术是数据的集合以及对数据集合的操作技术的统称,具体来说: 1.数据集合:会涉及数据的搜集.存储等,搜集会有很多技术,存储技术现在比较经典方案是使用Hadoop,不过也很多方案采用Kafka. ...
- 小白学 Python(15):基础数据结构(集合)(下)
人生苦短,我选Python 前文传送门 小白学 Python(1):开篇 小白学 Python(2):基础数据类型(上) 小白学 Python(3):基础数据类型(下) 小白学 Python(4):变 ...
- Scala 运算符和集合转换操作示例
Scala是数据挖掘算法领域最有力的编程语言之一,语言本身是面向函数,这也符合了数据挖掘算法的常用场景:在原始数据集上应用一系列的变换,语言本身也对集合操作提供了众多强大的函数,本文将以List类型为 ...
- Scala学习教程笔记三之函数式编程、集合操作、模式匹配、类型参数、隐式转换、Actor、
1:Scala和Java的对比: 1.1:Scala中的函数是Java中完全没有的概念.因为Java是完全面向对象的编程语言,没有任何面向过程编程语言的特性,因此Java中的一等公民是类和对象,而且只 ...
- Scala实战高手****第6课 :零基础实战Scala集合操作及Spark源码解析
本课内容1.Spark中Scala集合操作鉴赏2.Scala集合操作实战 --------------------------------------------------------------- ...
随机推荐
- vue+element 获取验证码
我们在做一个项目,登录注册页面是少不了的,为了人机校验,验证码也是必须的 我的这个项目获取验证码,前端发送一个随机四位数给后端,后端返回一张图片,前端渲染就可以 template代码: <el- ...
- Fortify漏洞之Portability Flaw: File Separator 和 Poor Error Handling: Return Inside Finally
继续对Fortify的漏洞进行总结,本篇主要针对 Portability Flaw: File Separator 和 Poor Error Handling: Return Inside Fina ...
- 【Linux】yum 安装 JDK
一.查看java的所有版本 yum list java* 二.安装jdk8 yum install java--openjdk.x86_64 三.检查是否安装完成 java -version 四.默认 ...
- Nginx+lamp构建动静分离项目
一.nginx代理的概述 概述:nginx是一款自由的.开源的.高性能的HTTP服务器和反向代理服务器:同时也是一个IMAP.POP3.SMTP代理服务器:nginx可以作为一个内部网络代理上网的代理 ...
- 【servlet】Servlet快速入门&使用Eclipse发布web项目
创建时间:6.15 1.什么是Servlet Servlet 运行在服务端的Java小程序,是sun公司提供一套规范(接口),用来处理客户端请求.响应给浏览器的动态资源.但servlet的实质就是ja ...
- Jupyter Notebook 更换主题(背景、字体)
通过命令行窗口或 Anaconda Prompt 窗口 1.安装 Jupyter 主题 pip install jupyterthemes 2.更新 Jupyter 主题 (可选) pip insta ...
- Netty实战入门详解——让你彻底记住什么是Netty(看不懂你来找我)
一.Netty 简介 Netty 是基于 Java NIO 的异步事件驱动的网络应用框架,使用 Netty 可以快速开发网络应用,Netty 提供了高层次的抽象来简化 TCP 和 UDP 服务器的编程 ...
- WTL 9.0的变化 - atlctrls.h
atlctrls.h中是对控件的封装. 第1249行增加: void GetMargins(UINT& nLeft, UINT& nRight) const { ATLASSERT(: ...
- am instrument 命令详解运行多个用例
1 Instrument是什么? instrument为am命令的一个子命令.用于启动一个Instrumentation测试.首先连接手机或者模拟器,通过adb shell命令,进入shell层进行操 ...
- first-child、last-child误解
MDN解释兄弟元素中的第一个元素 然后今天写的时候这样想出现了问题 并没有加上边框 W3C解释 尝试去掉h3,发现span加上了边框 E:first-child含义 父元素中第一个元素且第一个元素是E ...