
Empirical Analysis of Beam Search Performance Degradation in Neural Sequence Models
Empirical Analysis of Beam Search Performance Degradation in Neural Sequence Models
2019-06-13 10:28:44
Paper: [abs] [Download PDF][Supplementary PDF] Eldan Cohen, Christopher Beck ; PMLR 97:1290-1299
1. Background and Motivation:
Beam search 是一种常用在时序任务中解码算法,如:NLP 中的语言翻译,Image Captioning 等。不同于一般的贪婪搜索策略,该算法会始终维持相同的搜索宽度,最终会输出该宽度的多个搜索结果。就是因为这种天然的优势,该算法被广泛的应用于各种时序任务中。但是,大量的研究表明,beam search 存在如下的不足:“随着 width” 的增加,最终的效果也会不断降低,即:增加 width,不能提升效果,该算法只能在特定的较小的 width 条件下,才会 work 的很好。
针对上述问题,作者在本文中在多个任务上进行了大量的实验,来研究这个问题:machine translation,abstract summarization, and image captioning。作者在这些实验的基础上,提出了一种可解释的模型,该模型基于 search discrepancies(搜索差异性) 的概念,然后基于该差异性的分布进行了经验性的研究。主要贡献如下:
1). 本文表明增加 beam width 将会导致 solution 在早期有较大的不一致性 (discrepancies);这些序列通常会有较低的评价得分,从而导致最终的性能衰减。
2). 本文所提出的 explanatory model generalizes the previouly observed "copies" and predictions that repeat training set targets and accounts for more of the degraded predictions.
3). 本文表明对 beam search 进行修改,使其不考虑 large search discrepancies 可以有效的缓解性能衰减。
2. Neural Sequence Models:
在神经序列模型中,通过充分的搜索以求得一个全局最优序列几乎是不可能的。贪心算法会在每一个时刻,选择一个最优的候选,使得序列局部最优,但是可能最终得到的仅仅是一个局部次优的序列。Beam search 将每一个时刻的可能序列宽度拓展为 B,这个 B 称为 beam width。正式的来说,beam search candidate 通过如下的方式进行更新:
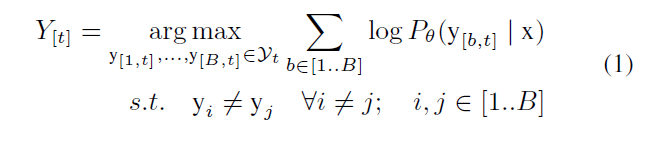
本文将 search discrepancy 定义为:extending a partial sequence with a token that is not the most probable one. 正式的来说,一个序列 y 在时刻 t 有一个 search discrepancy,如果其满足如下的条件:
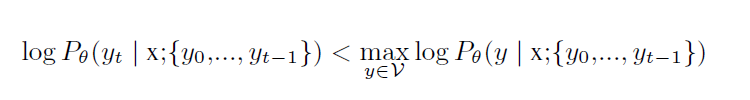
我们将最可能的 token 和 选择的 token 的差异性,取 log,记为:
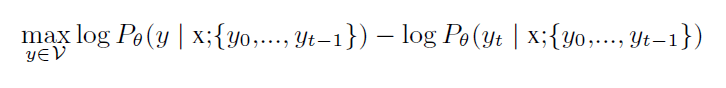
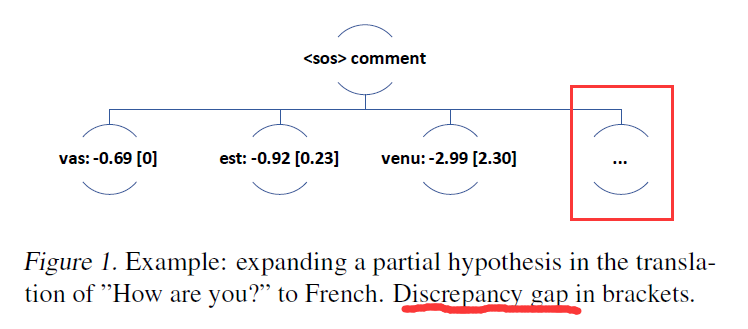
为了说明该 discrepancy gap 是如何计算的,我们给出了上图1。具有最高条件概率候选的 discrepancy gap 为 0,其他候选之间的 gap 就是其 log 概率的距离。
3. Discrepancy-Constrained Beam Search:
本文评价了两种类似 trick 的方法来约束 beam search,都是考虑到较大的搜索差异。
Discrepancy Gap:
给定阈值 M,我们修改 beam search 来仅仅考虑搜索差异小于等于 M 的候选。正式的来说,我们修改公式 1,使其包含这一约束:
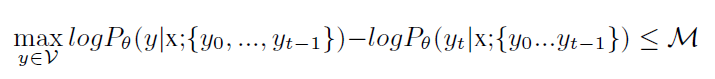
Beam Candidate Rank:
给定阈值 N,我们修改 $y_t$ 使其在每一个 beam 中仅仅包含 top N one-token extensions。注意到,beam search 仍然保持 top B candidates,然而在每一个 beam 中,其不会考虑超过 N 的候选。
4. Experiments:
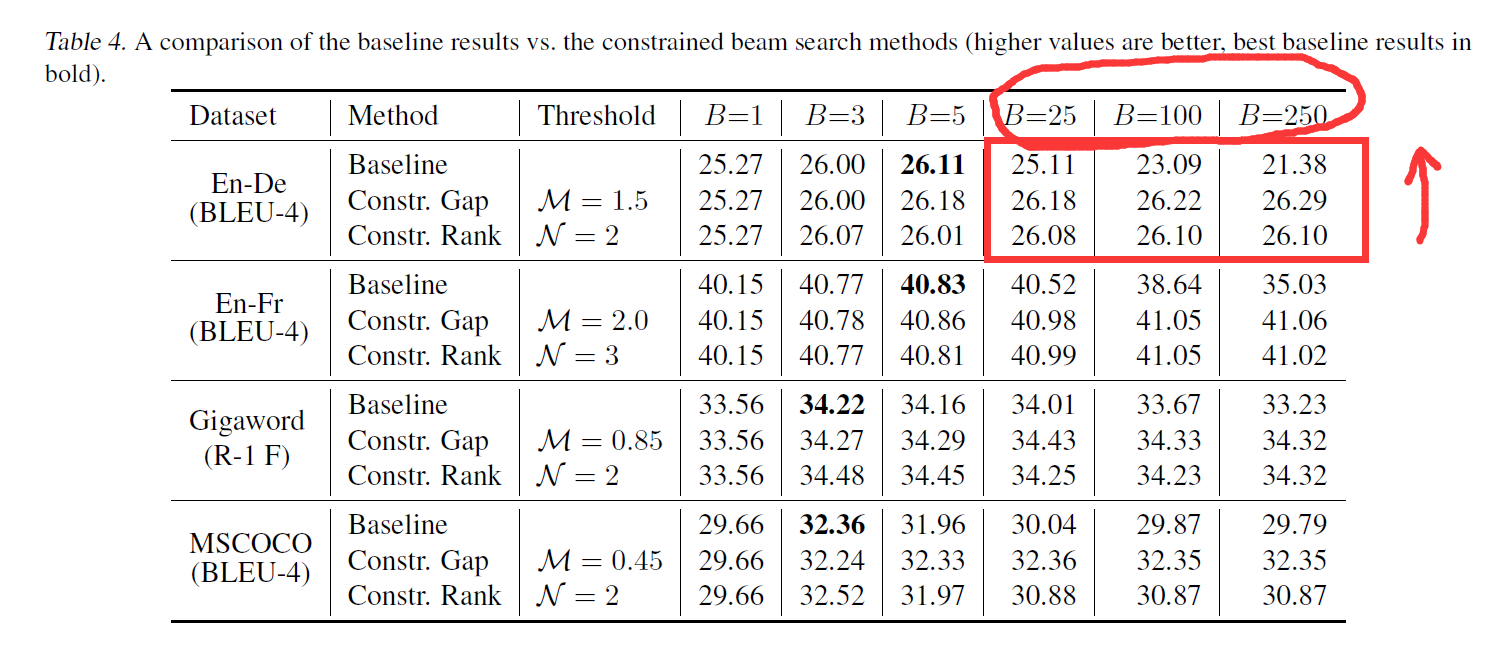
作者的实验表明,当考虑到作者提到的不一致性约束时,在增加 beam width 的时候,就不存在精度下降的问题了。但是这个表格貌似也反映了,beam width 设置的太大,有些情况下,并不会明显提升精度,反而有可能降低。到底该不该设置较大的 beam width,还是应该调调参数,试试才知道哇。
==
Empirical Analysis of Beam Search Performance Degradation in Neural Sequence Models的更多相关文章
- Beam Search(集束搜索/束搜索)
找遍百度也没有找到关于Beam Search的详细解释,只有一些比较泛泛的讲解,于是有了这篇博文. 首先给出wiki地址:http://en.wikipedia.org/wiki/Beam_searc ...
- 关于Beam Search
Wiki定义:In computer science, beam search is a heuristic search algorithm that explores a graph by exp ...
- [0.0]Analysis of Baidu search engine
Rencently, my two teammates and I is doing a project, a simplified Chinese search engine for childre ...
- 【NLP】选择目标序列:贪心搜索和Beam search
构建seq2seq模型,并训练完成后,我们只要将源句子输入进训练好的模型,执行一次前向传播就能得到目标句子,但是值得注意的是: seq2seq模型的decoder部分实际上相当于一个语言模型,相比于R ...
- 集束搜索beam search和贪心搜索greedy search
贪心搜索(greedy search) 贪心搜索最为简单,直接选择每个输出的最大概率,直到出现终结符或最大句子长度. 集束搜索(beam search) 集束搜索可以认为是维特比算法的贪心形式,在维特 ...
- 关于 Image Caption 中测试时用到的 beam search算法
关于beam search 之前组会中没讲清楚的 beam search,这里给一个案例来说明这种搜索算法. 在 Image Caption的测试阶段,为了得到输出的语句,一般会选用两种搜索方式,一种 ...
- 实现nlp文本生成中的beam search解码器
自然语言处理任务,比如caption generation(图片描述文本生成).机器翻译中,都需要进行词或者字符序列的生成.常见于seq2seq模型或者RNNLM模型中. 这篇博文主要介绍文本生成解码 ...
- Beam Search
Q: 什么是Beam Search? 它在NLP中的什么场景里会⽤到? 传统的广度优先策略能够找到最优的路径,但是在搜索空间非常大的情况下,内存占用是指数级增长,很容易造成内存溢出,因此提出了beam ...
- beam search 和 greedy search
贪心搜索(greedy search): 贪心搜索最为简单,直接选择每个输出的最大概率,直到出现终结符或最大句子长度. 集束搜索(beam search): 集束搜索可以认为是维特比算法的贪心形式,在 ...
随机推荐
- 140款Android开源优秀项目源码
BeautifulRefreshLayout-漂亮的美食下拉刷新 https://github.com/android-cjj/BeautifulRefreshLayout/tree/Beautifu ...
- JavaScript笔记02_对象
目录 1. 函数 1. 函数创建 2. 函数的参数 2. return.break.continue 3. 立即执行函数 4. 对象 5. 枚举对象中的属性 6. 声明提前 1.变量的声明提前 2. ...
- GROUP BY HAVING,ORDER BY
--HAVING语句与GROUP BY语句联合使用,用来过滤由GROUP BY语句返回的记录集. --并且HAVING语句的存在弥补了WHERE关键字不能与聚合函数联合使用的不足. ), SUM([C ...
- docker 安装 oracle
docker 安装 oracle 部署链接:https://www.linuxidc.com/Linux/2017-03/141760.htm 本次使用docker安装oracle 1.搜索可使用的镜 ...
- SQL进阶系列之10HAVING子句又回来了
写在前面 HAVING子句的处理对象是集合而不是记录 各队,全队点名 --各队,全体点名! CREATE TABLE Teams (member CHAR(12) NOT NULL PRIMARY K ...
- P5431 【【模板】乘法逆元2】
卡常毒瘤题.交了一页的我. 首先容易想出暴力的做法,直接逆元累加,复杂度\(O(nlogn)\). for(register int i=1;i<=n;++i){ ll a=read(); an ...
- python——selenium库的使用
selenium 是一个用于Web应用程序测试的工具.Selenium测试直接运行在浏览器中,就像真正的用户在操作一样.支持的浏览器包括IE(7, 8, 9, 10, 11),Mozilla Fire ...
- 前端知识--控制input按钮的可用和不可用
最近在项目的开发的时候,自己虽然是写后端的,但是,在开发核心的时候,前端的知识自己还是会用到的,多以前端这块自己由于好长时间都没有去看,所以几乎已经忘记的差不多了,现在也只能是想起一点记录一点,以便能 ...
- Mybatis框架-resultMap元素的自动映射级别
resultMap的自动映射级别:分为三种:NONE PARTIAL FULL 其中默认的属性是:PARTIAL:开启自动匹配,会自动匹配数据库中的字段名和实体类中的属性名,如果一致,就能匹配上, ...
- 树莓派linux shell
ls命令用来显示目录下有哪些文件和文件夹 pi@raspberry ~ $ ls 蓝色表示文件夹 白色是文件 ls -R列出所有文件夹的内容(R表示递归) ls -l 查看详细信息 包括文件权限 最后 ...