
BERT安装与使用
环境:
python 3.5

tensorflow 1.12.1

bert-serving-server 1.9.1

bert-serving-cline 1.9.1
官网上说要保证Python >= 3.5 with Tensorflow >= 1.10
1.安装BERT服务端和客户端
pip install bert-serving-server  # server

pip install bert-serving-client  # client, independent of `bert-serving-server`
2.下载预训练的中文BERT模型
根据 NLP 任务的类型和规模不同,Google 提供了多种预训练模型供选择:
- BERT-Base, Chinese: 简繁体中文, 12-layer, 768-hidden, 12-heads, 110M parameters【我下载的是这个】
- BERT-Base, Multilingual Cased: 多语言(104 种), 12-layer, 768-hidden, 12-heads, 110M parameters
- BERT-Base, Uncased: 英文不区分大小写(全部转为小写), 12-layer, 768-hidden, 12-heads, 110M parameters
- BERT-Base, Cased: 英文区分大小写, 12-layer, 768-hidden, 12-heads , 110M parameters
- 中文效果更好的哈工大版 BERT:Chinese-BERT-wwm
下载成功后,解压
3.启动BERT服务端
bert-serving-start -model_dir chinese_L-12_H-768_A-12 -num_worker=1
-model_dir 是预训练模型的路径,-num_worker 是线程数,表示同时可以处理多少个并发请求
BERT 模型对内存有比较大的要求,如果启动时一直卡在 load graph from model_dir 可以将 num_worker 设置为 1 或者加大机器内存。
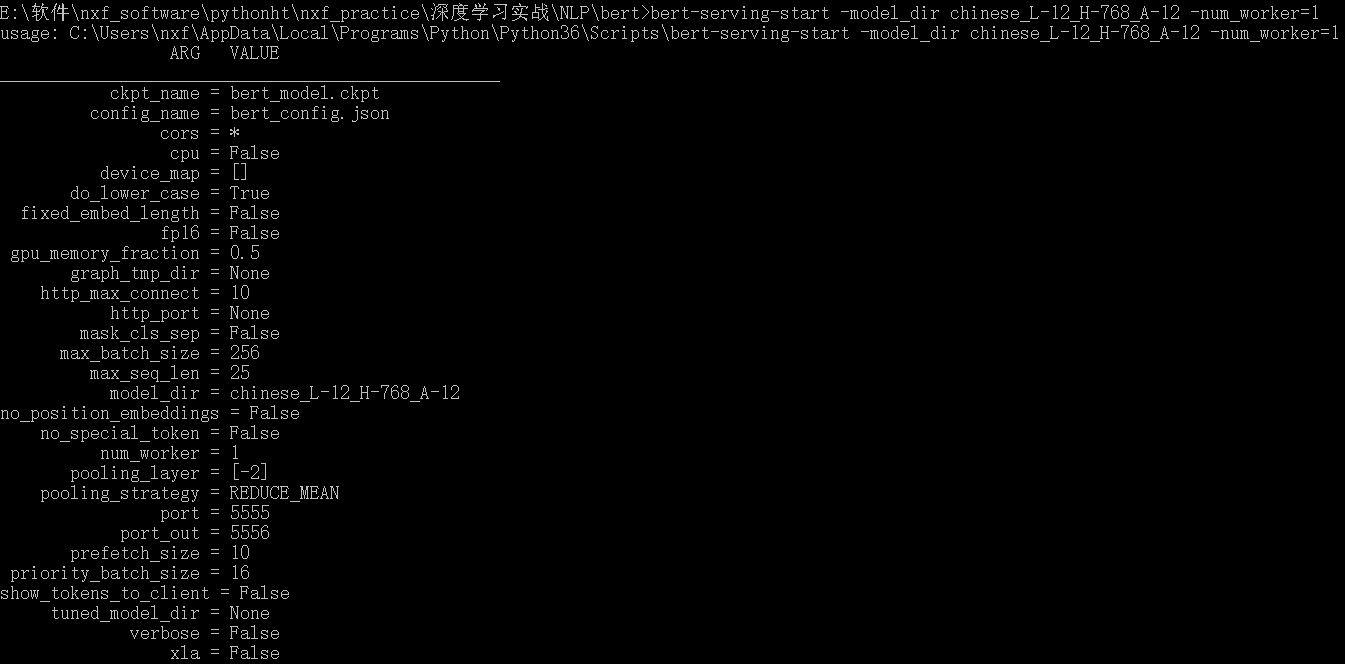
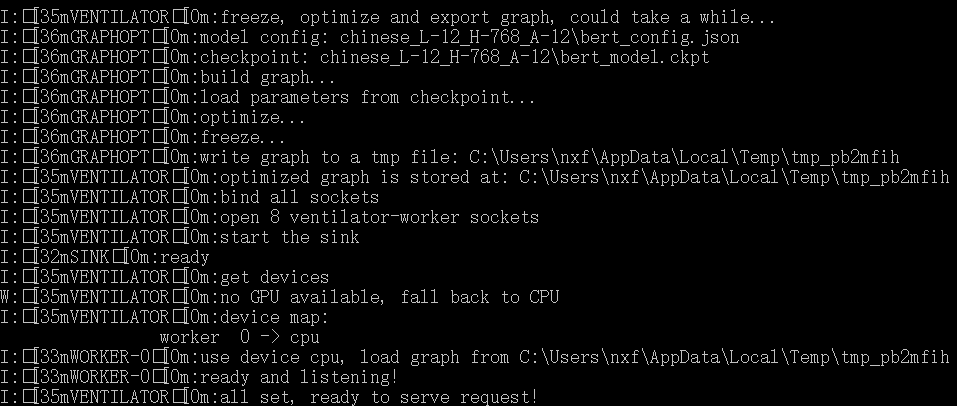
4. 在客户端获取句向量
from bert_serving.client import BertClient

bc = BertClient(ip='localhost',check_version=False, check_length=False)

vec = bc.encode(['努力写大论文中'])

print(vec) # 维度(1,768)
vec 是一个 numpy.ndarray ,它的每一行是一个固定长度的句子向量,长度由输入句子的最大长度决定。如果要指定长度,可以在启动服务使用 max_seq_len 参数,过长的句子会被从右端截断。

在计算中文向量时,可以直接输入整个句子不需要提前分词。因为 Chinese-BERT 中,语料是以字为单位处理的,因此对于中文语料来说输出的是字向量。
举个例子,当用户输入:
bc.encode(['你好吗?'])
实际上,BERT 模型的输入是:
tokens: [CLS] 你 好 么 ? [SEP]

input_ids: 101 872 1962 720 8043 102 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0

input_mask: 1 1 1 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
5.获取词向量
启动服务时将参数 pooling_strategy 设置为 None :
bert-serving-start -pooling_strategy NONE -model_dir /root/zhihu/bert/chinese_L-12_H-768_A-12/
这时的返回是语料中每个 token 对应 embedding 的矩阵
bc = BertClient()

vec = bc.encode(['hey you', 'whats up?'])

vec  # [2, 25, 768]

vec[0]  # [1, 25, 768], sentence embeddings for `hey you`

vec[0][0]  # [1, 1, 768], word embedding for `[CLS]`

vec[0][1]  # [1, 1, 768], word embedding for `hey`

vec[0][2]  # [1, 1, 768], word embedding for `you`

vec[0][3]  # [1, 1, 768], word embedding for `[SEP]`

vec[0][4]  # [1, 1, 768], word embedding for padding symbol

vec[0][25]  # error, out of index!

参考文献:
【1】bert-as-service三行代码使用bert模型 - accumulate_zhang的博客 - CSDN博客
【2】快速使用 BERT 生成词向量:bert-as-service - P01son的博客 - CSDN博客
BERT安装与使用的更多相关文章
- win10 + 独显 + Anaconda3 + tensorflow_gpu1.13 安装教程(跑bert模型)
这里面有很多坑,最大的坑是发现各方面都装好了结果报错 Loaded runtime CuDNN library: 7.3.1 but source was compiled with: 7.4.1, ...
- java-1-java开发环境安装及配置-绝对权威
1,下载安装jdk1.8u45 http://www.oracle.com/technetwork/java/javase/downloads/index-jsp-138363.html 一般安装目录 ...
- 源代码安装-非ROOT用户安装软件的方法
0. 前言 如果你没有sudo权限,则很多程序是无法使用别人编译好的文件安装的. 还有时候,没有对应你的主机配置的安装包,这时候需要我们自己下载最原始的源代码,然后进行编译安装. 这样安装的程序 ...
- Net-SNMP V3协议 安装配置笔记(CentOS 6.3/5.6)
注意:snmp V3,需要需要关闭selinux和防火墙: 关闭selinux方法: #vi /etc/selinux/config 将文件中的SELINUX="" 为 disab ...
- 学习笔记44—Linux下安装freesurfer
第一步:安装ubuntu (略过) 第二步:下载freesurfer:从freesurfer的官方网站上下载:http://surfer.nmr.mgh.harvard.edu/fswiki/Down ...
- Net-SNMP(V3协议)安装配置笔记(CentOS 5.2)(转)
原出处:http://blog.ihipop.info/2010/03/722.html 为了这颗仙人掌(cacti),我必须先部署(Net-SNMP), 同时我为了安全因素,也为了简便考虑,决定采用 ...
- 基于Bert的文本情感分类
详细代码已上传到github: click me Abstract: Sentiment classification is the process of analyzing and reaso ...
- 使用modelarts部署bert命名实体识别模型
模型部署介绍 当我们通过深度学习完成模型训练后,有时希望能将模型落地于生产,能开发API接口被终端调用,这就涉及了模型的部署工作.Modelarts支持对tensorflow,mxnet,pytorc ...
- 使用bert进行情感分类
2018年google推出了bert模型,这个模型的性能要远超于以前所使用的模型,总的来说就是很牛.但是训练bert模型是异常昂贵的,对于一般人来说并不需要自己单独训练bert,只需要加载预训练模型, ...
随机推荐
- linux学习(六)文件基本属性
Linux系统是一种典型的多用户系统,不同的用户处于不同的地位,拥有不同的权限.为了保护系统的安全性,Linux系统对不同的用户访问同一文件(包括目录文件)的权限做了不同的规定. 在Linux中我们可 ...
- 201871010116-祁英红《面向对象程序设计(java)》第四周学习总结
博文正文开头格式:(2分) 项目 内容 <面向对象程序设计(java)> https://www.cnblogs.com/nwnu-daizh/ 这个作业的要求在哪里 https://ww ...
- [C1W1] Neural Networks and Deep Learning - Introduction to Deep Learning
第一周:深度学习引言(Introduction to Deep Learning) 欢迎(Welcome) 深度学习改变了传统互联网业务,例如如网络搜索和广告.但是深度学习同时也使得许多新产品和企业以 ...
- lua 11 闭包,函数的使用
转自:http://book.luaer.cn/_41.htm 当一个函数内部嵌套另一个函数定义时,内部的函数体可以访问外部的函数的局部变量,这种特征我们称作词法定界.虽然这看起来很清楚,事实并非如此 ...
- zz《分布式服务架构 原理、设计与实战》综合
这书以分布式微服务系统为主线,讲解了微服务架构设计.分布式一致性.性能优化等内容,并介绍了与微服务系统紧密联系的日志系统.全局调用链.容器化等. 还是一样,每一章摘抄一些自己觉得有用的内容,归纳整理, ...
- bcftools
beftools非常复杂,大概有20个命令,每个命令下面还有N多个参数 annotate .. edit VCF files, add or remove annotations call .. SN ...
- 【CF464E】The Classic Problem(主席树+最短路)
点此看题面 大致题意: 给你一张无向图,每条边的边权为\(2^{x_i}\),求\(s\)到\(t\)的最短路. 最短路 最短路,首先考虑\(Dijkstra\).这里用\(SPFA\)似乎不太好,因 ...
- JavaScript forEach() 方法
JavaScript forEach() 方法 JavaScript Array 对象 实例 列出数组的每个元素: <button onclick="numbers.forEach( ...
- 按照官网的升级完socket.io报错Manager is being released。
查阅了很多资料和英文官网自己也提出了一些问题,估计官网以前有该类的问题历史,懒得回复. 终于功夫不负有心人原因竟然是:你的manager被释放了. you need to make sure the ...
- python threading Semaphore
#Semaphore 是用于控制进入数量的锁,控制同时进行的线程,内部是基于Condition来进行实现的 #文件, 读.写, 写一般只是用于一个线程写,读可以允许有多个 #做爬虫 import th ...