
[DB] Spark SQL
概述
- 基于Spark,兼容Hive
- 集成在Spark中,不需单独安装
- 提供统一的数据访问方式
- 结构化的数据类型:JDBC、JSON、Hive、Parquet(Saprk SQL 默认数据源)
- 支持标准的数据连接:JDBC、ODBC
- Hive把sql解析成了mapreduce程序,sparksql把sql语句解析成了Spark任务
- spark core 操作RDD,spark sql 操作DataFrame
- RDD内部元素是java对象,DataFrame内部是Row对象,相比于RDD多了元信息
- DataFrame是一种以RDD为基础的分布式数据集,类似MySQL的表
- DataSet是分布式的数据集合,提供了强类型支持,在RDD每行增加类型约束,解决了DataFrame缺乏编译时类型安全
- DataSet包含了DataFrame功能,Spark2.0中两者统一,DataFrame表示为DataSet[Row]
- 表(DataFrame)= 结构(Schema) + 数据(RDD)
- Spark on Hive:通过Sparksql加载Hive配置文件,获取元信息,底层运行Spark RDD(Spark主导,拿到Hive元信息),例如通过Spark程序将Hive数据写入ES
- Hive on Spark:把Hive查询从mr操作替换为Spark RDD操作,需重新编译Spark,操作较复杂(Hive主导,替换计算引擎)
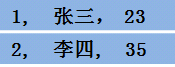 RDD
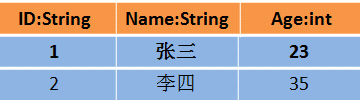 DataFrame
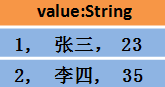 或
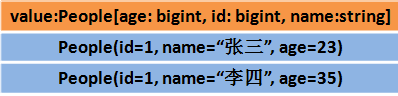 DataSet

优缺点
RDD
- 优点
- 编译时类型安全
- 面向对象开发风格
- 缺点
- 构建java对象会占用heap堆空间,导致频繁GC
- 数据序列化,反序列化开销大
DataFrame
- 优点
- 引入off-heap,对象构建不占用堆内存,避免频繁GC,运行效率高
- 引入schema,传输数据量减小,序列化反序列化开销减小
- 缺点
- 编译时不安全
- 不具有面向对象开发风格
DataSet
- 优点
- 结合RDD和DataFrame
- 支持自定义对象存储
- 支持结构化数据sql查询
- 采用堆外存储,gc友好
- 类型转换安全,代码友好
创建DataFrame
- 使用 case class 样本类
- 定义表的 schema
- 导入HDFS的dept.csv作为数据
- 使用 Spark Session
- 包括 Spark Context、SQL Context、Streaming Context
- 2.0后引入的统一访问接口,可访问所有spark组件
- 使用StructType创建schema
- 读取带格式文件
- Json

操作DataFrame
- DSL语句
- SQL语句
DataSet
视图
- 虚表,不存储数据
- 普通视图:本地视图,只在当前session中有效
- 全局视图:在不同session中都有效,把全局视图创建命名空间,global_temp
数据源
- load() 和 save()
- Parquet文件
- 列式存储文件,Spark SQL默认数据源
- 把其它文件转为Parquet文件
- 支持Schema的合并:项目开始的时候,表(schema)很简单,逐步向表中增加新的列
- Json文件
- val testResult = spark.read.json("/usr/local/tmp_files/emp.json")
- JDBC
- Hive
自定义函数
- UDF
- UDAF
性能优化
- 缓存方式:在内存中缓存数据
- 性能优化参数
IDE中开发
- 关闭log4j
参考
官网
Spark 集成 Hive
https://www.cnblogs.com/juncaoit/p/6545092.html
https://blog.csdn.net/qq_16633405/article/details/78278786
https://blog.csdn.net/weixin_37677769/article/details/83580893
http://bcxw.net/article/550.html
https://blog.csdn.net/qq_38704184/article/details/86482948
https://blog.csdn.net/xiaohu21/article/details/108960672
[DB] Spark SQL的更多相关文章
- Spark SQL Thrift Server 配置 Kerberos身份认证和权限管理
转载请注明出处:http://www.cnblogs.com/xiaodf/ 之前的博客介绍了通过Kerberos + Sentry的方式实现了hive server2的身份认证和权限管理功能,本文主 ...
- Spark SQL概念学习系列之Spark SQL 架构分析(四)
Spark SQL 与传统 DBMS 的查询优化器 + 执行器的架构较为类似,只不过其执行器是在分布式环境中实现,并采用的 Spark 作为执行引擎. Spark SQL 的查询优化是Catalyst ...
- Spark SQL 初步
已经Spark Submit 2013哪里有介绍Spark SQL.就在很多人都介绍Catalyst查询优化框架.经过一年的发展后,.今年Spark Submit 2014在.Databricks放弃 ...
- 大数据技术之_19_Spark学习_03_Spark SQL 应用解析 + Spark SQL 概述、解析 、数据源、实战 + 执行 Spark SQL 查询 + JDBC/ODBC 服务器
第1章 Spark SQL 概述1.1 什么是 Spark SQL1.2 RDD vs DataFrames vs DataSet1.2.1 RDD1.2.2 DataFrame1.2.3 DataS ...
- spark SQL读取ORC文件从Driver启动到开始执行Task(或stage)间隔时间太长(计算Partition时间太长)且产出orc单个文件中stripe个数太多问题解决方案
1.背景: 控制上游文件个数每天7000个,每个文件大小小于256M,50亿条+,orc格式.查看每个文件的stripe个数,500个左右,查询命令:hdfs fsck viewfs://hadoop ...
- 通过spark sql 将 hdfs上文件导入到mongodb
功能:通过spark sql 将hdfs 中文件导入到mongdo 所需jar包有:mongo-spark-connector_2.11-2.1.2.jar.mongo-java-driver-3.8 ...
- Spark SQL笔记
HDFS HDFS架构 1.Master(NameNode/NN) 对应 N个Slaves(DataNode/NN)2.一个文件会被拆分成多个块(Block)默认:128M例: 130M ==> ...
- Spark SQL快速离线数据分析
拷贝hive-site.xml到spark的conf目录下面 打开spark的conf目录下的hive-site.xml文件 加上这段配置(我这里三个节点的spark都这样配置) 把hive中的mys ...
- Caused by: java.sql.SQLException: Failed to start database 'metastore_db' with class loader org.apache.spark.sql.hive.client.IsolatedClientLoader$$anon$1@d7c365, see the next exception for details.
解决方法:https://stackoverflow.com/questions/37442910/spark-shell-startup-errors 异常: 18/01/29 19:04:27 W ...
随机推荐
- 14、运行Django时浏览器中遇到Refused to display 'url' in a frame because it set 'X-Frame-Options' to 'deny'
问题:Refused to display 'url' in a frame because it set 'X-Frame-Options' to 'deny' 解决办法: 只需要在 Djagno ...
- windows环境下抓密码总结
在线抓密码 1.mimikatz privilege::debug token::whoami token::elevate lsadump::sam mimikatz.exe "privi ...
- 解决“用PicGo-2.3.0-beta5 + GitHub做博客图床,github仓库图片文件不显示”的问题记录(备忘)
解决"用PicGo-2.3.0-beta5 + GitHub做博客图床,github仓库图片文件不显示"的问题记录(备忘) 历时几个小时百度,终于靠自己理解解决了GitHub仓库图 ...
- .NET WebSockets 核心原理初体验
上个月我写了<.NET gRPC核心功能初体验>, 里面使用gRPC双向流做了一个打乒乓球的Demo, 实时双向这两个标签是不是很熟悉,对, WebSockets也可以做实时双向通信. 本 ...
- @Scheduled注解
1 概述 @Scheduled注解是spring boot提供的用于定时任务控制的注解,主要用于控制任务在某个指定时间执行,或者每隔一段时间执行.注意需要配合@EnableScheduling使用,配 ...
- 利用Apache部署静态网站(二)
本文接着<利用Apache部署静态网站(一)>继续部署,为系统中的每位用户创建一个独立的网站. httpd服务程序提供的个人用户主页功能可以为每位用户创建一个独立的网站.该功能可以让系统内 ...
- 7.bug生命周期
new:测试发现并提交bug,状态为new/active; open: 分配bug到开发人员,状态为open: fixed:开发人员处理完bug,将状态改为fixed: closed/reopen:测 ...
- 1061 Dating
Sherlock Holmes received a note with some strange strings: Let's date! 3485djDkxh4hhGE 2984akDfkkkkg ...
- Python 并行计算那点事 -- 译文 [原创]
Python 并行计算的那点事1(The Python Concurrency Story) 英文原文:https://powerfulpython.com/blog/python-concurren ...
- php 一些神奇加有趣的函数
php里面神奇且又有趣的函数 这么有意思的title,我忍不住要啰嗦俩句,1--只是个人喜欢,不喜勿喷:2--仅个人笔记,未完,待续 列举 get_defined_constants:get_defi ...