
深度强化学习中稀疏奖励问题Sparse Reward
Sparse Reward
推荐资料
强化学习算法在被引入深度神经网络后,对大量样本的需求更加明显。如果智能体在与环境的交互过程中没有获得奖励,那么该样本在基于值函数和基于策略梯度的损失中的贡献会很小。
针对解决稀疏奖励问题的研究主要包括:1
Reward Shaping:奖励设计与学习
经验回放机制
探索与利用
多目标学习和辅助任务
1. Reward Shaping
人为设计的 “密集”奖励。
例如,在机械臂“开门”的任务中,原始的稀疏奖励设定为:若机械臂把门打开,则给予“+1”奖励,其余情况下均给予“0”奖励。然而,由于任务的复杂性,机械臂从随机策略开始,很难通过自身探索获得奖励。为了简化训练过程,可以使用人为设计的奖励:1)在机械臂未碰到门把手时,将机械臂与门把手距离的倒数作为奖励;2)当机械臂接触门把手时,给予“+0.1”奖励;3)当机械臂转动门把手时,给予“+0.5”奖励;4)当机械臂完成开门时,给予“+1”奖励。这样,通过人为设计的密集奖励,可以引导机械臂完成开门的操作,简化训练过程。
2. 逆向强化学习
针对人为设计奖励中存在的问题,Ng等2提出了从最优交互序列中学习奖励函数的思路,此类方法称为”逆强化学习”。
3. 探索与利用(好奇法):
在序列决策中,智能体可能需要牺牲当前利益来选择非最优动作,期望能够获得更大的长期回报。
在 DRL领域中使用的探索与利用方法主要包括两类:基于计数的方法和基于内在激励的方法。其目的是构造虚拟奖励,用于和真实奖励函数共同学习。由于真实的奖励是稀疏的,使用虚拟奖励可以加快学习的进程。
ICM3(逆环境模型)—— 改进的基于内在激励的方法
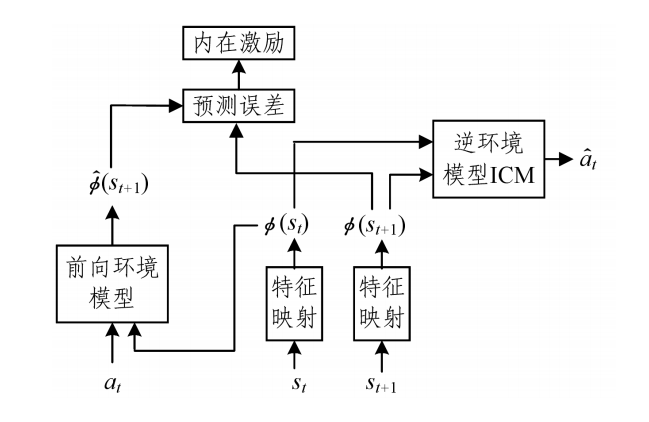
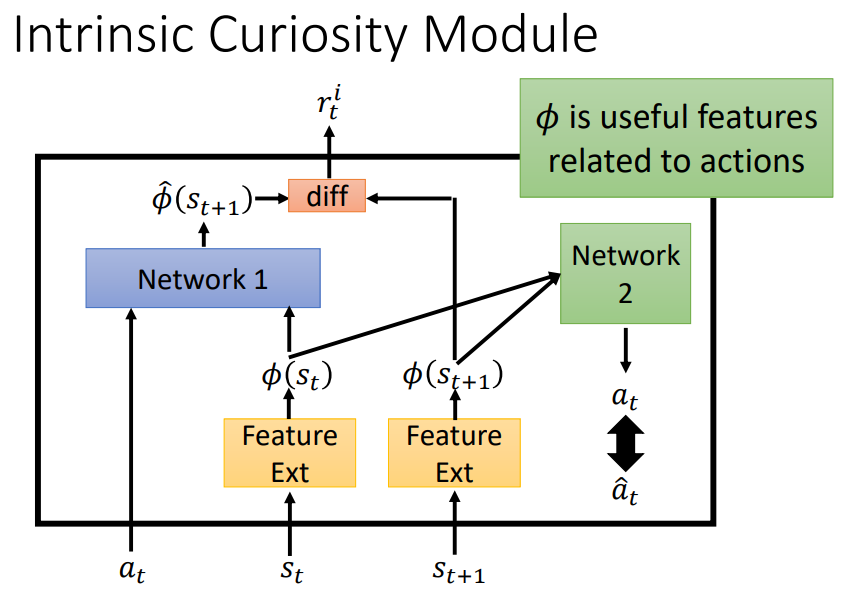
- Network 1:预测的状态S与实际状态S差别越大,回报r越大,鼓励冒险
- Network 2:输入 \(S_t\) 和 \(S_{t+1}\) ,预测动作 \(a_t\) ,与真实动作差别大时,表示无关紧要的状态。
- ICM 通过学习可以在特征空间中去除与预测动作无关的状态特征,在特征空间中构建环境模型可以去除环境噪声。
4. 多目标学习——层次强化学习
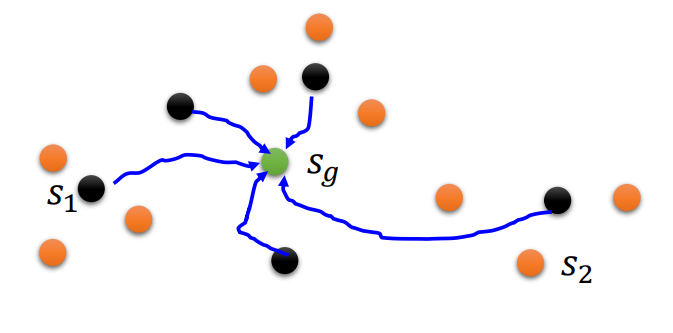
- 智能体可以从已经到达的位置来获得奖励。在训练中使用虚拟目标替代原始目标,使智能体即使在训练初期也能很快获得奖励,极大地加速了学习过程。
- 将一个单一目标,拆解为多个阶段的多层级的目标。
5. 辅助任务
在稀疏奖励情况下,当原始任务难以完成时,往往可以通过设置辅助任务的方法加速学习和训练。
Curriculum Learning,“课程式”强化学习:
当完成原始任务较为困难时,奖励的获取是困难的。此时,智能体可以先从简单的、相关的任务开始学习,然后不断增加任务的难度,逐步学习更加复杂的任务。
- 直接添加辅助任务:第二类方法是直接在原任务的基础上添加并行的辅助任 务,原任务和辅助任务共同学习。
参考文献
深度强化学习中稀疏奖励问题Sparse Reward的更多相关文章
- (转) 深度强化学习综述:从AlphaGo背后的力量到学习资源分享(附论文)
本文转自:http://mp.weixin.qq.com/s/aAHbybdbs_GtY8OyU6h5WA 专题 | 深度强化学习综述:从AlphaGo背后的力量到学习资源分享(附论文) 原创 201 ...
- 5G网络的深度强化学习:联合波束成形,功率控制和干扰协调
摘要:第五代无线通信(5G)支持大幅增加流量和数据速率,并提高语音呼叫的可靠性.在5G无线网络中共同优化波束成形,功率控制和干扰协调以增强最终用户的通信性能是一项重大挑战.在本文中,我们制定波束形成, ...
- 【资料总结】| Deep Reinforcement Learning 深度强化学习
在机器学习中,我们经常会分类为有监督学习和无监督学习,但是尝尝会忽略一个重要的分支,强化学习.有监督学习和无监督学习非常好去区分,学习的目标,有无标签等都是区分标准.如果说监督学习的目标是预测,那么强 ...
- 一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm)
一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm) 2017-12-25 16:29:19 对于 A3C 算法感觉自己总是一知半解,现将其梳理一下,记录在此,也 ...
- 深度强化学习资料(视频+PPT+PDF下载)
https://blog.csdn.net/Mbx8X9u/article/details/80780459 课程主页:http://rll.berkeley.edu/deeprlcourse/ 所有 ...
- 深度强化学习day01初探强化学习
深度强化学习 基本概念 强化学习 强化学习(Reinforcement Learning)是机器学习的一个重要的分支,主要用来解决连续决策的问题.强化学习可以在复杂的.不确定的环境中学习如何实现我们设 ...
- 深度强化学习(DQN-Deep Q Network)之应用-Flappy Bird
深度强化学习(DQN-Deep Q Network)之应用-Flappy Bird 本文系作者原创,转载请注明出处:https://www.cnblogs.com/further-further-fu ...
- 深度强化学习(Deep Reinforcement Learning)入门:RL base & DQN-DDPG-A3C introduction
转自https://zhuanlan.zhihu.com/p/25239682 过去的一段时间在深度强化学习领域投入了不少精力,工作中也在应用DRL解决业务问题.子曰:温故而知新,在进一步深入研究和应 ...
- 深度强化学习(DRL)专栏(一)
目录: 1. 引言 专栏知识结构 从AlphaGo看深度强化学习 2. 强化学习基础知识 强化学习问题 马尔科夫决策过程 最优价值函数和贝尔曼方程 3. 有模型的强化学习方法 价值迭代 策略迭代 4. ...
随机推荐
- 免费获取思维导图Mindmaster会员教程
免费获取思维导图Mindmaster会员教程 步骤一.下载安装 搜索亿图官方网页,下载安装免费版Mindmaster思维导图. 步骤二.点击登录 打开Mindmaster思维导图,点击登录,可以使用微 ...
- JavaScript 沙盒模式
微前端已经成为前端领域比较火爆的话题,在技术方面,微前端有一个始终绕不过去的话题就是前端沙箱 什么是沙箱 Sandboxie(又叫沙箱.沙盘)即是一个虚拟系统程序,允许你在沙盘环境中运行浏览器或其他程 ...
- jenkins 修改端口后无法启动的解决思路
一.问题 jenkins网站绑定域名后直接通过域名访问使用的是8080端口,为方便用户访问因此须监听80端口,而为了安全起见linux一般不用root身份运行,综上,需要以普通用户来运行监听80端口时 ...
- 通过busybox制作根文件系统详细过程
我在之前的uboot通过NFS挂载ubuntu根文件系统中也有实现过根文件系统的制作,那只是在ubuntu官网已经做好的根文件基础上安装一些自己所需的软解而已.而使用busybox制作根文件系统可以自 ...
- Docker搭建EFK日志收集系统,并自定义es索引名
EFK架构图 一.EFK简介 EFK不是一个软件,而是一套解决方案,并且都是开源软件,之间互相配合使用,完美衔接,高效的满足了很多场合的应用,是目前主流的一种日志系统. EFK是三个开源软件的缩写,分 ...
- CRM的职能和主要构成模块探索
CRM客户管理系统是随着互联网的快速发展和信息技术的进步而发展起来的,是企业管理客户关系.优化业务流程的首选.客户关系管理可以存储企业获得的客户信息,方便业务人员随时查看和了解客户需求:客户关系管理可 ...
- Docker | Docker常用命令学习笔记
@ 目录 前言 1. 帮助命令: version.info.help 2. 镜像命令: images.search pull.rmi 3. 容器命令: pull.run ps.exit .ctrl+P ...
- Redis:Redis的安装
Redis优势 性能极高 – Redis能读的速度是110000次/s,写的速度是81000次/s . 丰富的数据类型 – Redis支持二进制案例的 Strings, Li ...
- 使用Docker的同学注意了,这10个坑小心中招了
Docker容器优点容器已经成为企业IT基础设施中必不可少的部分,它具有许多的优点,比如: 1 容器是不可变的--操作系统,库版本,配置,文件夹和应用程序都包装在容器内.你保证在质量检查中测试过的同一 ...
- Redisson 分布式锁源码 11:Semaphore 和 CountDownLatch
前言 Redisson 除了提供了分布式锁之外,还额外提供了同步组件,Semaphore 和 CountDownLatch. Semaphore 意思就是在分布式场景下,只有 3 个凭证,也就意味着同 ...