
常用正则表达式RE(慕课网_Meshare_huang)
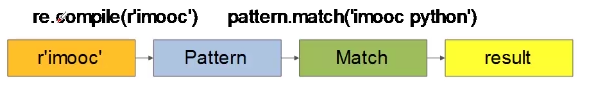
import re

str1 = 'imooc python'

# str1.find('l1')          输出:      -1

# str1.find('imooc')                  0

# str1.startswith('imooc')            True

pa = re.compile(r'imooc')             #加个r 代表是个原字符串

# pa = re.compile('imooc\n')          \n会转译成一个换行符

# type: _sre.SRE_Pattern

pa.match(str1)

ma = pa.match(str1)

# ma.span()                           (0, 5)

# ma.group()                          'imooc'

# ma.string                             'imooc python'

# ma.re                                 re.compile(r'imooc', re.UNICODE)

pa1 = re.compile(r'_')

ma1 = pa1.match('_value')

# ma1.group                          <function SRE_Match.group>

# pa                                 re.compile(r'imooc', re.UNICODE)

ma = pa.match('imooc python')

# ma.group()                         'imooc'

# pa = pa.match('imoOc python', re.I)

# type(pa)                           NoneType

pa = re.compile(r'(imooc)', re.I)    #组    大写的i

ma = pa.match(str1)

# ma.group()                           'imooc'

# ma.groups()                          ('imooc',)

# ma = re.match(r'imooc', str1)

# ma                                    <_sre.SRE_Match object; span=(0, 5), match='imooc'>

# ma.group()                            'imooc'
语法
# . 匹配任意字符 除了\n

# ma = re.match(r'a', 'a')

# ma.group()                            'a'

# ma = re.match(r'.', 'b')

# ma.group()                            'b'

# ma = re.match(r'.', '0')

# ma.group()                            '0'

# ma = re.match(r'{.}', '{a}')

# ma.group()                           '{a}'

# ma = re.match(r'{..}', '{a0}')

# ma.group()                           '{a0}'

# [...] 匹配字符集

# ma = re.match(r'{[abc]}', '{a}')

# ma.group()                             '{a}'

# ma = re.match(r'{[abc]}', '{d}')

# ma.group()                             AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'{[a-z]}', '{d}')

# ma.group()                             '{d}'

# ma = re.match(r'{[a-zA-Z]}', '{D}')

# ma.group()                             '{D}'

# ma = re.match(r'{[a-zA-Z0-9]}', '{9}')

# ma.group()                             '{9}'

# ma = re.match(r'{[\w]}', '{0}')

# ma.group()                             '{0}'

# ma = re.match(r'{[\w]}', '{ }')

# ma.group()    AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'{[\W]}', '{ }')

# ma.group()                            '{ }'

# ma = re.match(r'{[[\w]]}', '[0]')

# ma.group()                            AttributeError:

# ma = re.match(r'\[[\w]\]', '[0]') 要加转译字符

# ma.group()                            '[0]'
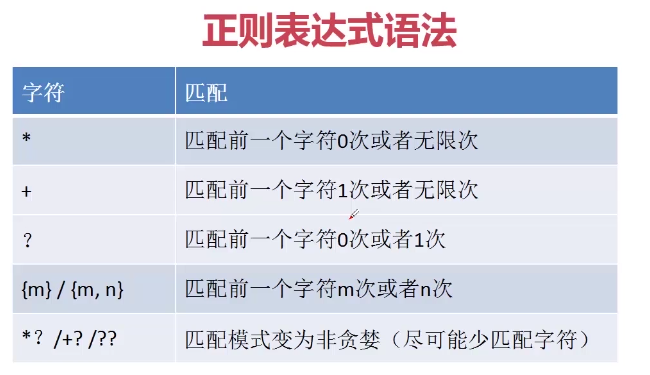
import re

# ma = re.match(r'[A-Z][a-z]', 'Aa')

# ma.group()                            'Aa'

# ma = re.match(r'[A-Z][a-z]*', 'A')

# ma.group()                             'A'

# ma = re.match(r'[A-Z][a-z]*', 'AdsfafeadcxAe') 如果出现数字是匹配不上的

# ma.group()                             'Adsfafeadcx'

# _ = 10

# _                                             10

# ma = re.match(r'[0-9]?[0-9]', '90')

# ma.group()                              '90'

# ma = re.match(r'[0-9]?[0-9]', '9')

# ma.group()                               '9'

# ma = re.match(r'[0-9]?[0-9]', '09')

# ma.group()                              '09'

# ma = re.match(r'[a-zA-Z0-9]{6}', 'abc123')

# ma.group()                              'abc123'

# ma = re.match(r'[a-zA-Z0-9]', 'abc123')

# ma.group()                              'a'

# ma = re.match(r'[a-zA-Z0-9]{6}', 'abc123__')

# ma.group()                             'abc123'

# ma = re.match(r'[a-zA-Z0-9]{6}@163.com', 'abc123@163.com')

# ma.group()                             'abc123@163.com'

# ma = re.match(r'[a-zA-Z0-9]{6, 10}@163.com', 'imoocedu@163.com')

# ma.group()                             AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'[0-9][a-z]*?', '1bc')

# ma.group()                            '1'

# ma = re.match(r'[a-zA-Z0-9]+?', '1bc')

# ma.group()                            '1'

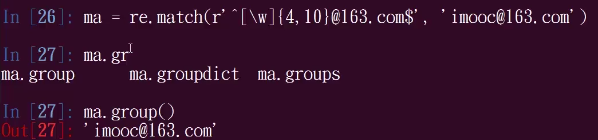
# ma = re.match(r'\Aimooc[\w]', 'imoocpython') 边界匹配

# ma.group()                            'imoocp'
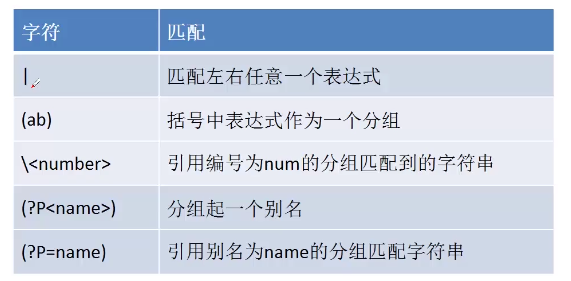
# ma = re.match(r'abc|d', 'abc')

# ma.group()                            'abc'

# ma = re.match(r'[1-9]?\d$', '9')

# ma.group()                            '9'

# ma = re.match(r'[1-9]?\d|100$', '100')

# ma.group()                            '10'

# ma = re.match(r'[1-9]?\d|100$', '99')

# ma.group()                            '99'

# ma = re.match(r'[1-9]?\d|100$', '9')

# ma.group()                            '9'

# ma = re.match(r'[\w]{4, 6}@(163|126).com', 'imooc@163.com')

# ma.group()                            AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'[\w]{4, 6}@(163|126).com', 'imooc@126.com')

# ma.group()                            AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'<[\w]+>', '<book>')

# ma.group()                           '<book>'

# ma = re.match(r'<([\w]+>)', '<book>')

# ma.group()                          '<book>'

# ma = re.match(r'<([\w]+>)\1', '<book>')

# ma.group()                          AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'<([\w]+>)\1', '<book>book>')

# ma.group()                          '<book>book>'

# ma = re.match(r'<([\w]>)[\w]+</\1', '<book>python</book>')

# ma.group()                          AttributeError: 'NoneType' object has no attribute 'group'

# ma = re.match(r'<(?P<mark>[\w]>)[\w]+</(?P=mark)', '<book>python</book>')

# ma.group()                          AttributeError: 'NoneType' object has no attribute 'group'

import re

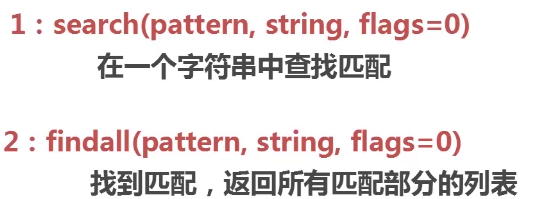
str1 = 'imooc videonum = 100'

# str1.find('100')                     # 17

info = re.search(r'\d+', str1)

# info # <_sre.SRE_Match object; span=(17, 20), match='100'>

str1 = 'imooc videonum = 10000'

# info.group()                         # '100'

str2 = 'c++=100, java=90, python=80'

info = re.findall(r'\d+', str2)

# info                                        ['100', '90', '80']

# sum([int(x) for x in info])         270

str3 = 'imooc videonum = 10000'

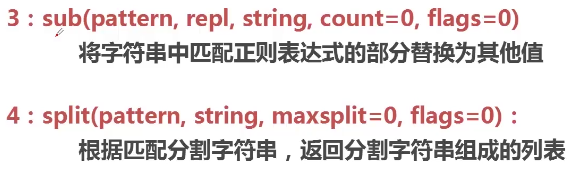
info = re.sub(r'\d+', '1001', str3)

# info                                        'imooc videonum = 1001'

def add1(match):

val = match.group()

num = int(val) + 1

return str(num)

# re.sub(r'\d+', add1, str3)       'imooc videonum = 10001'

str4 = 'imooc:c c++ java python'

#不能仅仅使用空格分割

re.split(r':| ', str4)                      #['imooc', 'c', 'c++', 'java', 'python']

# str4 = 'imooc:c c++ java python,c#'

# re.split(r':| |,', str4)                ['imooc', 'c', 'c++', 'java', 'python', 'c#']
常用正则表达式RE(慕课网_Meshare_huang)的更多相关文章
- 慕课网:剑指Java面试-Offer直通车视频课程
慕课网:剑指Java面试-Offer直通车视频课程,一共有10个章节. 目录结构如下: 目录:/2020036-慕课网:剑指Java面试-Offer直通车 [6G] ┣━━第10章 Java常用类库与 ...
- JavaScript入门--慕课网学习笔记
JAVASCRIPT—(慕课网)入门篇 我们来看看如何写入JS代码?你只需一步操作,使用<script>标签在HTML网页中插入JavaScript代码.注意, <script&g ...
- java网络爬虫----------简单抓取慕课网首页数据
© 版权声明:本文为博主原创文章,转载请注明出处 一.分析 1.目标:抓取慕课网首页推荐课程的名称和描述信息 2.分析:浏览器F12分析得到,推荐课程的名称都放在class="course- ...
- [python] 常用正则表达式爬取网页信息及分析HTML标签总结【转】
[python] 常用正则表达式爬取网页信息及分析HTML标签总结 转http://blog.csdn.net/Eastmount/article/details/51082253 标签: pytho ...
- 常用正则表达式-copy
匹配中文:[\u4e00-\u9fa5] 英文字母:[a-zA-Z] 数字:[0-9] 匹配中文,英文字母和数字及_: ^[\u4e00-\u9fa5_a-zA-Z0-9]+$ 同时判断输入长度:[\ ...
- PHP常用正则表达式汇总 [复制链接]
PHP常用正则表达式汇总 [复制链接] 上一主题下一主题 离线我是小猪头 法师 发帖 539 加关注 发消息 只看楼主 倒序阅读 使用道具楼主 发表于: 2011-06-22 更多 ...
- 慕课网-安卓工程师初养成-4-7 Java循环语句之 while
来源: http://www.imooc.com/code/1420 生活中,有些时候为了完成任务,需要重复的进行某些动作.如参加 10000 米长跑,需要绕 400 米的赛道反复的跑 25 圈.在 ...
- Python爬虫之爬取慕课网课程评分
BS是什么? BeautifulSoup是一个基于标签的文本解析工具.可以根据标签提取想要的内容,很适合处理html和xml这类语言文本.如果你希望了解更多关于BS的介绍和用法,请看Beautiful ...
- RegExp正则表达式规则以及常用正则表达式
html,body { font-family: "SF UI Display", ".PingFang SC", "PingFang SC" ...
随机推荐
- 案例分析——Who is the king of handwriting notes?
案例分析--Who is the king of handwriting notes? 项目 内容 这个作业属于那个课程 2021春季学期软件工程(罗杰.任健) 这个作业的要求在哪里 案例分析 我在这 ...
- 2020北航OO第一单元总结
前言 学习面向对象这门课程的后的第一单元作业,主线是多项式求导,三次作业层层推进,由单一的幂函数求导,到幂函数和三角函数的复合求导,最后再到两种函数的嵌套求导,由两个类到重构后的十几个类,我逐渐对面向 ...
- ECMAScript 2019(ES10)新特性简介
简介 ES10是ECMA协会在2019年6月发行的一个版本,因为是ECMAScript的第十个版本,所以也称为ES10. 今天我们讲解一下ES10的新特性. ES10引入了2大特性和4个小的特性,我们 ...
- Linux安装MySQL8高版本压缩包(通用)
前言 前段时间领导让我部署测试环境,希望安装高版本的MySQL,过程遇到很多问题,特此记录帮助迷失的人们 下载 MySQL官方下载地址:https://dev.mysql.com/downloads/ ...
- 常用head标签
最小推荐 <meta charset="utf-8"> <meta http-equiv="x-ua-compatible" content= ...
- POJ 1201 差分约束(集合最小元素个数)
题意: 给你一个集合,然后有如下输入,a ,b ,c表示在范围[a,b]里面有至少有c个元素,最后问你整个集合最少多少个元素. 思路: 和HDU1384一模一样,首先这个题目可 ...
- Android进程so注入Hook java方法
本文博客链接:http://blog.csdn.net/qq1084283172/article/details/53769331 Andorid的Hook方式比较多,现在来学习下,基于Android ...
- hdu4561 连续最大积
题意: 连续最大积 Time Limit: 3000/1000 MS (Java/Others) Memory Limit: 65535/32768 K (Java/Others) Total ...
- JQuery跨站脚本漏洞
原理: jQuery中过滤用户输入数据所使用的正则表达式存在缺陷,可能导致 location.hash 跨站漏洞 影响版本: jquery-1.7.1~1.8.3 jquery-1.6.min.js, ...
- 动手实现一个适用于.NET Core 的诊断工具
前言 大家可能对诊断工具并不陌生,从大名鼎鼎的 dotTrace,到 .NET CLI 推出的一系列的高效诊断组件(dotnet trace,dotnet sos,dotnet dump)等, 这些工 ...