
python网络爬虫-python基础(三)
python安装
Anaconda的python科学计算环境,只需要想普通软件一样安装就可以把python的环境变量、解释器、开发环境都安装到计算机中
除此之外anaconda还提供众多的科学计算的包,如numpy、scipy、pandas、和matplotlib等,以及机器学习、生物医学和天体物理学计算等众多的包/模块,如scikilt-learn/biopython等。
使用pip安装第三方库
pip是python安装各种第三方库(package)的工具。库可以理解成别人写好的代码组合。安装好某一个库之后就可以直接调用其中的功能,我们就不用自己再重新写了
使用编译器pycharm编程
有个教育版不用激活个人练习的话可以用这个版本
python使用入门
基本命令
python是一种非常简单的语言,最简单的就是print,使用print可以打印出一系列的结果
python严格要求缩进
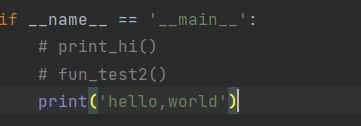
如果要注释某行代码前面加上‘#’
数据类型
- 字符串:一般用来存储类似句子的数据,放到单引号或双引号中,需要连接字符串用加号加起来就行
str0 = '111'
str1 = "222"
str2 = str + " " + str1
print(str2) - 数字:常用的两种数字类型:整型(int)和浮点数(float)。两种数据类型要互换就用括号括起来前面加上想要转换的数据类型就行
int1 = 1
float1 = 1.1
strans_int = int(float1)
print(strans_int) - 列表:列表可以包含任意种类的数据来下和任意数量,创建也非常容易,把不同的变量放入方括号中用逗号隔开
price_li = [399, 4369, 539, 288, 109, 749, 235, 190, 99, 1000]
获取列表第一个元素price_li[0]就可以拿到了,中括号里面放索引值就好了。
修改列表第一个元素的值price_li[0] = 111 - 字典:又叫键值对,每一个值都对应一个键(key),key必须是唯一的,但值不用也可以使用任意类型
info_dict = {'name': '张三', 'age': 21}
print(info_dict) # 把整个字典中的数据都输出出来
print(info_dict['name']) # 把整个字典中key叫‘name’的值给输出出来
循环提取出字典中全部的key和value
for key, value in info_dict.items():
print(key, value)
4.条件语句和循环语句
条件语句可以使符合条件的时候执行某部分代码,条件为布尔值,也就是只有true和false两个值,条件不成立执行else后面的语句
if jx != 'Y':
print(jx)
else :
print(jx)
如果需要判断有多种条件,就需要用到elif
if select == '1':
list.append(cardtool.insertcard())
print('名片新增成功!')
elif select == '2':
cardtool.allcard(list)
elif select == '3':
cardtool.querycard(list)
else:
print('谢谢使用,系统已退出!')
5.循环语句可以让我们执行一个代码段多次,循环分为for和while
for可以在给定的顺序下重复执行
for key, value in info_dict.items():
print(key, value)
while循环能不断重复执行只需要满足一定条件
while True:
print(*)
6.函数:在代码少的时候可以按照逻辑写完就能够很好的运行。但是如果代码变得庞大复杂起来,就需要自己定义一些函数把代码分给成一个个方块,使代码易读,可以重复使用,并容易调整顺序
一个函数包括输入参数和输出参数
def function(x):
y=x+1
return y
#调用函数
num=10
sum = function(num)
7.面向对象编程
介绍面向对象之前先说一下面向过程,面向过程编程的意思是根据业务逻辑从上到下写代码,这个最容易被初学者接受。需要那段代码写下来就好了。
随着时间的推移,在编程的方式上又发展出了函数式编程,把某些功能封装到函数中,需要用的时候可以直接调用,不用重复写,节省了编码的时间。
随着时间的推移,又出现了面向对象编程。面向对象编程是把函数进行分类和分装后放入对象中,是得开发更快更强。
class Person:
def init(self, name, age): # 类的构造方法
self.name = name
self.age = age
def datail(self):   # 通过self调用被封装的内容

    print(self.name)

    print(self.age)
obj1 = Person('张三', 19)
obj1.datail()
如果各个函数之间独立且无公共数据,就选用函数式编程;如果各个函数之间有一点更多关联性,那么就选用面向对象编程比较好
1.封装:封装分两步:第一步为封装内容,第二部为调用被封装的内容
点击查看代码
class Person:

    def __init__(self, name, age):

        self.name = name

        self.age = age

    def datail(self):  # 通过self调用被封装的内容

        print(self.name)

        print(self.age)

# 调用

obj1 = Person('张三', 19)

obj1.datail()
2.继承是以普通的类为基础建立专门的类对象。子继承了父的某些特性
点击查看代码
class Animal:

    def eat(self):

        print("%s 吃" % self.name)

    def drink(self):

        print("%s 喝" % self.name)

    def shit(self):

        print("%s 拉" % self.name)

    def pee(self):

        print("%s 撒" % self.name)

class Cat(Animal):

    def __init__(self, name):

        self.name = name

    def cry(self):

        print("喵喵叫")

class Dog(Animal):

    def __init__(self, name):

        self.name = name

    def cry(self):

        print("汪汪叫")
# 编写一个简单的爬虫
点击查看代码
import requests  # 最简单易用的HTTP库

from bs4 import BeautifulSoup   # lxml解析网页

# 获取页面

link = "http://www.santostang.com/"

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'}

r = requests.get(link, headers=headers)

print(r.text)

# 抓取数据

soup = BeautifulSoup(r.text, "html.parser")

title = soup.find("h1", class_="post-title").a.text.strip()

print(title)

# 存储数据

with open('title.txt', "a+") as f:

    f.write(title)

    f.close()
python网络爬虫-python基础(三)的更多相关文章
- 03.Python网络爬虫第一弹《Python网络爬虫相关基础概念》
爬虫介绍 引入 之前在授课过程中,好多同学都问过我这样的一个问题:为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的 ...
- Python网络爬虫第一弹《Python网络爬虫相关基础概念》
爬虫介绍 引入 之前在授课过程中,好多同学都问过我这样的一个问题:为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的 ...
- Python爬虫《Python网络爬虫相关基础概念》
引入 之前在授课过程中,好多同学都问过我这样的一个问题:为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的应用还是从 ...
- 03,Python网络爬虫第一弹《Python网络爬虫相关基础概念》
爬虫介绍 引入 为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的应用还是从就业上. 我们都知道,当前我们所处的时代 ...
- 《Python网络爬虫相关基础概念》
爬虫介绍 引入 之前在授课过程中,好多同学都问过我这样的一个问题:为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的 ...
- 爬虫(二)Python网络爬虫相关基础概念、爬取get请求的页面数据
什么是爬虫 爬虫就是通过编写程序模拟浏览器上网,然后让其去互联网上抓取数据的过程. 哪些语言可以实现爬虫 1.php:可以实现爬虫.php被号称是全世界最优美的语言(当然是其自己号称的,就是王婆 ...
- Python网络爬虫相关基础概念
什么是爬虫 爬虫就是通过编写程序模拟浏览器上网,然后让其去互联网上抓取数据的过程. 哪些语言可以实现爬虫 1.php:可以实现爬虫.php被号称是全世界最优美的语言(当然是其自己号称的,就是王婆 ...
- python网络爬虫笔记(三)
一.切片和迭代 1.列表生成式 2.生成器的generate,但是generate保存的是算法,所以可以迭代计算,没有必要,每次调用generate 二.iteration 循环 1.凡是作用于for ...
- Python网络爬虫与信息提取笔记
直接复制粘贴笔记发现有问题 文档下载地址//download.csdn.net/download/hide_on_rush/12266493 掌握定向网络数据爬取和网页解析的基本能力常用的 Pytho ...
随机推荐
- 【LeetCode】4. Median of Two Sorted Arrays 寻找两个正序数组的中位数
作者: 负雪明烛 id: fuxuemingzhu 个人博客: http://fuxuemingzhu.cn/ 公众号:负雪明烛 本文关键词:数组,中位数,题解,leetcode, 力扣,python ...
- 【LeetCode】535. Encode and Decode TinyURL 解题报告(Python & C++)
作者: 负雪明烛 id: fuxuemingzhu 个人博客: http://fuxuemingzhu.cn/ 目录 题目描述 解题方法 方法一:数组 方法二:字典 日期 题目地址:https://l ...
- Typec转HDMI+VGA+PD3.0+USB3.0扩展坞四合一芯片方案|CS5268替代AG9321
CS5268是一种高度集成的单芯片,适用于多个细分市场和显示应用,如拓展坞.扩展底座等. 2.CS5268参数说明 总则 USB Type-C规范1.2 HDMI规范v2.0b兼容发射机,数据速率高达 ...
- 排列组合 "n个球放入m个盒子m"问题 总结
求,盒子都可以分成是否不能区分,和能区分,还能分成是否能有空箱子,所以一共是8种情况,我们现在来一一讨论. 1.球同,盒不同,无空箱 C(n-1,m-1), n>=m0, n<m 使用插板 ...
- 【MySQL作业】多表连接查询——美和易思多表连接查询应用习题
点击打开所使用到的数据库>>> 1.获取订单 ID 为 4 的订购明细信息,要求输出商品名.单价和件数. 连接三张表:订单表.订单明细表和商品表. select goodsName ...
- 编写Java程序,使用PreparedState实现对英雄数据的新增、删除和更新
返回本章节 返回作业目录 需求说明: 使用PreparedState实现对英雄数据的新增.删除和更新 英雄(t_hero)表结构 列名(含义) 数据类型 约束 id (序号) int 主键,自动增长 ...
- Hive安装Version2.1.0
Hive安装,基于版本2.1.0, 使用apache-hive-2.1.0-bin.tar.gz安装包. 1.安装规划 角色规划 IP/机器名 安装软件 运行进程 hive zdh-9 hive Ru ...
- CF858D Polycarp's phone book
题意翻译 有 n 个长度为 9 且只包含数字字符互不相同的串. 需要对于每个串找到一个长度最短的识别码,使得这个识别码当且仅当为这个串的子串. 题目分析 因为范围不是非常大,所以可以将子串筛出来 然后 ...
- .NetCore下构建自己的文件服务管理(UosoOSS)
Web开发系统文件默认存储在wwwroot目录下面,现在越来越多的系统服务化了,UI也更加多元化,当然文件可以用第三方的文件服务,但是这里准备文件分离出来构建自己的文件服务配合数据库表来实现(Uoso ...
- android 解决报错 installation failed with message Failed to finalize session : INSTALL_PARSE_FAILED_UNEXPECTED_EXCEPTION: Failed parse during installPackageLI: Failed to read manifest from /xx/xx/xx.apk
新工程启动报错 怎么办? 解决: 将这个选项去掉勾选后点击ok即可