
python爬虫(七) mozillacookiejar
MozillaCookiejar
保存百度得Cookiejar信息:
from urllib import request

from urllib import parse

from http.cookiejar import MozillaCookieJar

# 保存在本地

cookiejar=MozillaCookieJar('cookie.txt')

handler=request.HTTPCookieProcessor(cookiejar)

opener=request.build_opener(handler)

# 打开百度,此时已将信息保存在了cookiejar中

resp=opener.open('http://www.baidu.com/')

# 下载在本地

cookiejar.save()
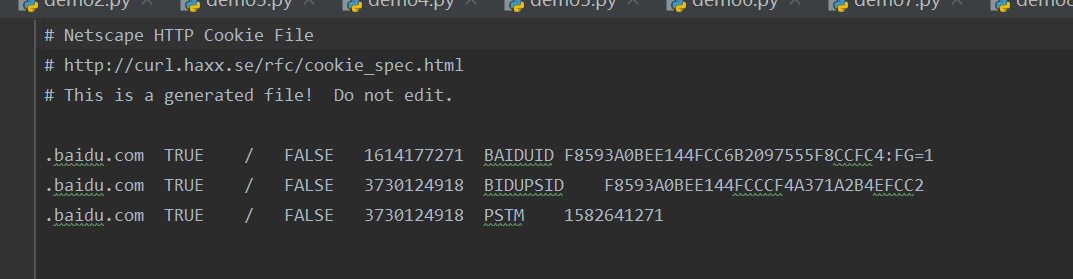
如果通过网址:hyypbin.org中得一个连接来自定义cookie信息,然后再代码中引用这个新的网址,那么下载在本地得cookie.txt为空,因为在cookie信息会在我们结束浏览时过期,如果想浏览刚刚使用得cookie信息,我们可以在代码得save函数中写
cookiejar.save(ignore_discard=True)
如果想把我们过期得cookie得信息打印出来,使用load函数
cookiejar.load(ignore_discard=True)
然后再加上
for cookie in cookiejar:

    print(cookie)
python爬虫(七) mozillacookiejar的更多相关文章
- Python 爬虫七 Scrapy
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- python爬虫(七)_urllib2:urlerror和httperror
urllib2的异常错误处理 在我们用urlopen或opener.open方法发出一个请求时,如果urlopen或opener.open不能处理这个response,就产生错误. 这里主要说的是UR ...
- Python爬虫实战七之计算大学本学期绩点
大家好,本次为大家带来的项目是计算大学本学期绩点.首先说明的是,博主来自山东大学,有属于个人的学生成绩管理系统,需要学号密码才可以登录,不过可能广大读者没有这个学号密码,不能实际进行操作,所以最主要的 ...
- Python爬虫入门七之正则表达式
在前面我们已经搞定了怎样获取页面的内容,不过还差一步,这么多杂乱的代码夹杂文字我们怎样把它提取出来整理呢?下面就开始介绍一个十分强大的工具,正则表达式! 1.了解正则表达式 正则表达式是对字符串操作的 ...
- 孤荷凌寒自学python第七十九天开始写Python的第一个爬虫9并使用pydocx模块将结果写入word文档
孤荷凌寒自学python第七十九天开始写Python的第一个爬虫9 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 到今天终于完成了对docx模块针对 ...
- 孤荷凌寒自学python第七十八天开始写Python的第一个爬虫8
孤荷凌寒自学python第七十八天开始写Python的第一个爬虫8 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 到今天止基本完成了对docx模块针 ...
- 孤荷凌寒自学python第七十七天开始写Python的第一个爬虫7
孤荷凌寒自学python第七十七天开始写Python的第一个爬虫7 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 今天的学习仍然是在纯粹对docx模 ...
- 孤荷凌寒自学python第七十六天开始写Python的第一个爬虫6
孤荷凌寒自学python第七十六天开始写Python的第一个爬虫6 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 不过由于对python-docx模 ...
- 孤荷凌寒自学python第七十五天开始写Python的第一个爬虫5
孤荷凌寒自学python第七十五天开始写Python的第一个爬虫5 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
- 孤荷凌寒自学python第七十四天开始写Python的第一个爬虫4
孤荷凌寒自学python第七十四天开始写Python的第一个爬虫4 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
随机推荐
- 传奇脚本中 SendMsg 编号说明
0 1 2 3 4 5 60对全服人说1.发送普通红色广播信息. 2.发送普通红色广播信息,并显示NPC名称. 3.发送普通红色广播信息,并人物NPC名称. 4.在NPC头顶,显示普通说话信息. 5. ...
- dk7和jdk8的一些新特性
本文是我学习了解了j 的一些资料,有兴趣的大家可以浏览下下面的内容. 官方文档:http://www.oracle.com/technetwork/java/javase/jdk7-relnotes- ...
- c# pcm
using System; using System.IO; using System.Text; using System.Windows.Forms; using System.Runtime.I ...
- python接口自动化测试 - unittest框架基本使用
unittest简单介绍 单元测试框架 还可以适用WEB自动化测试用例的开发与执行 提供丰富的断言方法 官方文档:https://docs.python.org/zh-cn/3/library/uni ...
- 连通数[JSOI2010]-洛谷T4306
咕咕咕 tarjan+拓排应该是正解吧 然而我上去就打了个tarjan和dijkstra (由于我抄题解抄多了,代码能力极差,于是我就gg了) 题解中有大佬直接用dfs过了8个点,再吸口氧就AC了 ( ...
- js 判断回文字符串
回文字符串:字符串从前往后读和从后往前读字符顺序是一致的. 判断一个字符串是不是回文字符串 function isPalindrome(str) { var str1 = str.split(''). ...
- java比较时间的方法
一.通过compareTo Date date = new Date(1576118709574L); Date date1 = new Date(1576118709574L); Date date ...
- 【笔记3-用户模块】从0开始 独立完成企业级Java电商网站开发(服务端)
数据表结构设计 关系设计 为什么不用外键? 分库分表有外键会非常麻烦,清洗数据也很麻烦.数据库内置触发器也不适合采用. 查业务问题的后悔药--时间戳 create_time 数据创建时间 update ...
- C#加密解密(AES)-AESHelper
原文地址:https://ken.io/note/csharp-aesencrypt using System; namespace Encrypt { public class AESHelper ...
- Dism++ 更新管理提示“无法连接服务器”
Dism++ 更新管理提示"无法连接服务器" 下载wsusscn3.cab,放入Dism++安装目录下Config文件夹中.