
论文阅读笔记二十八:You Only Look Once: Unified,Real-Time Object Detection(YOLO v1 CVPR2015)
论文源址:https://arxiv.org/abs/1506.02640
tensorflow代码:https://github.com/nilboy/tensorflow-yolo
摘要
该文提出一种新的目标检测网络,yolo,以前的目标检测问题偏向于分类,而本文将目标检测看作是带有类别分数的回归问题。yolo从整张图上预测边界框和类别分数。是单阶段网络,可以进行端到端的训练。yolo处理速度十分迅速,每秒处理45帧图片。yolo在准确率上有待提升,但很少预测出假正的样例。
介绍
yolo的结构十分简洁,如下,一个单独的卷积网络,用于预测框的边界及每个框的类别概率 。相比传统的目标检测方式,yolo有以下几点优点:(1)速度十分快,可以适用于视频流的输入。(2)yolo对图片整体进行推理预测,而不是像基于窗口滑动的区域框的方式。由于yolo在训练和测试时是对整张图片进行分析,因此可以像编码外形信息一样对类别等抽象信息进行编码。Fast R-CNN有时会将背景误分类为目标,是因为不够多的上下文信息,而YoLo可以减少一般的这种错误情形。(3)YoLo学习的是整体的表示特征,对于新的输入,YoLOh还是有效的。
准确率上,YOLO仍有待提升,虽然速度快,但对目标尤其是小目标位置的精确定位相比最好的检测方法仍存在差距。

方法
本文应用整个图片的特征预测每个边界框。可以同时预测所有类别的边界框。Yolo对整个图片和图片中的目标进行分析,YoLO的设计可以在保持较高平均准确率的基础上实时的进行预测,同时,可以进行端到端的训练。
Yolo将输入图片分为大小为SxS的格子,如果目标的中心落在了格子里,则这个格子就负责该目标的检测任务。每个网格单元预测B个边界框及对应的分数,表示该单元包含目标物体的置信度confident,同时,输出预测类别的分数。将置信度定义如下,
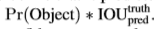
每个bounding box的预测5个值,(x,y,w,h)及confident,(x,y)为bounding box 的中心(相对于每个网格单元的偏移),预测出相对于整张图片的宽和高。
每个网格单元预测c个类别的条件概率,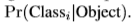 概率的计算的前提是,该网格单元包含目标物体。对于每个网格单元,不关预测出的B个bounding box,直接得到一系列类别的概率。
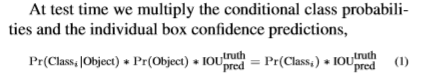
基于上式,可以得到每个框确定目标的confident 分数,同时,这个值也代表预测类别的准确率及预测框对目标物的符合程度。
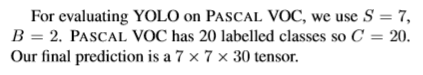
网络结构
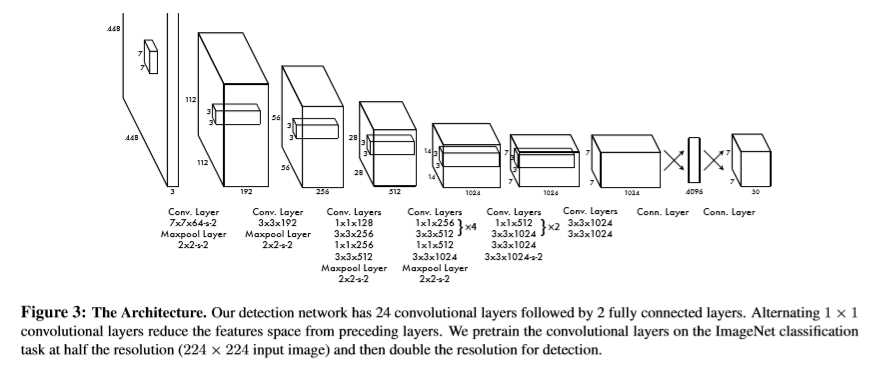
模型为一个卷积网络,卷积层用于提取图像的特征,全连接层用于输出坐标和类别概率。该模型含有24层卷积层外加两层全连接层。结构如下
网络的训练
该文在ImageNet上预训练卷积网络,后增加4层卷积和两层全连接层,基于随机初始化操作。将预测框的宽和高用图片的原宽和高做归一化处理。将中心(x,y)作为单独网格单元的偏移量。本文对方差和误差进行优化处理,但由于参考了定位误差与类别误差,而许多bounding box中并未包含目标物,会使confidence变为0,从而对包含目标的检测误差的求导有影响,可能会导致收敛提前终止,进而 导致模型不稳定。
因此,本文增加了预测框损失的权重,而减少不包含目标的预测框损失的权重。在和平方误差中,大框和小框的误差权重是相同的。相比大框下的小偏差,小框的小偏差影响是较大的。因此,将预测边界框宽和高的平方根,而不是其直接得到的宽和高。

yolo对每个网格单元预测多个边界框,但训练时,只希望针对每个目标物体得到一个边界框预测器。该文将预测出的bounding box与ground truth IOU值最高的作为此目标的预测器。本文优化的损失函数如下:
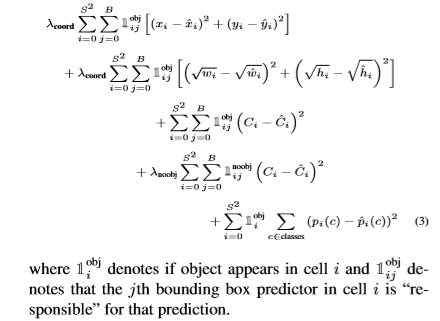
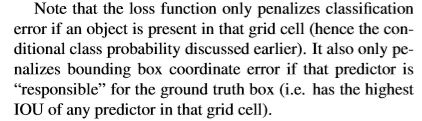
注意:只惩罚存在目标的网格单元的类别损失和对应负责检测目标边界框预测器的框损失函数,原文如下。
为防止过拟合,本文采用dropout和数据增强操作。
yolo的限制因素
yolo对增强了预测框的空间限制,因为,每个网格单元只能预测两个边界框,及一个类别,因此,yolo对相邻目标的检测有点难度,像鸟群等小目标的检测。yolo直接从数据中学习并预测边界框,对非正常宽高比的物体检测效果不是很好,yolo网络中包含很多下采样层,对特征的学习不是很精细,对检测结果造成一定影响。对于损失函数,大物体与小物体的IOU对损失的贡献度相差不大,对于小物体,很小的IOU也会对网络造成很大影响,影响检测的结果。
实验
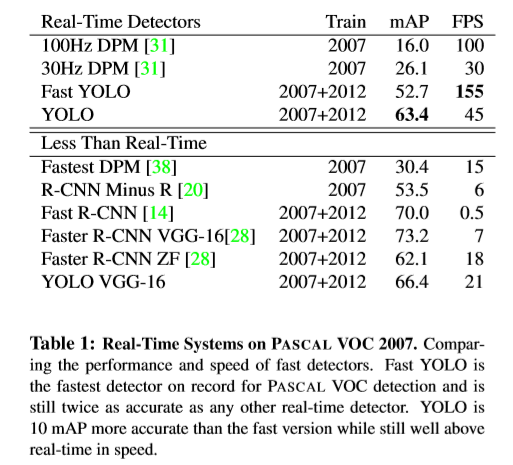
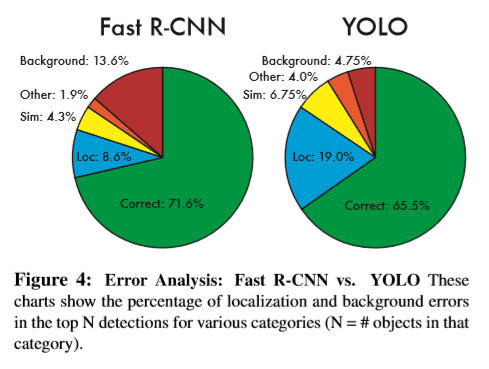
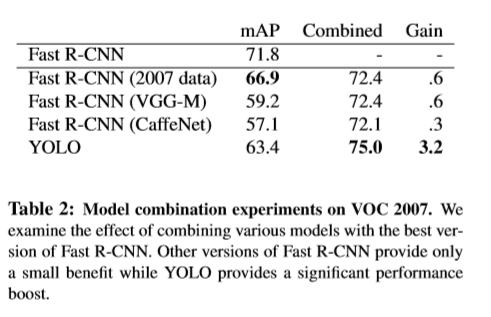
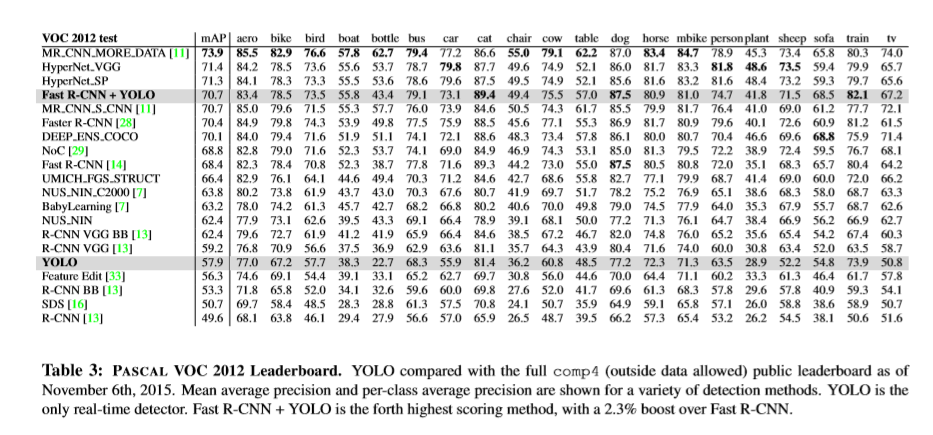
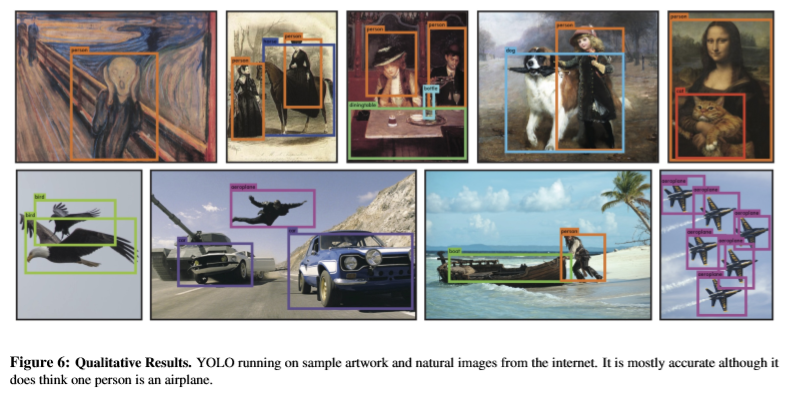
参考
[1] M. B. Blaschko and C. H. Lampert. Learning to localize objects with structured output regression. In Computer Vision– ECCV 2008, pages 2–15. Springer, 2008. 4
[2] L. Bourdev and J. Malik. Poselets: Body part detectors trained using 3d human pose annotations. In International Conference on Computer Vision (ICCV), 2009. 8
[3] H. Cai, Q. Wu, T. Corradi, and P. Hall. The crossdepiction problem: Computer vision algorithms for recognising objects in artwork and in photographs. arXiv preprint arXiv:1505.00110, 2015. 7
论文阅读笔记二十八:You Only Look Once: Unified,Real-Time Object Detection(YOLO v1 CVPR2015)的更多相关文章
- 论文阅读笔记四十八:Bounding Box Regression with Uncertainty for Accurate Object Detection(CVPR2019)
论文原址:https://arxiv.org/pdf/1809.08545.pdf github:https://github.com/yihui-he/KL-Loss 摘要 大规模的目标检测数据集在 ...
- 论文阅读笔记(十八)【ITIP2019】:Dynamic Graph Co-Matching for Unsupervised Video-Based Person Re-Identification
论文阅读笔记(十七)ICCV2017的扩刊(会议论文[传送门]) 改进部分: (1)惩罚函数:原本由两部分组成的惩罚函数,改为只包含 Sequence Cost 函数: (2)对重新权重改进: ① P ...
- 论文阅读笔记五十八:FoveaBox: Beyond Anchor-based Object Detector(CVPR2019)
论文原址:https://arxiv.org/abs/1904.03797 摘要 FoveaBox属于anchor-free的目标检测网络,FoveaBox直接学习可能存在的图片种可能存在的目标,这期 ...
- 论文阅读笔记二十九:SSD: Single Shot MultiBox Detector(ECCV2016)
论文源址:https://arxiv.org/abs/1512.02325 tensorflow代码:https://github.com/balancap/SSD-Tensorflow 摘要 SSD ...
- 论文阅读笔记二十五:Spatial Pyramid Pooling in Deep Convolutional Networks for Visual Recognition(SPPNet CVPR2014)
论文源址:https://arxiv.org/abs/1406.4729 tensorflow相关代码:https://github.com/peace195/sppnet 摘要 深度卷积网络需要输入 ...
- 论文阅读笔记二十四:Rich feature hierarchies for accurate object detection and semantic segmentation Tech report(R-CNN CVPR2014)
论文源址:http://www.cs.berkeley.edu/~rbg/#girshick2014rcnn 摘要 在PASCAL VOC数据集上,最好的方法的思路是将低级信息与较高层次的上下文信息进 ...
- 论文阅读笔记三十八:Deformable Convolutional Networks(ECCV2017)
论文源址:https://arxiv.org/abs/1703.06211 开源项目:https://github.com/msracver/Deformable-ConvNets 摘要 卷积神经网络 ...
- 论文阅读笔记二十六:Fast R-CNN (ICCV2015)
论文源址:https://arxiv.org/abs/1504.08083 参考博客:https://blog.csdn.net/shenxiaolu1984/article/details/5103 ...
- 论文阅读笔记二十二:End-to-End Instance Segmentation with Recurrent Attention(CVPR2017)
论文源址:https://arxiv.org/abs/1605.09410 tensorflow 代码:https://github.com/renmengye/rec-attend-public 摘 ...
随机推荐
- 解决 Qt5 报错 This application failed to start because it could not find or load the Qt platform plugin
QT为了简化生成发布版本,特别提供了工具 "windeplayqt.exe",这个工具在 "...\Qt5.8.0\5.8\msvc2015_64\bin"的目 ...
- openstack Q版部署-----虚拟机创建(8)
一 .创建网络环境 环境变量生效一下 创建一个网络: openstack network create --share --external \ --provider-physical-network ...
- java中的进程与线程及java对象的内存结构【转】
原文地址:http://rainforc.iteye.com/blog/2039501 1.实现线程的三种方式: 使用内核线程实现 内核线程(Kernel Thread, KLT)就是 ...
- JavaScript-DOM(重点)
解析过程 DOM树(一切皆是节点) DOM可以做什么 清楚DOM的结构 获取其它DOM(事件源)的三种方式 事件 事件的三要素 绑定事件的方式 JavaScript入口函数 window.onload ...
- V4L2 API详解 <二> Camera详细设置【转】
转自:http://blog.sina.com.cn/s/blog_602f87700101bf36.html 作者: Sam (甄峰) sam_code@hotmail.com Camera的 ...
- flask与数据库连接相关操作
---恢复内容开始--- 首先要安装 flask-sqlalchemy 数据库连接设置 在flask-SQLAlchemy中,数据库使用URL指定,而且程序使用的数据库必须保存到flask配置对象的 ...
- python3+selenium入门16-窗口截图
有时候需要把一些浏览器当前窗口截图下来,比如操作抱错的时候.WebDriver类下.get_screenshot_as_file()方法可窗口截图,需要传入一个截图文件名的路径.window要用\\当 ...
- VUE环境部署
npm install vue-router --save 下载node.js安装https://nodejs.org/en/ npm install -g cnpm --registry=http ...
- [Codeforces671D]Roads in Yusland
[Codeforces671D]Roads in Yusland Tags:题解 题意 luogu 给定以1为根的一棵树,有\(m\)条直上直下的有代价的链,求选一些链把所有边覆盖的最小代价.若无解输 ...
- 第六章 MVC之 FileResult和JS请求二进制流文件
一.FileResult 1.简介 表示一个用于将二进制文件内容发送到响应的基类.它有三个子类: FileContentResultFilePathResultFileStreamResult 推荐阅 ...