
Forward团队-爬虫豆瓣top250项目-开发文档
项目地址:https://github.com/xyhcq/top250
我在本次项目中负责写爬虫中对数据分析的一部分,根据马壮分析过的html,我来进一步写代码获取数据,具体的功能及实现方法我已经写在了注释里:
首先,通过访问要爬的网站,并将网站保存在变量里,为下一步数据分析做准备
def getData(html):

    # 分析代码信息,提取数据

    soup = BeautifulSoup(html, "html.parser")
这时,如果我们print soup,是会在窗口上显示出网站的源代码的。
先把第一部电影信息的源代码放这,便于理解

首先,我们要爬取电影名字,我们经过分析(网页代码层次还是比较清晰的)
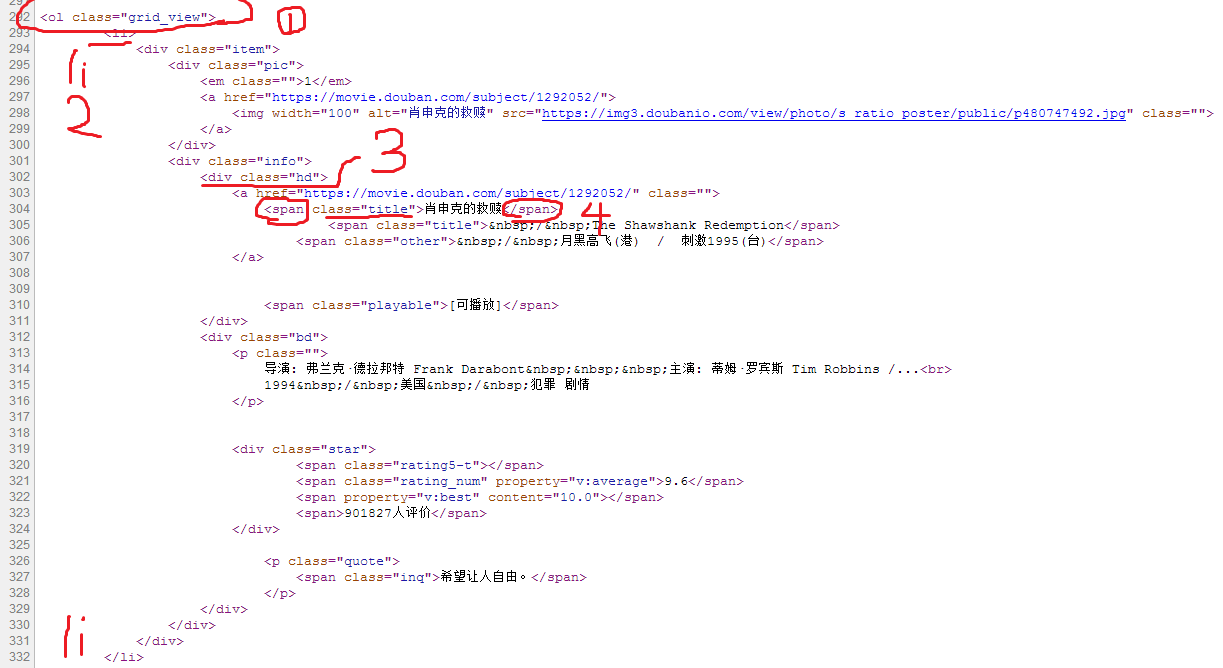
然后就可以写出爬取名字的部分了,
    # 找到第一个class属性值为grid_view的ol标签

    movieList=soup.find('ol',attrs={'class':'grid_view'})

    # 找到所有的li标签

    for movieLi in movieList.find_all('li'):

        # 找到第一个class属性值为hd的div标签

        movieHd=movieLi.find('div',attrs={'class':'hd'})

        # 找到第一个class属性值为title的span标签

        # 获取电影名字

        movieName=movieHd.find('span',attrs={'class':'title'}).getText()

        print movieName
经过运行,名字也确实能爬去并显示了,然后我们还是按照这种找标签的方法,以此类推,就能抓取其他的信息了:
        # 获取电影链接

        movieUrl=movieHd.find('a class="" href="')

        print movieUrl

        # 获取电影导演/演员

        movieBd = movieLi.find('div', attrs={'class': 'bd'})

        movieSF=movieBd.find('p',attrs={'class':''}).getText()

        print movieSF

        # 获取电影的评分

        movieScore=movieLi.find('span',attrs={'class':'rating_num'}).getText()

        print movieScore

        #获取电影的评论数

        movieEval=movieLi.find('div',attrs={'class':'star'})

        movieEvalNum=re.findall(r'\d+',str(movieEval))[-1]

        print movieEvalNum
这里要说一下,如果找不到标签,有时候程序会卡住不动,排查发现问题出在简评上,所以;
        # 获取电影短评

        movieQuote = movieLi.find('span', attrs={'class': 'inq'})

        # 有的电影没有短评,为防止报错,加次

        if(movieQuote):

            print movieQuote.getText()

        else:

            print ('没有短评!')

Forward团队-爬虫豆瓣top250项目-开发文档的更多相关文章
- 《Forward团队-爬虫豆瓣top250项目-开发文档》
码云地址:https://github.com/xyhcq/top250 模块功能:获取豆瓣top250网页的源代码,并分析. def getHTMLText(url,k): # 获取网页源代码 tr ...
- Forward团队-爬虫豆瓣top250项目-设计文档
组长地址:http://www.cnblogs.com/mazhuangmz/p/7603594.html 成员:马壮,李志宇,刘子轩,年光宇,邢云淇,张良 设计方案: 1.能分析HTML语言: 2. ...
- 《Forward团队-爬虫豆瓣top250项目-设计文档》
成员:马壮,李志宇,刘子轩,年光宇,邢云淇,张良 设计方案: 1.能分析HTML语言: 2.提取重要数据,并保存为文本文档: 3.用PY代码调取文本文档的数据: 4.编写提取部分数据的python代码 ...
- 爬虫豆瓣top250项目-开发文档
项目托管平台地址:https://github.com/gengwenhao/GetTop250.git 负责内容:1.使用python的request库先获取网页内容下来 2.再使用一个好用的lxm ...
- Forward团队-爬虫豆瓣top250项目-项目总结
托管平台地址:https://github.com/xyhcq/top250 小组名称:Forward团队 组长:马壮 成员:李志宇.刘子轩.年光宇.邢云淇.张良 我们这次团队项目内容是爬取豆瓣电影T ...
- Forward团队-爬虫豆瓣top250项目-最终程序
托管平台地址:https://github.com/xyhcq/top250 小组名称:Forward团队 小组成员合照: 程序运行方法: 在python中打开程序并运行:或者直接执行程序即可运行 程 ...
- Forward团队-爬虫豆瓣top250项目-项目进度
项目地址:https://github.com/xyhcq/top250 我们的项目是爬取豆瓣top250的电影的信息,在做这个项目前,我们都没有经验,完全是从零开始,过程中也遇到了很多困难,不过我们 ...
- Forward团队-爬虫豆瓣top250项目-模块测试
项目托管平台地址:https://github.com/xyhcq/top250 模块测试:爬虫对信息的处理部分 测试方法: 实际运行一下代码: 可以看见,信息都已经爬取出来了 其他补充说明: 原本系 ...
- Forward团队-爬虫豆瓣top250项目-模块开发过程
项目托管平台地址:https://github.com/xyhcq/top250 开发模块功能: 爬虫对信息的处理部分 开发时间:5天的下午空余时间(每天大约1小时,边学模块的使用边开发) 实现了:爬 ...
随机推荐
- Systemd 教程
目录 Systemd 教程 sshd.service配置模板 开机启动 启动服务 停止服务 配置文件 [Unit] 区块:启动顺序与依赖关系 [Service] 区块:启动行为 1.启动命令 2.启动 ...
- C#窗体-猜数字
1.用到的控件:groupbox.label.textbox.button.menustrip等 2.实现的功能,随机产生一个数字,输入自己猜的答案,判断是否猜对. 3.运行结果 4.代码 using ...
- django RESTful设计方法
1. 域名 应该尽量将API部署在专用域名之下. https://api.example.com 如果确定API很简单,不会有进一步扩展,可以考虑放在主域名下. https://example.org ...
- 淘宝API对接实例
以为公司祖传代码太多使用的PHP5.4.45版本,所以无法使用SDK包,只能原生自己写,踩了不少坑. 1.授权 https://oauth.taobao.com/authorize?response_ ...
- mysql关闭groupby模式
Mysql5.7 出现 SELECT list is not in GROUP BY clause and contains nonaggregated column ‘sss.month_id’ w ...
- php socket多进程简单服务器(一)
进程,线程 IO复用,协程都是处理完成并发的方式 socket分为 三步 服务器监听,客户端请求,连接确认, 每次连接都由当前进程来处理,可以通过IO复用来解决这个问题, 这次通过进程来完成并发请 ...
- 带缓冲I/O 和不带缓冲I/O的区别与联系
首先要明白不带缓冲的概念:所谓不带缓冲,并不是指内核不提供缓冲,而是只单纯的系统调用,不是函数库的调用.系统内核对磁盘的读写都会提供一个块缓冲(在有些地方也被称为内核高速缓存),当用write函数对其 ...
- Saliency Detection via Graph-Based Manifold Ranking
Saliency Detection via Graph-Based Manifold Ranking https://www.yuque.com/lart/papers 本文不是按照之前的论文那样, ...
- js中的回调函数 和promise解决异步操作中的回调地狱问题。
回调函数 : 函数作为参数传递到另外一个函数中.简单数据类型和引入数据类型中的数组和对象作为参数传递大家肯定都不陌生,其实引用数据类型中的函数也是可以的. 事实上大家见到的很多,用到的也很多,比如jQ ...
- 一张图说明TCP和UCP协议
图片来自网络. 本来不想打字了,但是博客园有字数限制... 第一次 第一次握手:建立连接时,客户端发送syn包(syn=j)到服务器,并进入SYN_SENT状态,等待服务器确认:SYN:同步序列编号( ...