
HDFS文件操作
hadoop装好后,文件系统中没有任何目录与文件
1、 创建文件夹
hadoop fs -mkdir -p /hkx/learn
参数-p表示递归创建文件夹
2、 浏览文件
hadoop fs -ls /
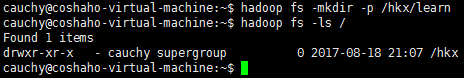
3、 上传本地文件到HDFS
hadoop fs -put word.txt /hkx/learn
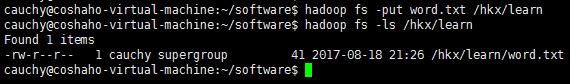
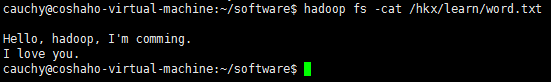
4、 查看文件
hadoop fs -cat /hkx/learn/word.txt
HDFS Shell命令介绍文章很多,这里就不一一列举了,引用一篇文章来介绍:https://segmentfault.com/a/1190000002672666
命令基本格式:
hadoop fs -cmd < args >
1.ls
hadoop fs -ls /
列出hdfs文件系统根目录下的目录和文件
hadoop fs -ls -R /
列出hdfs文件系统所有的目录和文件
2.put
hadoop fs -put < local file > < hdfs file >
hdfs file的父目录一定要存在,否则命令不会执行
hadoop fs -put < local file or dir >...< hdfs dir >
hdfs dir 一定要存在,否则命令不会执行
hadoop fs -put - < hdsf file>
从键盘读取输入到hdfs file中,按Ctrl+D结束输入,hdfs file不能存在,否则命令不会执行
2.1.moveFromLocal
hadoop fs -moveFromLocal < local src > ... < hdfs dst >
与put相类似,命令执行后源文件 local src 被删除,也可以从从键盘读取输入到hdfs file中
2.2.copyFromLocal
hadoop fs -copyFromLocal < local src > ... < hdfs dst >
与put相类似,也可以从从键盘读取输入到hdfs file中
3.get
hadoop fs -get < hdfs file > < local file or dir>
local file不能和 hdfs file名字不能相同,否则会提示文件已存在,没有重名的文件会复制到本地
hadoop fs -get < hdfs file or dir > ... < local dir >
拷贝多个文件或目录到本地时,本地要为文件夹路径
注意:如果用户不是root, local 路径要为用户文件夹下的路径,否则会出现权限问题,
3.1.moveToLocal
当前版本中还未实现此命令
3.2.copyToLocal
hadoop fs -copyToLocal < local src > ... < hdfs dst >
与get相类似
4.rm
hadoop fs -rm < hdfs file > ...

hadoop fs -rm -r < hdfs dir>...
每次可以删除多个文件或目录
5.mkdir
hadoop fs -mkdir < hdfs path>
只能一级一级的建目录,父目录不存在的话使用这个命令会报错
hadoop fs -mkdir -p < hdfs path>
所创建的目录如果父目录不存在就创建该父目录
6.getmerge
hadoop fs -getmerge < hdfs dir > < local file >
将hdfs指定目录下所有文件排序后合并到local指定的文件中,文件不存在时会自动创建,文件存在时会覆盖里面的内容
hadoop fs -getmerge -nl < hdfs dir > < local file >
加上nl后,合并到local file中的hdfs文件之间会空出一行
7.cp
hadoop fs -cp < hdfs file > < hdfs file >
目标文件不能存在,否则命令不能执行,相当于给文件重命名并保存,源文件还存在
hadoop fs -cp < hdfs file or dir >... < hdfs dir >
目标文件夹要存在,否则命令不能执行
8.mv
hadoop fs -mv < hdfs file > < hdfs file >
目标文件不能存在,否则命令不能执行,相当于给文件重命名并保存,源文件不存在
hadoop fs -mv < hdfs file or dir >... < hdfs dir >
源路径有多个时,目标路径必须为目录,且必须存在。
注意:跨文件系统的移动(local到hdfs或者反过来)都是不允许的
9.count
hadoop fs -count < hdfs path >
统计hdfs对应路径下的目录个数,文件个数,文件总计大小
显示为目录个数,文件个数,文件总计大小,输入路径
10.du
hadoop fs -du < hdsf path>
显示hdfs对应路径下每个文件夹和文件的大小
hadoop fs -du -s < hdsf path>
显示hdfs对应路径下所有文件和的大小
hadoop fs -du - h < hdsf path>
显示hdfs对应路径下每个文件夹和文件的大小,文件的大小用方便阅读的形式表示,例如用64M代替67108864
11.text
hadoop fs -text < hdsf file>
将文本文件或某些格式的非文本文件通过文本格式输出
12.setrep
hadoop fs -setrep -R 3 < hdfs path >
改变一个文件在hdfs中的副本个数,上述命令中数字3为所设置的副本个数,-R选项可以对一个人目录下的所有目录+文件递归执行改变副本个数的操作
13.stat
hdoop fs -stat [format] < hdfs path >
返回对应路径的状态信息
[format]可选参数有:%b(文件大小),%o(Block大小),%n(文件名),%r(副本个数),%y(最后一次修改日期和时间)
可以这样书写hadoop fs -stat %b%o%n < hdfs path >,不过不建议,这样每个字符输出的结果不是太容易分清楚
14.tail
hadoop fs -tail < hdfs file >
在标准输出中显示文件末尾的1KB数据
15.archive
hadoop archive -archiveName name.har -p < hdfs parent dir > < src >* < hdfs dst >
命令中参数name:压缩文件名,自己任意取;< hdfs parent dir > :压缩文件所在的父目录;< src >:要压缩的文件名;< hdfs dst >:压缩文件存放路径
*示例:hadoop archive -archiveName hadoop.har -p /user 1.txt 2.txt /des
示例中将hdfs中/user目录下的文件1.txt,2.txt压缩成一个名叫hadoop.har的文件存放在hdfs中/des目录下,如果1.txt,2.txt不写就是将/user目录下所有的目录和文件压缩成一个名叫hadoop.har的文件存放在hdfs中/des目录下
显示har的内容可以用如下命令:
hadoop fs -ls /des/hadoop.jar
显示har压缩的是那些文件可以用如下命令
hadoop fs -ls -R har:///des/hadoop.har
注意:har文件不能进行二次压缩。如果想给.har加文件,只能找到原来的文件,重新创建一个。har文件中原来文件的数据并没有变化,har文件真正的作用是减少NameNode和DataNode过多的空间浪费。
16.balancer
hdfs balancer
如果管理员发现某些DataNode保存数据过多,某些DataNode保存数据相对较少,可以使用上述命令手动启动内部的均衡过程
17.dfsadmin
hdfs dfsadmin -help
管理员可以通过dfsadmin管理HDFS,用法可以通过上述命令查看
hdfs dfsadmin -report
显示文件系统的基本数据
hdfs dfsadmin -safemode < enter | leave | get | wait >
enter:进入安全模式;leave:离开安全模式;get:获知是否开启安全模式;
wait:等待离开安全模式
18.distcp
用来在两个HDFS之间拷贝数据
HDFS文件操作的更多相关文章
- Hadoop之HDFS文件操作常有两种方式(转载)
摘要:Hadoop之HDFS文件操作常有两种方式,命令行方式和JavaAPI方式.本文介绍如何利用这两种方式对HDFS文件进行操作. 关键词:HDFS文件 命令行 Java API HD ...
- hadoop的hdfs文件操作实现上传文件到hdfs
这篇文章主要介绍了使用hadoop的API对HDFS上的文件访问,其中包括上传文件到HDFS上.从HDFS上下载文件和删除HDFS上的文件,需要的朋友可以参考下hdfs文件操作操作示例,包括上传文件到 ...
- HDFS文件操作(命令行)
HDFS是一种分布式文件系统,为MapReduce这种框架下的海量数据分布式处理而设计. Hadoop之HDFS文件操作常有两种方式,一种是命令行方式,即Hadoop提供了一套与Linux文件命令类似 ...
- Hadoop之HDFS文件操作
摘要:Hadoop之HDFS文件操作常有两种方式.命令行方式和JavaAPI方式.本文介绍怎样利用这两种方式对HDFS文件进行操作. 关键词:HDFS文件 命令行 Java API HD ...
- JAVA API 实现hdfs文件操作
java api 实现hdfs 文件操作会出现错误提示: Permission denied: user=hp, access=WRITE, inode="/":hdfs:supe ...
- eclipse 对 hadoop1.2.1 hdfs 文件操作
package com.hdfs; import java.io.FileInputStream;import java.io.FileNotFoundException;import java.io ...
- Hadoop HDFS文件操作
1.创建目录 import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.ha ...
- thrift实现HDFS文件操作
thrift 文件如下 namespace java com.pera.file.transform struct File{ 1:string path , 2:string co ...
- [bigdata] 使用Flume hdfs sink, hdfs文件未关闭的问题
现象: 执行mapreduce任务时失败 通过hadoop fsck -openforwrite命令查看发现有文件没有关闭. [root@com ~]# hadoop fsck -openforwri ...
随机推荐
- 解决方案:CS0016: 未能写入输出文件“c:\Windows\Microsoft.NET\Framework64\v4.0.30319\--”--“拒绝访问。 ”
IIS部署的网站打开出现问题: CS0016: 未能写入输出文件“c:\Windows\Microsoft.NET\Framework64\v4.0.30319\Temporary ASP.NET F ...
- jmeter中Implementation中几个选项的区别
在jmeter发送http请求时,Implementation下拉框中有几个选项,如下: 那到底有什么区别呢?发送http请求改用哪种方法呢.百度后查之,没答案.我们还是看官方文档吧.官方文档解释如下 ...
- iOS - 处理计算精度要求很高的数据,floatValue,doubleValue等计算不精确问题
.问题描述:服务器返回的double类型9...94的数字时 .之前处理方式是 :(从内存.cpu计算来说double都是比较合适的,一般情况下都用double) goodsPrice.floatVa ...
- zookeeper 安装的三种模式
Zookeeper安装 zookeeper的安装分为三种模式:单机模式.集群模式和伪集群模式. 单机模式 首先,从Apache官网下载一个Zookeeper稳定版本,本次教程采用的是zookeeper ...
- Ucloud云主机无法yum安装处理办法
Ucloud云主机在yum安装的时候出现这个提示 执行一下命令 yum --disablerepo=salttestyum-config-manager --disable salttestyum-c ...
- 【紫书】 The Falling Leaves UVA - 699 递归得简单
题意:给你一颗二叉树的前序遍历,空子树以-1表示,将左右子树的权值投影到一维数轴上,左儿子位置为根位置-1,右儿子+1求个个整点上的和: 题解:递归,整个过程只需维护一个sum数组. 更新根,更新le ...
- Oracle备份恢复之冷备份恢复与异机还原
(同平台:rhel6.4~rhel6.4:同版本:oracle 11g 11.2.0.1~ oracle 11g 11.2.0.1) 冷备份发生在数据库关闭状态下,直接拷贝物理文件的备份方式,备份数据 ...
- 从url到请求 再到页面生成
百度面试 从url到请求 再到页面生成 - MartinDing - 博客园 https://www.cnblogs.com/martinding/p/7458723.html
- MTU-TCP/IP协议栈-linux kernel-TCP丢包重传-UDP高性能-AI- ip数据报 tcp数据报
1.IP协议首部 TCP报文段的首部 UDP分组结构 ip数据报 tcp数据报 UDP校验 w 报文长度该字段指定UDP报头和数据总共占用的长度.可能的最小长度是8字节,因为UDP报头已经占用了 ...
- sql中rownumber()over()的用法
语法: ROW_NUMBER ( ) OVER ( [ PARTITION BY value_expression , ... [ n ] ] order_by_clause ) 通过语法可以看出 o ...