
mysql数据库优化(四)-项目实战
在flask项目中,防止随着时间的流逝,数据库数据越来越多,导致接口访问数据库速度变慢。所以自己填充数据进行测试及 mysql优化
1.插入数据:
通过脚本,使用多进程,每100次提交数据
import multiprocessing

import time

from flask import Flask

from flask_sqlalchemy import SQLAlchemy

HOST = '127.0.0.1'

USER = "root"

PASSWD = ""

DB = "fwss_dev"

CHARTSET = "utf8"

app = Flask(__name__, instance_relative_config=True)

# 链接数据库路径

app.config['SQLALCHEMY_DATABASE_URI'] = 'mysql://%s:%s@127.0.0.1:3306/%s?charset=%s' % (USER, PASSWD, DB, CHARTSET)

# 如果设置成 True (默认情况),Flask-SQLAlchemy 将会追踪对象的修改并且发送信号。这需要额外的内存, 如果不必要的可以禁用它。

app.config['SQLALCHEMY_TRACK_MODIFICATIONS'] = True

# 如果设置成 True,SQLAlchemy 将会记录所有 发到标准输出(stderr)的语句,这对调试很有帮助。

app.config['SQLALCHEMY_ECHO'] = False

# 数据库连接池的大小。默认是数据库引擎的默认值 (通常是 5)。

app.config['SQLALCHEMY_POOL_SIZE'] = 6

db = SQLAlchemy(app)

def insert(count):

    start = time.time()

    for item in range(50000):

        # time1 = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time_one))

        print(count)

        for it in range(100):

            db.session.execute(

                f"""INSERT INTO order_bang (creator_id,redenvelope,status) VALUES

                                       ({count},12,0,'需要')"""

                # f"INSERT INTO account_realauth (uid,`status`) VALUES({count},2)"

            )

        count += 1

        db.session.commit()

    print((time.time() - start) / 60)

if __name__ == '__main__':

    with app.app_context():

        multiprocessing.Process(target=insert, args=(273256,)).start()

        multiprocessing.Process(target=insert, args=(10273256,)).start()

        multiprocessing.Process(target=insert, args=(20273256,)).start()

        multiprocessing.Process(target=insert, args=(30273256,)).start()
以上只是展示 部分插入数据库的脚本,总共插入数据量如下: 用户表(account_user)110万用户,实名认证表(account_realauth)20万用户,某订单表(order_bang)2023万条。相关表结构如下:

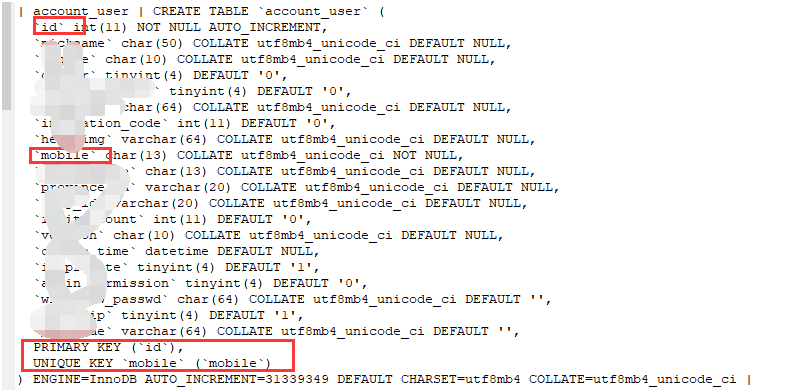
CREATE TABLE `order_bang` (

  `id` int(11) NOT NULL AUTO_INCREMENT,

  `creator_id` int(11) NOT NULL,

  `status` tinyint(4) DEFAULT NULL,

  `create_time` datetime DEFAULT NULL,

  `province_id` char(6) COLLATE utf8mb4_unicode_ci DEFAULT NULL,

  `city_id` char(4) COLLATE utf8mb4_unicode_ci DEFAULT NULL,
   ........

  PRIMARY KEY (`id`),

  KEY `ix_order_bang_province_id` (`province_id`),

  KEY `ix_order_bang_status` (`status`),

  KEY `bang_addr_index` (`province_id`,`city_id`),

  KEY `ix_order_bang_create_time` (`create_time`),

  KEY `ix_order_bang_creator_id` (`creator_id`)

)
2.在flask中记录查询较慢的sql语句及相关信息
本人设置最长查询时间为0.1秒便记录
相关 方法在:项目中记录影响性能的缓慢数据库查询
3.关闭mysql缓存功能
查看缓存是否开启,
输入命令:show variables like '%cache%'; query_cache_type值为OFF表示关闭
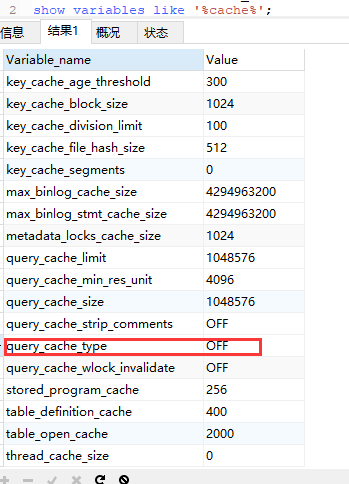
关闭方式输入如下:
one.
set global query_cache_type=0

set global query_cache_size=0
two.
查询中添加: Select sql_no_cache count(*) from account_user; 不缓存
4.查看相关结果,并进行优化
一:
时间耗时3.32秒。
分析得知:

where子句条件时uid进行筛选,而索引用的是 id。
解决方法:
第一种:在 uid上添加索引。
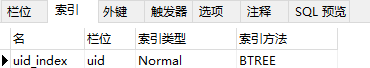
分析得知:
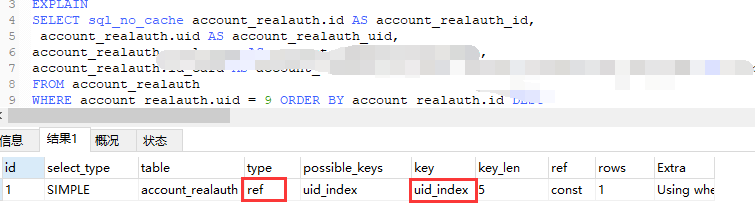
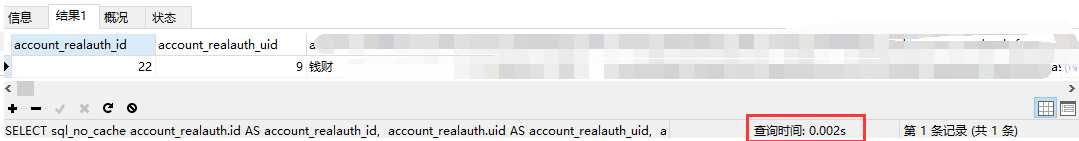
查询使用uid的索引,耗时0.002秒。
第二种:对于客户端不需要表中全部字段的情况,在查询时最好选择具体的字段,而不是直接 select * from table;这样 可以减少网络带宽
在sqlalchemy中为如下(直接使用类方法,及查询具体字段,而不是返回一个对象)
class RealAuth(DB.Model):
    @classmethod
        def get_success_realname(cls, uid):
           db_result = DB.session.query(cls.real_name).filter(
              and_(cls.uid == uid, cls.status == RealAuthStatus.SUCCESS)).order_by(
              cls.id.desc()).limit(1).first()
总结:
错误原因:由于没有对where子句条件使用索引,导致查询过慢
经验教训:添加索引
二:在查订单时, 接口直接 无响应
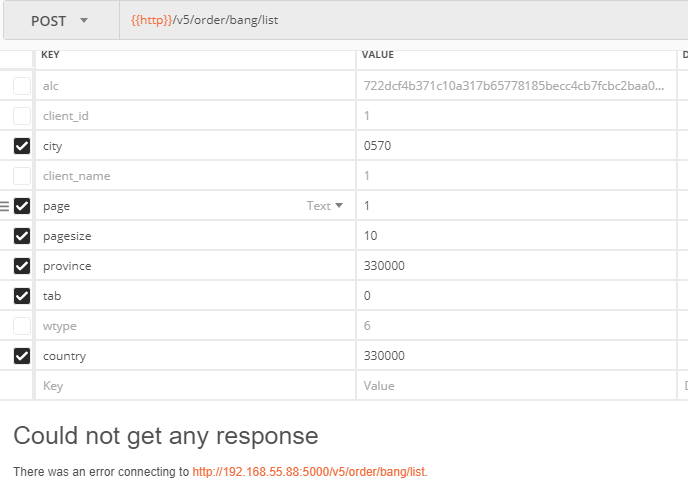
sql语句如下:
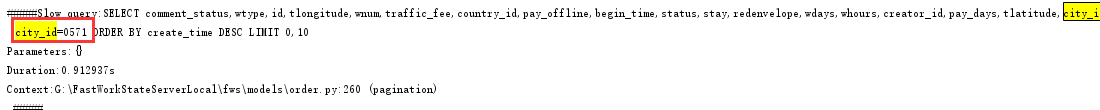
索引如下:

city字段类型是 char类型
通过 explain查看本条sql,city_id传的值是int类型:
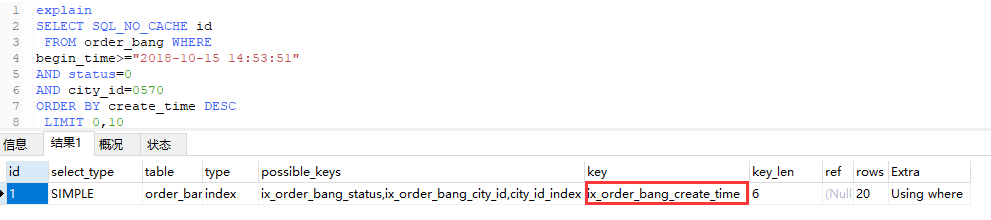
索引使用的是 create_time。
把city_id改为数据库中设定的 str 类型,再次查看
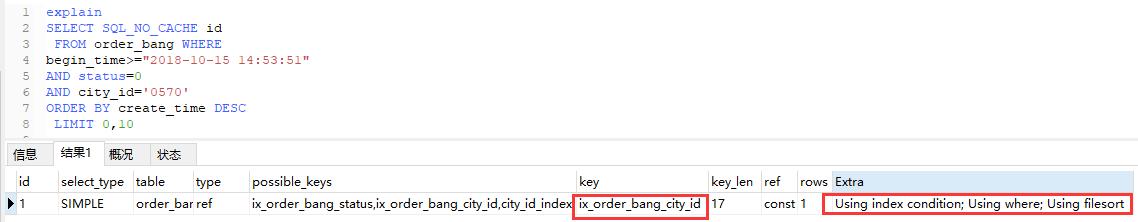

总结:
错误原因:导致此接口查询无响应的原因是 在 大量数据的情况下,没有规范 书写 sql查询的数据类型,导致 无法使用正确的索引,而导致此问题
经验教训:在开发中,在sql执行之前,一定要手动的把 查询条件的值的类型和设计表时的类型相对应,否则可能导致 数据库无法使用此索引,而出错。
待更新;
mysql数据库优化(四)-项目实战的更多相关文章
- mysql 数据库优化第一篇(基础)
Mysql数据库优化 1. 优化概述 存储层:存储引擎.字段类型选择.范式设计 设计层:索引.缓存.分区(分表) 架构层:多个mysql服务器设置,读写分离(主从模式) sql语句层:多个sql语句都 ...
- MySQL性能优化(四):SQL优化
原文:MySQL性能优化(四):SQL优化 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https://blog.csdn.net/ ...
- 50多条mysql数据库优化建议
1.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引. 缺省情况下建立的索引是非群集索引,但有时它并不是最佳的.在非群集索引下,数据在物理上随机存 ...
- 解开发者之痛:中国移动MySQL数据库优化最佳实践(转)
开源数据库MySQL比较容易碰到性能瓶颈,为此经常需要对MySQL数据库进行优化,而MySQL数据库优化需要运维DBA与相关开发共同参与,其中MySQL参数及服务器配置优化主要由运维DBA完成,开发则 ...
- 百万行mysql数据库优化和10G大文件上传方案
百万行mysql数据库优化和10G大文件上传方案 最近这几天正在忙这个优化的方案,一直没时间耍,忙碌了一段时间终于还是拿下了这个项目?项目中不要每次都把程序上的问题,让mysql数据库来承担,它只是个 ...
- 从运维角度来分析mysql数据库优化的一些关键点【转】
概述 一个成熟的数据库架构并不是一开始设计就具备高可用.高伸缩等特性的,它是随着用户量的增加,基础架构才逐渐完善. 1.数据库表设计 项目立项后,开发部根据产品部需求开发项目,开发工程师工作其中一部分 ...
- mysql数据库优化 pt-query-digest使用
mysql数据库优化 pt-query-digest使用 一.pt-query-digest工具简介 pt-query-digest是用于分析 mysql慢查询的一个工具,它可以分析binlog.Ge ...
- mysql数据库优化课程---18、mysql服务器优化
mysql数据库优化课程---18.mysql服务器优化 一.总结 一句话总结: 1.四种字符集问题:字符集都设置为utf-82.slow log慢查询日志问题3.root密码丢失 1.mysql存在 ...
- mysql数据库优化课程---9、php用什么写的
mysql数据库优化课程---9.php用什么写的 一.总结 一句话总结:php是用c语言写的,所以php里面的那些模块什么都是c语言 c 1.php用什么写的? c php是用c语言写的,所以php ...
- mysql数据库优化课程---6、mysql结构化查询语言有哪些
mysql数据库优化课程---6.mysql结构化查询语言有哪些 一.总结 一句话总结:主要分为四类 1.DCL 数据控制语言1)grant2)commit3)rollback 2.DDL 数据定义语 ...
随机推荐
- mysql-8.0.12-winx64 解压版安装(转)
1.官网下载 https://dev.mysql.com/downloads/mysql/ 2.解压到一个合适的目录 3.配置环境变量 path : bin的目录(必须配置) MYSQL_HOME:m ...
- 1. Django概述
1.1 设计模型 Django,但它附带了一个你可以用python代码描述数据库布局的对象关系映射器. 数据模型语法提供了许多丰富的方法来展现你的模型——到目前为止,它解决了多年来数据库模式问题. 简 ...
- Problem E: 平面上的点——Point类 (V)
Description 在数学上,平面直角坐标系上的点用X轴和Y轴上的两个坐标值唯一确定.现在我们封装一个“Point类”来实现平面上的点的操作. 根据“append.cc”,完成Point类的构造方 ...
- Spring源码学习(3)—— 自定义标签
上一篇讲了Spring对默认标签的解析,Spring提供了很多属性,可以供开发者根据不同情况使用.绝大多数情况下,这些功能就已经足够了.但是,当用户有更特殊的需求,又或者很多公司自己实现的服务治理框架 ...
- FCC JS基础算法题(1):Factorialize a Number(计算一个整数的阶乘)
题目描述: 如果用字母n来代表一个整数,阶乘代表着所有小于或等于n的整数的乘积.阶乘通常简写成 n!例如: 5! = 1 * 2 * 3 * 4 * 5 = 120. 算法: function fac ...
- alignedReID: surpassing human-level performance in person re-identification (paper reading)
关键点: 1)对齐 (8%) 2)mutual learning (3%) 3)classification loss, hard triplet同时 4)re-ranking (5~6%) 关于对齐 ...
- Jquery仿百度经验左右滚动切换效果(转)
http://www.xwcms.net/webAnnexImages/fileAnnex/201608/61342/index.html
- Javascript 2.8
声明函数声明参数 function multiply(A,B,...N){}; 用return可以返回一个值/字符串/数组/布尔值 变量命名的Camel记号:从第二个单词开始把每个单词的首字母大写,其 ...
- spring中使用@PostConstruct和@PreConstruct注解
1.@PostConstruct说明 被@PostConstruct修饰的方法会在服务器加载Servlet的时候运行,并且只会被服务器调用一次,类似于Serclet的inti()方法.被@PostCo ...
- PythonStudy——数据类型 Type of data
数据类型:信息存在的状态为什么要来描述事物的具体状态:不同的事物需要不同的状态加以描述可以达到描述的最优化 python中有哪些常见的数据类型 1.整型 num = 10000000000000000 ...