
[LeetCode解题报告] 703. 数据流中的第K大元素
题目描述
设计一个找到数据流中第K大元素的类(class)。注意是排序后的第K大元素,不是第K个不同的元素。
你的 KthLargest 类需要一个同时接收整数 k 和整数数组nums 的构造器,它包含数据流中的初始元素。每次调用 KthLargest.add,返回当前数据流中第K大的元素。
示例
int k = 3;

int[] arr = [4,5,8,2];

KthLargest kthLargest = new KthLargest(3, arr);

kthLargest.add(3);   // returns 4

kthLargest.add(5);   // returns 5

kthLargest.add(10);  // returns 5

kthLargest.add(9);   // returns 8

kthLargest.add(4);   // returns 8
说明
你可以假设 nums 的长度≥ k-1 且k ≥ 1。
算法
当提到排序后的第K大元素或者排序后的最K小元素时,并且经常伴随着数据的插入或弹出时,应该能想到利用堆这种数据结构。
本题的算法思路为:
- 目标:在KthLargest这个类中维护一个最小堆,且保证堆的大小为k。
- 初始时,堆中元素还不满k个时,我们一边将元素插入最末尾,然后一边调整堆为最小堆。
- 当堆中元素已满k个时,再有新的元素要往堆里放的时候,我们将它与堆顶作比较。如果待放入的值比堆顶大,我们将待放入的值放在堆顶,然后重新调整最小堆;如果待放入的值小于或者等于堆顶的值,就什么也不做。
- 结果:我们会惊奇地发现,堆顶存放的数就是要求的数据流中第K大元素,将其返回即可。
为了更好的示意整个过程,我将以题目描述中给的例子为例,在图上画出具体的过程:
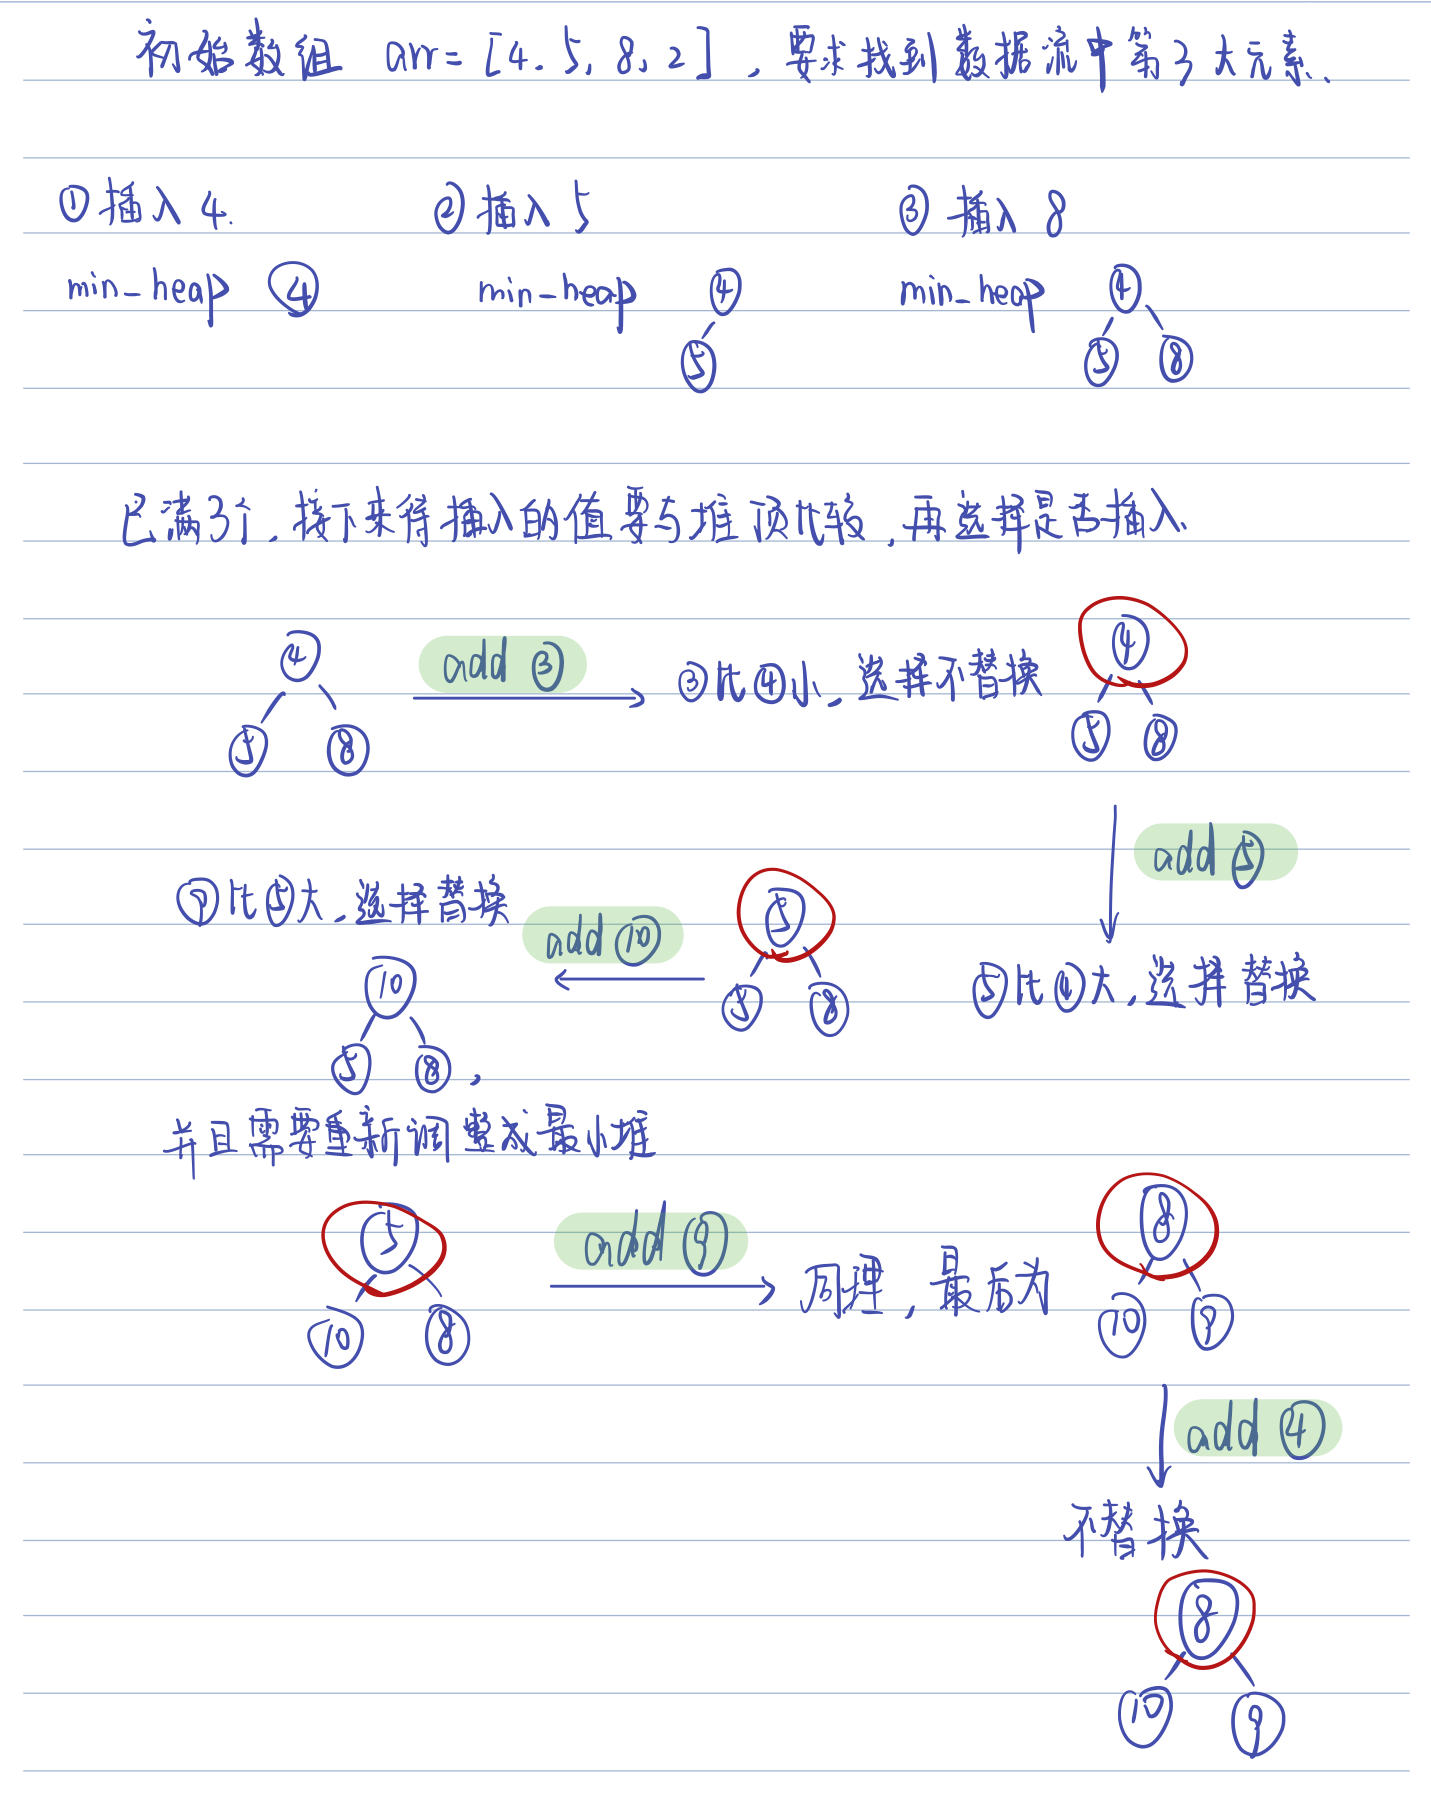
边界条件
当然,本题的边界条件就是考虑k的值和堆中元素的个数。
代码
#include <iostream>

#include <vector>

#include <algorithm>

using namespace std;

class KthLargest {

public:

    vector<int> min_heap;

    int _k;

    KthLargest(int k, vector<int> nums) {

        _k = k;

        for(int i = 0; i < _k && i < nums.size(); i++)

        {

            min_heap.push_back(nums[i]);

            PercUp(i);

        }

        for (int i = _k; i < nums.size(); i++)

            adjust(nums[i]);

    }

    int add(int val) {

        // 边界条件,即堆中还未满k个元素

        if (min_heap.size() < _k)

        {

            min_heap.push_back(val);

            PercUp(min_heap.size()-1);

        }

        else

            adjust(val);

        return min_heap[0];

    }

    void adjust(int x)

    {

        /*** 本函数用于比较待插入的元素x与堆顶的值大小,以便确认是否替换堆顶并调整最小堆 ***/

        // 堆顶元素更大,直接返回

        if (x <= min_heap[0])

            return;

        // 替换并调整的函数接口

        PercDown(x);

    }

    void PercUp(int p)

    {

        /*** 本函数意在将行插入在末尾的元素调整至合适的位置以维护整个堆是最小堆 ***/

        int father, child = p;

        int X = min_heap[child];

        while (child != 0)

        {

            father = (child - 1) / 2;

            // 与父节点比较

            if (min_heap[father] <= X)

                break;

            min_heap[child] = min_heap[father];

            child = father;

        }

        min_heap[child] = X;

    }

    void PercDown(int X)

    {

        /*** 本函数将新替换进来的堆顶元素找到一个合适的位置存放以维持整个堆是最小堆***/

        int father = 0;

        while (2*father+1 < _k)

        {

            int child = 2 * father + 1;

            // 找两个字节点中比较小的那个

            if (child + 1 < _k && min_heap[child] > min_heap[child+1])

                child++;

            // 与子节点比较

            if (min_heap[child] >= X)

                break;

            min_heap[father] = min_heap[child];

            father = child;

        }

        min_heap[father] = X;

    }

};

int main()

{

    vector<int> nums = {4, 5, 8, 2};

    KthLargest kth(3, nums);

    cout << kth.add(3) << endl;   // returns 4

    cout << kth.add(5) << endl;   // returns 5

    cout << kth.add(10) << endl;  // returns 5

    cout << kth.add(9) << endl;   // returns 8

    cout << kth.add(4) << endl;   // returns 8

    return 0;

}
最后
其实c++中的stl有定义一个容器-优先队列,它的本质是堆实现的。直接利用容器的话,也不用自己写堆的调整算法了,但是堆排序作为一个比较基础的排序算法,多写几遍掌握原理还是比较有益处的。堆排序的调整算法在另一篇博文https://www.cnblogs.com/shayue/p/10426127.html中。
[LeetCode解题报告] 703. 数据流中的第K大元素的更多相关文章
- Java实现 LeetCode 703 数据流中的第K大元素(先序队列)
703. 数据流中的第K大元素 设计一个找到数据流中第K大元素的类(class).注意是排序后的第K大元素,不是第K个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组n ...
- Leetcode 703. 数据流中的第K大元素
1.题目要求 设计一个找到数据流中第K大元素的类(class).注意是排序后的第K大元素,不是第K个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组nums 的构造器, ...
- java优先级队列的使用 leecode.703.数据流中的第K大元素
//设计一个找到数据流中第K大元素的类(class). //注意是排序后的第K大元素,不是第K个不同的元素. class KthLargest { private PriorityQueue<I ...
- 703. 数据流中的第 K 大元素
设计一个找到数据流中第 K 大元素的类(class).注意是排序后的第 K 大元素,不是第 K 个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组 nums 的构造器, ...
- leetcode 703数据流中的第K大元素
这里思路是堆排序,而且是小根堆.C++中包含在头文件<queue>的priority_queue本质就是堆排序实现的.其中priority_queue函数原型是 priority_queu ...
- 【Leetcode堆】数据流中的第K大元素(703)
题目 设计一个找到数据流中第K大元素的类(class).注意是排序后的第K大元素,不是第K个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组nums 的构造器,它包含数 ...
- Leetcode 703题数据流中的第K大元素(Kth Largest Element in a Stream)Java语言求解
题目链接 https://leetcode-cn.com/problems/kth-largest-element-in-a-stream/ 题目内容 设计一个找到数据流中第K大元素的类(class) ...
- [Swift]LeetCode703. 数据流中的第K大元素 | Kth Largest Element in a Stream
Design a class to find the kth largest element in a stream. Note that it is the kth largest element ...
- 数据流中的第k大元素的golang实现
设计一个找到数据流中第K大元素的类(class).注意是排序后的第K大元素,不是第K个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组nums 的构造器,它包含数据流中 ...
随机推荐
- windows 性能监视器常用计数器
转载地址:https://www.jianshu.com/p/f4406c29542a?utm_campaign=maleskine&utm_content=note&utm_medi ...
- Hbase 性能改进
第一种性能改进方式:
- Mysql中比较常用的两种存储引擎和事务
存储引擎:引擎(类似汽车上的发动机)决定了数据库的快慢,MySql中有20多个引擎,不同的存储引擎提供不同的存储机制.索引技巧.锁定水平.MYISAM存储引擎,INNODB存储引擎最出名.数据库的核心 ...
- PMP:2.项目运行环境
事业环境因素(EEF):事业环境因素源于项目外部(往往是企业外部)的环境,是指项目团队不能控制的,将对项目产生影响.限制或指令作用的各种条件. 组织内部的事业环境因素: { uu组织文化.结构 ...
- 获取post请求数据工具类
package com.ccidit.features.otherFunctions.util; import java.io.BufferedReader; import java.io.IOExc ...
- 201621123018《java程序设计》第14周作业总结
1. 本周学习总结 1.1 以你喜欢的方式(思维导图或其他)归纳总结与数据库相关内容. 2. 使用数据库技术改造你的系统 2.1 简述如何使用数据库技术改造你的系统.要建立什么表?截图你的表设计. 将 ...
- MSRA-TD5000数据集使用详解
中文检测的数据集,目前最火的应该是清华的CTW,https://ctwdataset.github.io/ 但是它的数据集只存储在微云和google driver,微云空间受限不能完全保存,所以下载的 ...
- JS应用实例4:表格隔行换色
HTML代码: <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <t ...
- div、span内容超出省略号
span设置部分省略...: span{ overflow: hidden; text-overflow: ellipsis; -o-text-over ...
- LeetCode:104_Maximum Depth of Binary Tree | 二叉树的最大深度 | Easy
要求:求二叉树的深度(二叉树的深度为最远叶子节点到根节点的距离,即根节点到最远叶子节点的距离) Given a binary tree, find its maximum depth. The max ...