
Kafka+Log4j2日志
默认你已经安装配置了Zookeeper和Kafka。
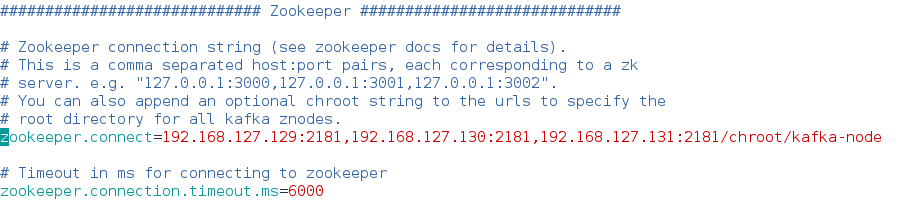
为了目录清晰,我的Kafka配置文件的Zookeeper部分是:加上了节点用来存放Kafka信息
启动Zookeeper,然后启动Kafka。
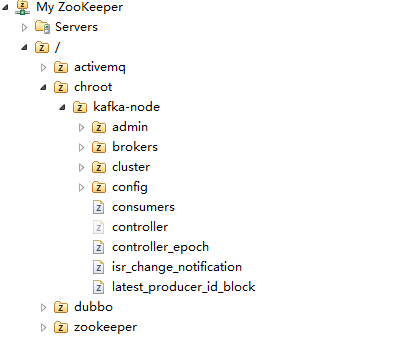
Zookeeper的节点树:根目录下有专门的Kafka存放节点【以前没有配这个,结果Kafka的一大堆东西全部跑到根节点上了,很乱】
接下来是代码部分了。
依赖包:
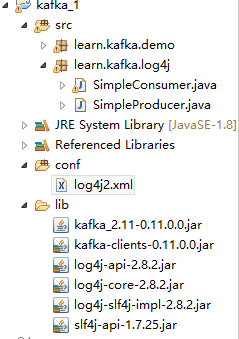
Log4j2配置文件:
<?xml version="1.0" encoding="UTF-8"?>

<Configuration monitorInterval="1800">

    <Filter type="ThresholdFilter" level="trace" />

    <Appenders>

        <Console name="console" target="SYSTEM_OUT">

            <!--控制台只输出level及以上级别的信息(onMatch),其他的直接拒绝(onMismatch) -->

            <ThresholdFilter level="trace" onMatch="ACCEPT"

                onMismatch="DENY" />

            <PatternLayout pattern="%d %-5p [%t] %C{2} (%F:%L) - %m%n" />

        </Console>

        <Kafka name="Kafka" topic="my-topic" syncSend="false">

            <PatternLayout pattern="%date %message" />

            <Property name="bootstrap.servers">192.168.127.129:9092,192.168.127.130:9092,192.168.127.131:9092</Property>

        </Kafka>

    </Appenders>

    <Loggers>

        <Root level="WARN">

            <!-- TRACE < DEBUG < INFO < WARN < ERROR < FATAL -->

            <AppenderRef ref="console" />

        </Root>

        <Logger name="kafkaLog" level="trace">

            <AppenderRef ref="Kafka" />

        </Logger>

    </Loggers>

</Configuration>
生产者:
package learn.kafka.log4j;

import org.apache.logging.log4j.LogManager;

import org.apache.logging.log4j.Logger;

public class SimpleProducer {

    private static Logger log = LogManager.getLogger("kafkaLog");

    public static void main(String[] args) {

        for (int i = 10; i < 20; i++) {

            log.info("Hello---" + i);

            try {

                Thread.sleep(1000);

            } catch (InterruptedException e) {

                // TODO Auto-generated catch block

                e.printStackTrace();

            }

        }

    }

}
消费者:
package learn.kafka.log4j;

import java.util.Arrays;

import java.util.Properties;

import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

public class SimpleConsumer {

    public static void main(String[] args) {

        Properties props = new Properties();

        props.put("bootstrap.servers", "192.168.127.129:9092,192.168.127.130:9092,192.168.127.131:9092");

        props.put("group.id", "testGroup");

        props.put("enable.auto.commit", "true");

        props.put("auto.commit.interval.ms", "1000");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);

        //订阅的topic,多个用逗号隔开

        consumer.subscribe(Arrays.asList("my-topic"));

        while (true) {

            ConsumerRecords<String, String> records = consumer.poll(100);

            for (ConsumerRecord<String, String> record : records)

                System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value());

        }

        //consumer.close();

    }

}
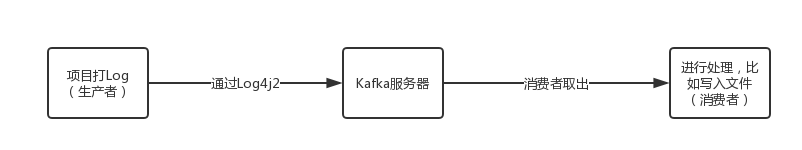
先运行消费者,让它监听等待。
在运行生产者,让它生产消息。
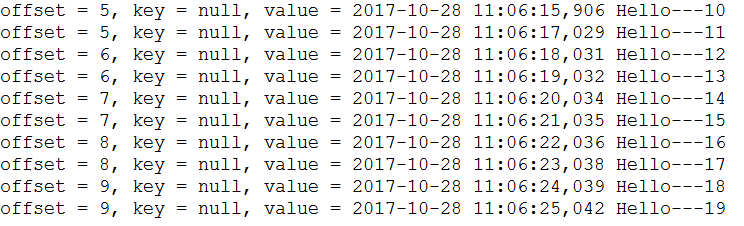
你会发现每隔一秒输出一行信息。信息在value后面。
Kafka+Log4j2日志的更多相关文章
- 基于Flume+LOG4J+Kafka的日志采集架构方案
本文将会介绍如何使用 Flume.log4j.Kafka进行规范的日志采集. Flume 基本概念 Flume是一个完善.强大的日志采集工具,关于它的配置,在网上有很多现成的例子和资料,这里仅做简单说 ...
- 【转】flume+kafka+zookeeper 日志收集平台的搭建
from:https://my.oschina.net/jastme/blog/600573 flume+kafka+zookeeper 日志收集平台的搭建 收藏 jastme 发表于 10个月前 阅 ...
- ELK+kafka构建日志收集系统
ELK+kafka构建日志收集系统 原文 http://lx.wxqrcode.com/index.php/post/101.html 背景: 最近线上上了ELK,但是只用了一台Redis在 ...
- spring boot自定义log4j2日志文件
背景:因为从 spring boot 1.4开始的版本就要用log4j2 了,支持的格式有json和xml两种格式,此次实践主要使用的是xml的格式定义日志说明. spring boot 1.5.8. ...
- JavaWeb项目架构之Kafka分布式日志队列
架构.分布式.日志队列,标题自己都看着唬人,其实就是一个日志收集的功能,只不过中间加了一个Kafka做消息队列罢了. kafka介绍 Kafka是由Apache软件基金会开发的一个开源流处理平台,由S ...
- 【kafka学习之五】kafka运维:kafka操作日志设置和主题删除
一.操作日志 首先附上kafka 操作日志配置文件:log4j.properties 根据相应的需要设置日志. #日志级别覆盖规则 优先级:ALL < DEBUG < INFO <W ...
- Log4j2 日志级别
Log4j2日志级别 级别 在log4j2中, 共有8个级别,按照从低到高为:ALL < TRACE < DEBUG < INFO < WARN < ERROR < ...
- ELK+Kafka 企业日志收集平台(一)
背景: 最近线上上了ELK,但是只用了一台Redis在中间作为消息队列,以减轻前端es集群的压力,Redis的集群解决方案暂时没有接触过,并且Redis作为消息队列并不是它的强项:所以最近将Redis ...
- Spring Boot Log4j2 日志学习
简介 Java 中比较常用的日志工具类,有: Log4j. SLF4j. Commons-logging(简称jcl). Logback. Log4j2(Log4j 升级版). Jdk Logging ...
随机推荐
- PAT甲题题解-1130. Infix Expression (25)-中序遍历
博主欢迎转载,但请给出本文链接,我尊重你,你尊重我,谢谢~http://www.cnblogs.com/chenxiwenruo/p/6789828.html特别不喜欢那些随便转载别人的原创文章又不给 ...
- Linux内核分析作业八
进程的切换和系统的一般执行过程 贾瑗 原创作品转载请注明出处 <Linux内核分析>MOOC课程 http://mooc.study.163.com/course/USTC-1000029 ...
- 20135323符运锦----LINUX第三次实践:程序破解
程序破解 一.掌握NOP.JNE.JE.JMP.CMP汇编指令的机器码 ①NOP:NOP指令即"空指令".执行到NOP指令时,CPU什么也不做,仅仅当做一个指令执行过去并继续执行N ...
- java面对对象(六)--内部类、匿名内部类
内部类 可以在一个类的内部定义另一个类这种类成为内部类或嵌套类,比如: class Outer{ … class Inner{ …. } } class Outer1{} // 这个Inner1不是O ...
- Spring整合SpringMVC
整合:把在springMVC配置文件中的spring提取出来整合为另一份配置文件 希望: 1).Spring的配置文件只是用来配置和业务逻辑有关的功能(数据源.事务控制.切面....) 2).Spri ...
- JavaScript 模拟 HashMap例子
function map(){ var map = {}; // Map map = new HashMap(); var key = "key"; va ...
- php多进程pcntl学习-僵尸进程
上个月写的文章,php多进程pcntl学习(一)现在发现并不完整,因为虽然提到了关闭子进程,但是并没有回收子进程,简单的说就是当子进程比父进程先退出,而父进程没对其做任何处理的时候,子进程将会变成僵尸 ...
- WPF 如何控制右键菜单ContextMenu的弹出
在具体做一些项目的时候,有时候需要需要先左键点击某个节点,然后再右键点击节点的时候才弹出右键菜单,所以直接右键点击时需要禁用掉右键菜单,这里比如我们为Grid添加了ContextMenu,但是我们需要 ...
- 日志那点事儿——slf4j源码剖析
前言: 说到日志,大多人都没空去研究,顶多知道用logger.info或者warn打打消息.那么commons-logging,slf4j,logback,log4j,logging又是什么关系呢?其 ...
- java.util.concuttent Callable Future详解
在传统的多线程实现方式中(继承Thread和实现Runnable)无法直接获取线程执行的返回结果,如果需要获取执行结果,就必须通过共享变量或者使用线程通信的方式来达到效果,这样使用起来就比较麻烦. 从 ...