
爬虫 (6)- Scrapy 实战案例 - 爬取不锈钢的相关钢卷信息
超详细创建流程及思路
一. 新建项目
1.创建文件夹,然后在对应文件夹创建一个新的python项目
2.点击Terminal命令行窗口,运行下面的命令创建scrapy项目
scrapy startproject bxg
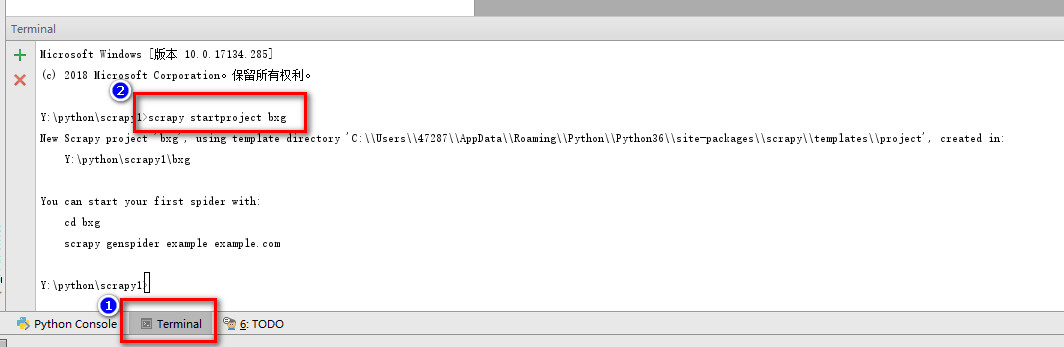
二、明确目标
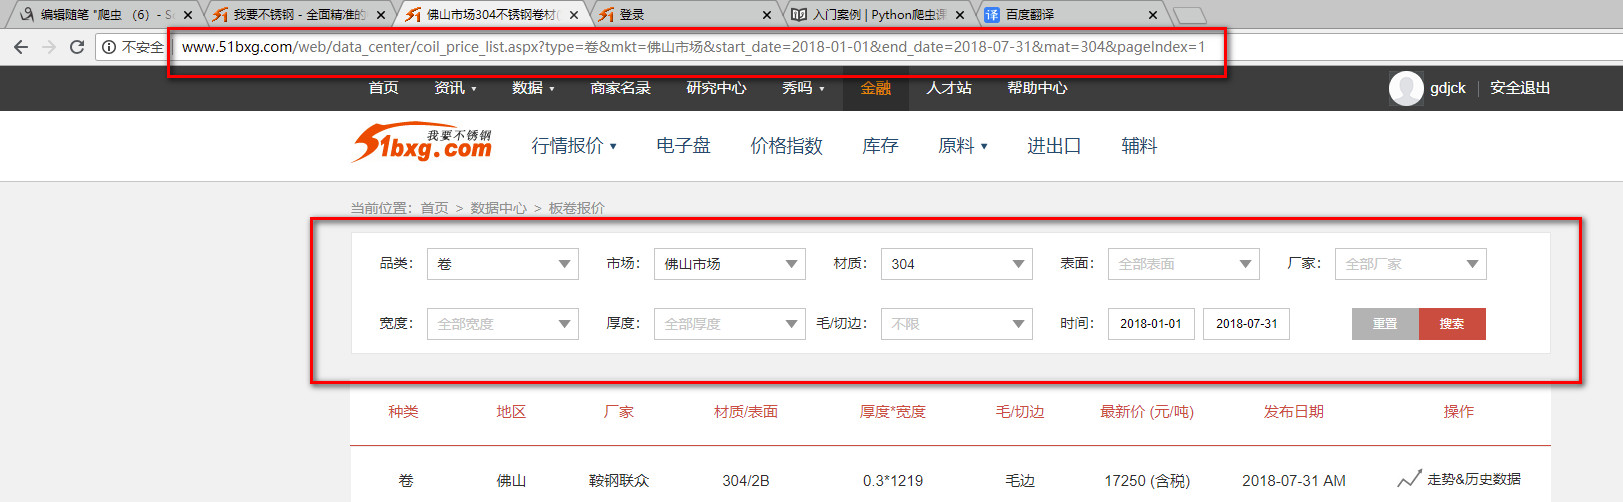
1.我们打算抓取2018年1月到8月,佛山市场各个公司关于304钢卷的价格、规格等数据;
(1)打开mySpider目录下的items.py
配置将我们需要爬取的信息
import scrapy

class BxgItem(scrapy.Item):

    vender = scrapy.Field() #  厂家

    texture = scrapy.Field() #  材质

    thickness = scrapy.Field() # 厚度

    cutting = scrapy.Field() # 切边

    price = scrapy.Field() # 价格

    date = scrapy.Field() # 日期
三、制作爬虫
1. 爬数据
(1)在bxg/bxg/spiders目录下输入命令,将在bxg/bxg/spiders目录下创建一个名为bxg1的爬虫,并指定爬取域的范围,注意,爬虫名字不能根项目名字一样。
scrapy genspider bxg1 "51bxg.com"
难点一,这是一个需要付费会员登陆后才能访问的搜索钢卷页面。
我们需要模拟登陆后的状态,所以我们用fidder工具获取到登陆后的cookies先。
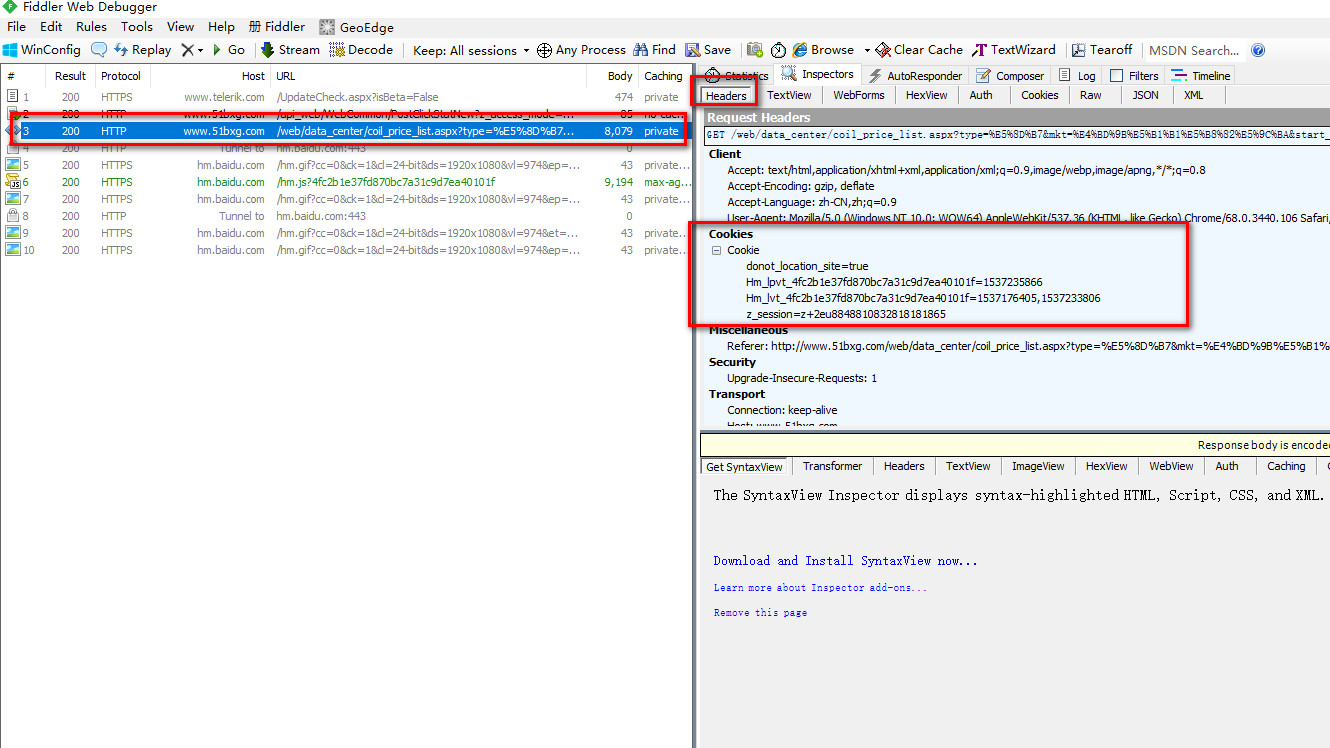
难点二,用Xpath语法过滤获取到我们需要的数据 Xpath语法文档
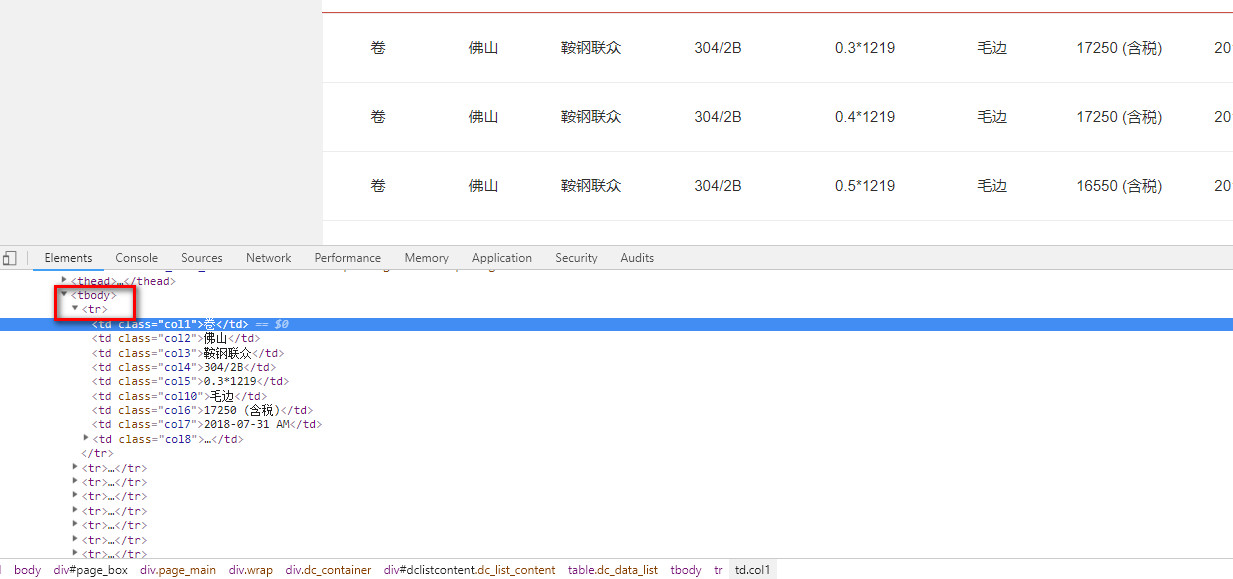
xpath("//tbody/tr")
(2)打开bxg/bxg/spiders目录里的 bxg1.py,替换成下面的代码
# -*- coding: utf-8 -*-

import scrapy

from bxg.items import BxgItem

# 实在没办法了,可以用这种方法模拟登录,麻烦一点,成功率100%

class Bxg1Spider(scrapy.Spider):

    name = "bxg1"

    allowed_domains = ["51bxg.com"]

    url = 'http://www.51bxg.com/web/data_center/coil_price_list.aspx?type=卷&mkt=佛山市场&start_date=2018-01-01&end_date=2018-07-31&mat=J1&pageIndex='

    offset = 1

    start_urls = [url + str(offset)]

    # 从fidder中获取到的cookies数据

    cookies = {

        'z_session' : 'z+2eu8848810832818181865',

        'donot_location_site' : 'true',

        'Hm_lvt_4fc2b1e37fd870bc7a31c9d7ea40101f' : '1533546617,1533607332',

        'Hm_lpvt_4fc2b1e37fd870bc7a31c9d7ea40101f' : '1533621991'

    }

    def start_requests(self):

        # 具体循环次数需要看搜索到的页数,这里方便测试只导出10页

        while (self.offset < 10):

            self.start_urls.append(self.url + str(self.offset))

            self.offset += 1

        for url in self.start_urls:

            print(url)

            yield scrapy.FormRequest(url, cookies = self.cookies, callback = self.parse_page)

    def parse_page(self, response):

        items = []

        # 循环页面中所有对应Xpath语法过滤到的列

        for each in response.xpath("//tbody/tr"):

            item = BxgItem()

            vender = each.xpath("td[@class='col3']/text()").extract()

            texture = each.xpath("td[@class='col4']/text()").extract()

            thickness = each.xpath("td[@class='col5']/text()").extract()

            cutting = each.xpath("td[@class='col10']/text()").extract()

            price = each.xpath("td[@class='col6']/text()").extract()

            date = each.xpath("td[@class='col7']/text()").extract()

            # xpath返回的是包含一个元素的列表

            item['vender'] = vender[0]

            item['texture'] = texture[0]

            item['thickness'] = thickness[0]

            item['cutting'] = cutting[0]

            item['price'] = price[0]

            item['date'] = date[0]

            items.append(item)

            # 运行脚本:scrapy crawl bxg1 -o data.csv

            # 直接返回最后数据 iconv -f utf-8 -t gbk data.csv > a.csv

        return items
2.取数据
(1)在bxg/bxg/spiders目录下输入命令,运行bxg1爬虫,将爬取的数据导出到data.csv文件中
scrapy crawl bxg1 -o data.csv
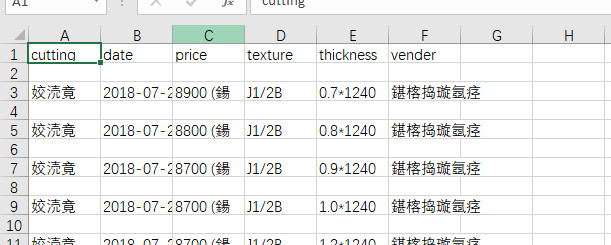
(2)发现获取的数据编码格式有点问题,出现乱码,需要对文件处理
iconv -f utf-8 -t gbk data.csv > a.csv
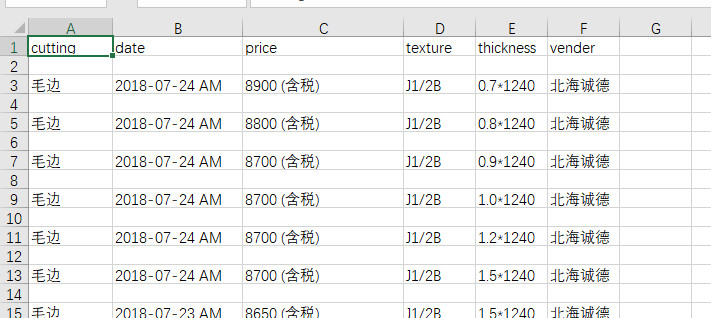
最后得到我们需要爬取的数据。
爬虫 (6)- Scrapy 实战案例 - 爬取不锈钢的相关钢卷信息的更多相关文章
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- python网络爬虫之scrapy 调试以及爬取网页
Shell调试: 进入项目所在目录,scrapy shell “网址” 如下例中的: scrapy shell http://www.w3school.com.cn/xml/xml_syntax.as ...
- Scrapy实战:爬取http://quotes.toscrape.com网站数据
需要学习的地方: 1.Scrapy框架流程梳理,各文件的用途等 2.在Scrapy框架中使用MongoDB数据库存储数据 3.提取下一页链接,回调自身函数再次获取数据 重点:从当前页获取下一页的链接, ...
- scrapy实战7爬取搜狗微信:
爬取微信热门文章标题,内容,内容地址,微信公众号,公众号地址,发布日期等 如图 源码地址:https://github.com/huwei86/sougouweixin
- scrapy实战6爬取IT桔子国内所有融资公司:
爬取融资公司,融资公司简介,融资时间,轮次,融资额,投资方,股权占比以及融资公司完整融资历史 如图 源码地址:https://github.com/huwei86/spiderITjuzi
- python实战项目 — 爬取中国票房网年度电影信息并保存在csv
import pandas as pd import requests from bs4 import BeautifulSoup import time def spider(url, header ...
- 分布式爬虫系统设计、实现与实战:爬取京东、苏宁易购全网手机商品数据+MySQL、HBase存储
http://blog.51cto.com/xpleaf/2093952 1 概述 在不用爬虫框架的情况,经过多方学习,尝试实现了一个分布式爬虫系统,并且可以将数据保存到不同地方,类似MySQL.HB ...
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- 爬虫系列5:scrapy动态页面爬取的另一种思路
前面有篇文章给出了爬取动态页面的一种思路,即应用Selenium+Firefox(参考<scrapy动态页面爬取>).但是selenium需要运行本地浏览器,比较耗时,不太适合大规模网页抓 ...
随机推荐
- 如何使用 awk 输出文本中的字段和列
首先我们要知道,awk 能够自动将输入的行,分隔为若干字段.每一个字段就是一组字符,它们和其他的字段由一个内部字段分隔符分隔开来. 如果你熟悉 Unix/Linux 或者懂得 bash shell 编 ...
- intellij idea使用maven本地仓库及修改本地仓库路径
什么maven本地仓库,默认是用户目录下的.m2/repository这个文件. idea是自带maven插件的不用我们再,怎么把依赖包下载到我们的本地仓库呢?一般是idea默认了路径,而且idea是 ...
- HTTP状态码及说明
- 使用Sublime经验分享
Sublime轻量级.可是绝对是神一样的编辑器. 1.代码清晰美观 2.能够选择文件夹作为文件结构文件夹显示在左側 3.以tab的形式打开多个页面在同一个窗体内 设置方法例如以下: Preferenc ...
- socket何时处于”读就绪状态“?---通过“应用程序大爷"和"内核孙子"对话再看重要的select函数的使用方法
前面. 我已经陆续介绍过select函数的一些零碎知识, 在本文中,我们来讨论这样一个问题:socket何时处于读就绪状态? 事实上主要讨论select函数, 毕竟socket的读就绪状态会导致sel ...
- 【原创】Android自定义适配器的使用方法
比如说我们已经得到了数据,想在一个listview或者在其他的控件中显示的,并且我们显示想要自己设计样式来显示的话就要用到自定义适配器了,下面让我们结合代码讲一下具体的使用方法: 代码会有注释的哦: ...
- 2014面试总结--java、数据 方向
这里不讲详细的题目.仅仅是总结一下体会. 好一点的公司考察的都比較全面,主要看你对原理性的理解.还有你的思维逻辑:就眼下来讲,对深度的考察大于广度.而我个人如今这个阶段也比較专注于深度. 列一些常常问 ...
- J2EE环境搭建(三)配置Tomcat 7.0的局部数据源
在J2EE环境搭建(一)中遗留下一个配置Tomcat数据源的问题,最近都在专心搞iOS的东西,由于J2EE布置了作业,所以又回过头来搞下J2EE.汗... 在这里我使用的是MySQL. 1.配置MyS ...
- UVA 10168 Summation of Four Primes(数论)
Summation of Four Primes Input: standard input Output: standard output Time Limit: 4 seconds Euler p ...
- maven modules
所有用Maven管理的真实的项目都应该是分模块的,每个模块都对应着一个pom.xml.它们之间通过继承和聚合(也称作多模块,multi-module)相互关联.那么,为什么要这么做呢?我们明明在开发一 ...