
机器学习实战笔记-5-Logistic回归
Logistic回归
| 优缺点 | 适用范围 |
|---|---|
| 优点:计算代价不高,易于理解和实现。 缺点:容易欠拟合,分类精度可能不高。 适用于:数值型和标称型数据。 | 仅用于二分类 |
原理:
每个特征都乘以一个回归系数>>将结果相加>>总和代入到Sigmoid函数,得到范围在(0,1)中的数值>>预测分类结果\(\hat{y}\)。即\(Z= w_{0}x_{0} + w_{1}x_{1} + \ldots + w_{n}x_{n} = \sum_{i = 0}^{n}{w_{i}x_{i} =w^{T}x}\),代入Sigmoid函数即可。
两个类别的分割点是\(Z=0\),即直线\(w_{0}x_{0}+w_{1}x_{1}+\ldots +w_{n}x_{n}=0\)。
\]
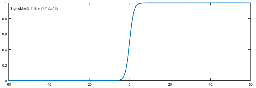
若用\(y’\)表示分类为1的概率,\(P\left( y = 1 \middle| x,w \right) =
y'\),则分类为0的概率为\(P\left( y = 0 \middle| x,w \right) = 1 - y'\)。
极大似然概率为\(L\left( w \right) = \prod_{i =
1}^{m}{ { {(y}_{i}^{'})}^{y_{i} }\left( 1 - y_{i}^{'} \right)^{1 - y_{i} } }\),
取对数后为\(\mathbf{l}\left( \mathbf{w} \right)\mathbf{=}\sum_{\mathbf{i =
1} }^{\mathbf{m} }{\mathbf{(}\mathbf{y}_{\mathbf{i} }\log\left(
\mathbf{y}^{\mathbf{'} } \right)\mathbf{+ (1
-}\mathbf{y}_{\mathbf{i} }\mathbf{)log(1
-}\mathbf{y}_{\mathbf{i} }^{\mathbf{'} }\mathbf{)} }\mathbf{)}\),迭代式为
\(\mathbf{w}_{\mathbf{j} }\mathbf{: =}\mathbf{w}_{\mathbf{j} }\mathbf{+
\alpha}\frac{\mathbf{\partial} }{\mathbf{\partial}\mathbf{w}_{\mathbf{j} } }\mathbf{l(w)}\)
\]
\]
其中用到了 记\(f\left( x \right) = \frac{1}{1 +
e^{g(x)} }\),则\(\frac{\partial}{\partial x}f\left( x \right) = f\left( x
\right)\left( 1 - f\left( x \right) \right)\frac{\partial}{\partial x}g(x)\)
现有一数据集trainMat,记作矩阵X,则\(error = \mathbf{\text{labelMat} } -
\sigma(\mathbf{X} \times \mathbf{w})\)为预测值与实际值的差。
极大似然概率就是要回归的最大值\(l(w)\),并不在代码中体现,迭代式为
\]
\]
梯度上升算法伪代码:
  每个回归系数初始化为1

  重复R次

    计算整个数据集的梯度

    使用alpha×gradient更新回归系数的向量

  返回回归系数
随机梯度上升算法伪代码:
每个回归系数初始化为1

对数据集中每个样本

  计算该样本的梯度

  使用alpha×gradient更新回归系数的值

返回回归系数值
知识点:最大似然估计法-本质就是求联合概率的最大值
二项分布的似然函数(某次实验:投n次硬币有m次正面)
\]
二项分布用通俗点的话来说,就是描述了抛10次硬币的结果的概率,其中,“花”出现的概率为\(\theta\)。如{4,5,5,2,7,4}就是6次实验的结果,每个数字表示抛10次硬币出现了几次“花”。
用\(x_{1},x_{2},\ldots,x_{n}\)表示实验结果,则因为每次实验都是独立的,所以似然函数可以写作(得到这个似然函数很简单,独立事件的联合概率,直接相乘就可以得到):
\]
其中\(f\left( x_{n} \middle| \theta\right)\)表示同一参数下的实验结果,也可认为是条件概率。
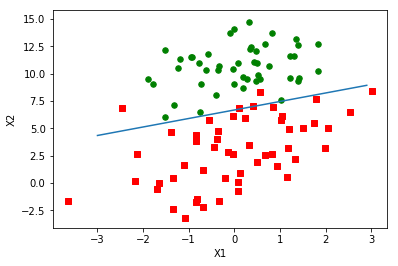
用python画的图
机器学习实战笔记-5-Logistic回归的更多相关文章
- 机器学习实战笔记5(logistic回归)
1:简单概念描写叙述 如果如今有一些数据点,我们用一条直线对这些点进行拟合(改线称为最佳拟合直线),这个拟合过程就称为回归.训练分类器就是为了寻找最佳拟合參数,使用的是最优化算法. 基于sigmoid ...
- 《机器学习实战》-逻辑(Logistic)回归
目录 Logistic 回归 本章内容 回归算法 Logistic 回归的一般过程 Logistic的优缺点 基于 Logistic 回归和 Sigmoid 函数的分类 Sigmoid 函数 Logi ...
- 机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归
机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归 关键字:Logistic回归.python.源码解析.测试作者:米仓山下时间:2018- ...
- 机器学习实战笔记-k-近邻算法
机器学习实战笔记-k-近邻算法 目录 1. k-近邻算法概述 2. 示例:使用k-近邻算法改进约会网站的配对效果 3. 示例:手写识别系统 4. 小结 本章介绍了<机器学习实战>这本书中的 ...
- 机器学习实战 - 读书笔记(05) - Logistic回归
解释 Logistic回归用于寻找最优化算法. 最优化算法可以解决最XX问题,比如如何在最短时间内从A点到达B点?如何投入最少工作量却获得最大的效益?如何设计发动机使得油耗最少而功率最大? 我们可以看 ...
- 机器学习实战读书笔记(五)Logistic回归
Logistic回归的一般过程 1.收集数据:采用任意方法收集 2.准备数据:由于需要进行距离计算,因此要求数据类型为数值型.另外,结构化数据格式则最佳 3.分析数据:采用任意方法对数据进行分析 4. ...
- 机器学习实战笔记(Python实现)-04-Logistic回归
--------------------------------------------------------------------------------------- 本系列文章为<机器 ...
- 机器学习实战笔记(Python实现)-08-线性回归
--------------------------------------------------------------------------------------- 本系列文章为<机器 ...
- 机器学习实战笔记(Python实现)-09-树回归
---------------------------------------------------------------------------------------- 本系列文章为<机 ...
随机推荐
- [BZOJ 3731] Gty的超级妹子树 (树分块)
[BZOJ 3731] Gty的超级妹子树 (树分块) 题面 给出一棵树(或森林),每个点都有一个值.现在有四种操作 1.查询x子树里>y的值有多少个 2.把点x的值改成y 3.添加一个新节点, ...
- 第017讲:函数 - Python的乐高积木
0. 你有听说过DRY吗? me:不知道 参考答案: 1. 都是重复一段代码,为什么我要使用函数(而不使用简单的拷贝黏贴)呢? me:函数可以设置参数. 参考答案:0) 可以降低代码量(调用函数只需要 ...
- sys模块与shutil模块
#coding=utf-8 import sys ## sys.argv #从命令行获取参数 import shutil #文件.文件夹.压缩包.处理模块 f1 = open("test.t ...
- Vue+Element-Ui 异步表单效验
简单的效验 Form 组件提供了表单验证的功能,只需要通过 rules 属性传入约定的验证规则,并将 Form-Item 的 prop 属性设置为需校验的字段名 /* ruleForm :表单绑定的数 ...
- javascript Math取整&获取随机数
1.方法介绍 Math.ceil(n) 上取整,大于等于n返回与它最接近的整数 Math.floor(n) 下取整,小于等于n返回与它最接近的整数 Math.round(n) 四舍五入取整 Math. ...
- vsftp 主动模式安装
server:192.168.109.137 client:192.168.109.138 ------------------------------------------------------ ...
- web源码泄露
http://www.am0s.com/ctf/175.html vim 文件泄露 1.备份文件 源文件:index.php 备份文件:index.php~ 2.临时文件 源文件:index.php ...
- Python---基础---常用的内置模块(Github、P有charm、math数学模块和random随机数模块,做一些简单的练习)
2019-05-24 ----------------------------------
- JavaWeb(四):JDBC
数据持久化(persistence) 把数据保存到可掉电式存储设备中以供之后使用. 大多数情况下,特别是企业级应用,数据持久化意味着将内存中的数据保存到硬盘上加以”固化”,而持久化的实现过程大多通过各 ...
- SpringBoot 参数校验
一.添加依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId> ...