
Newsgroups数据集研究
1.数据集介绍
20newsgroups数据集是用于文本分类、文本挖据和信息检索研究的国际标准数据集之一。
数据集收集了大约20,000左右的新闻组文档,均匀分为20个不同主题的新闻组集合。
一些新闻组的主题特别相似(e.g. comp.sys.ibm.pc.hardware/ comp.sys.mac.hardware),还有一些却完全不相关 (e.g misc.forsale /soc.religion.christian)。
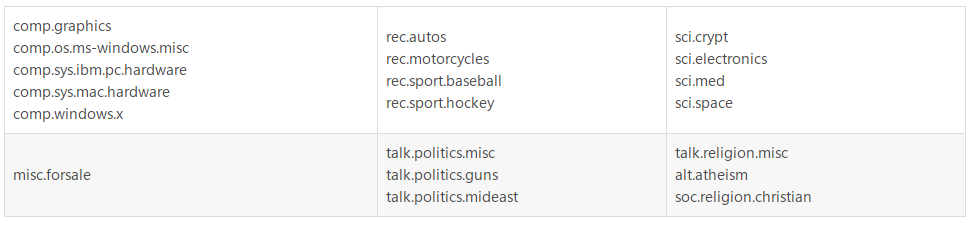
20newsgroups数据集有三个版本:
第一个版本19997是原始的并没有修改过的版本:20news-19997.tar.gz –原始20 Newsgroups数据集
第二个版本bydate是按时间顺序分为训练(60%)和测试(40%)两部分数据集,不包含重复文档和新闻组名(新闻组,路径,隶属于,日期):20news-bydate.tar.gz –按时间分类; 不包含重复文档和新闻组名(18846 个文档)
第三个版本18828不包含重复文档,只有来源和主题:20news-18828.tar.gz– 不包含重复文档,只有来源和主题 (18828 个文档)
在sklearn中,该模型有两种装载方式:
第一种是sklearn.datasets.fetch_20newsgroups,返回一个可以被文本特征提取器(如sklearn.feature_extraction.text.CountVectorizer)自定义参数提取特征的原始文本序列;
第二种是sklearn.datasets.fetch_20newsgroups_vectorized,返回一个已提取特征的文本序列,即不需要使用特征提取器。
2.数据集下载
使用ptyhon进行下载:
from sklearn.datasets import fetch_20newsgroups

corpus_path = './corpora_data'

data_train = fetch_20newsgroups(data_home=corpus_path, subset='train', categories=categories, shuffle=True, random_state=0, remove=remove)

data_test = fetch_20newsgroups(data_home=corpus_path, subset='test', categories=categories, shuffle=True, random_state=0, remove=remove)
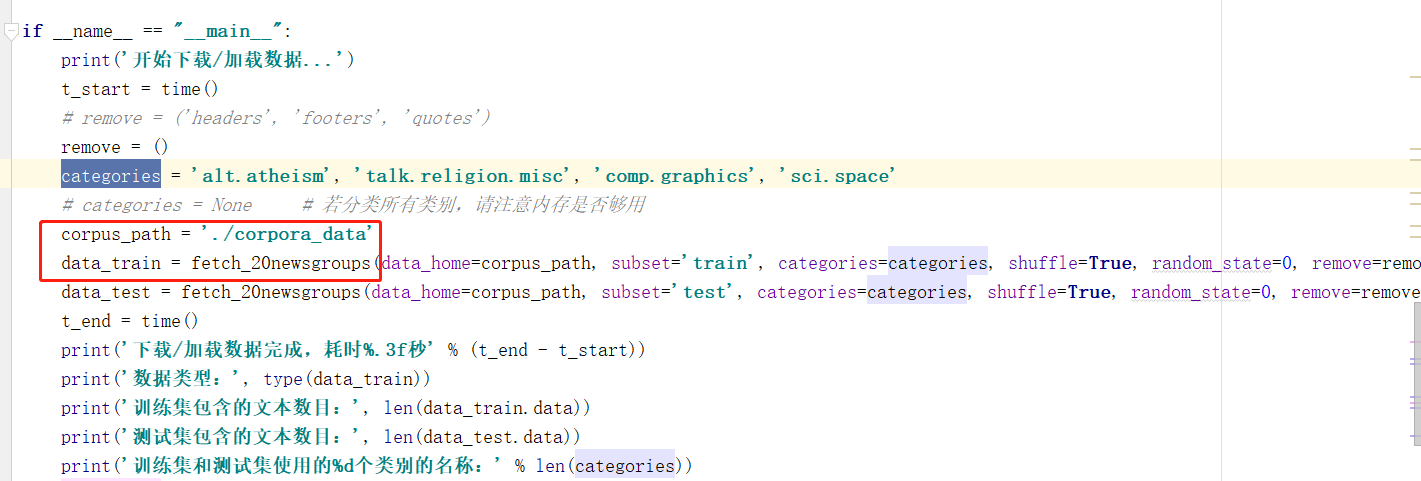
发现真的很卡。。。放弃
3.使用本地数据集
采取第二种方案:
1.下载文件
点击它给出的链接:20news-bydate.tar.gz –按时间分类; 不包含重复文档和新闻组名(18846 个文档)
2.路径修改
(1)下载后直接放在d:盘路径下
(2)
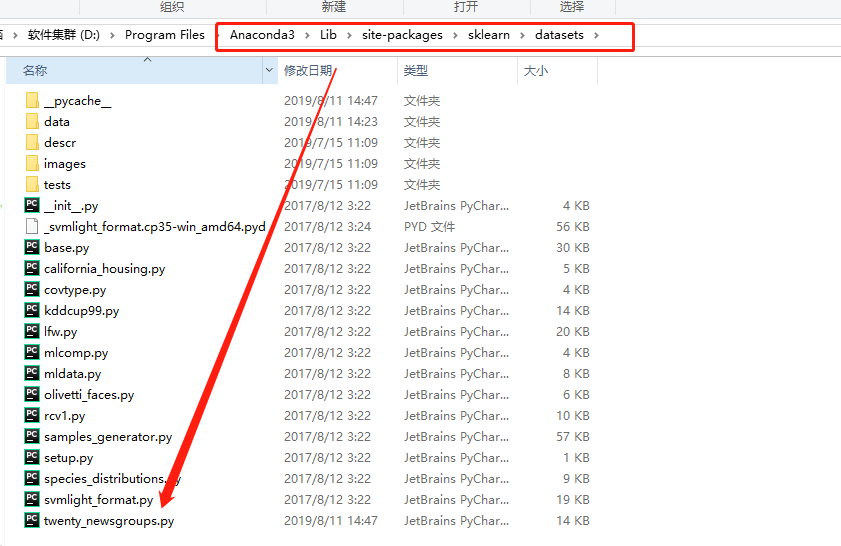
- 找到文件Anaconda3\Lib\site-packages\sklearn\datasets\twenty_newsgroups.py
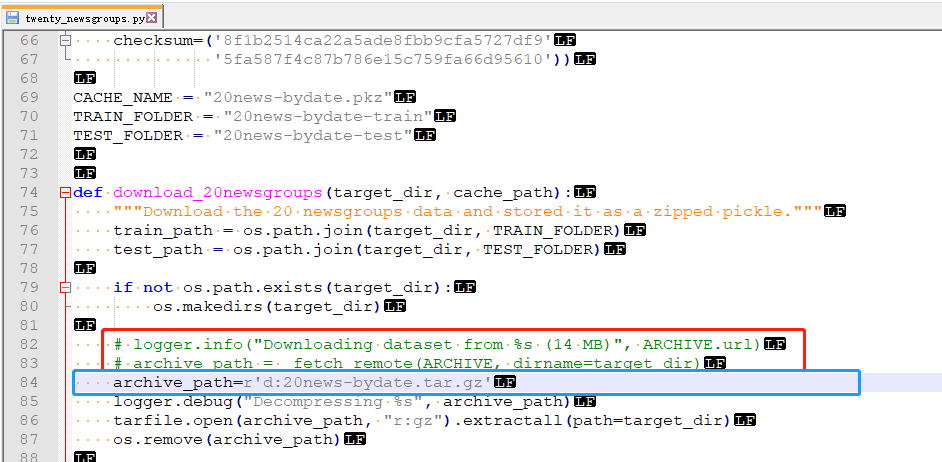
- 修改把在下载的代码注销(红色),增加路径(蓝色)
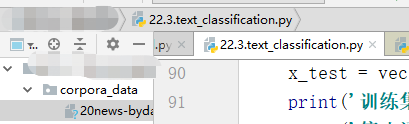
- 检查是否成功:如果在当前项目有如下路径则成功
Newsgroups数据集研究的更多相关文章
- Natural Language Generation/Abstractive Summarization
调研目的: 了解生成式文本摘要的常用技术和当前的发展趋势,明确当前项目有什么样的摘要需求,判断现有技术能否用于满足当前的需求,进一步明确毕业设计方向及其可行性 调研方向: 项目中需要用到摘要的地方以及 ...
- MLLib实践Naive Bayes
引言 本文基于Spark (1.5.0) ml库提供的pipeline完整地实践一次文本分类.pipeline将串联单词分割(tokenize).单词频数统计(TF),特征向量计算(TF-IDF),朴 ...
- 《mahout实战》
<mahout实战> 基本信息 原书名:Mahout in action 作者: (美)Sean Owen Robin Anil Ted Dunning Ellen Fr ...
- 2020厦门大学综述翻译:3D点云深度学习(Remote Sensiong期刊)
目录 摘要 1.引言: 2.点云深度学习的挑战 3.基于结构化网格的学习 3.1 基于体素 3.2 基于多视图 3.3 高维晶格 4.直接在点云上进行的深度学习 4.1 PointNet 4.2 局部 ...
- R语言重要数据集分析研究——需要整理分析阐明理念
1.R语言重要数据集分析研究需要整理分析阐明理念? 上一节讲了R语言作图,本节来讲讲当你拿到一个数据集的时候如何下手分析,数据分析的第一步,探索性数据分析. 统计量,即统计学里面关注的数据集的几个指标 ...
- R语言重要数据集分析研究——R语言数据集的字段含义
R语言数据集的字段含义 作者:马文敏 选择一种数据结构来储存数据 将数据输入或导入到这个数据结构中 数据集的概念 数据集通常是有数据结构的一个矩形数组,行表示规则,列表示变量. 不同的行业对数据集的行 ...
- R语言重要数据集分析研究—— 数据集本身的分析技巧
数据集本身的分析技巧 作者:王立敏 文章来源:网络 1.数据集 数据集,又称为资料集.数据集合或资料集合,是一种由数据所组成的集合. Data set(或dat ...
- R语言重要数据集分析研究——搞清数据的由来
搞清数据的由来 作者:李雪丽 资料来源:百度百科
- [转]最好用的 AI 开源数据集 Top 39:NLP、语音等 6 大类
原文链接 本文修正部分错误. 以下是精心收集的一些非常好的开放数据集,也是做 AI 研究不容错过的数据集. 标签解释 [经典]这些是在 AI 领域中非常著名.众所周知的数据集.很少有研究者或工程师没有 ...
随机推荐
- GPL,BSD,Apache三个开源协定的大体联系及区别
开源许可证GPL.BSD.MIT.Mozilla.Apache和LGPL的区别 以下是上述协议的简单介绍: BSD开源协议 BSD开源协议是一个给于使用者很大自由的协议.基本上使用者可以"为 ...
- 华为HCNA乱学Round 9:VRRP
- 关于SQL关键字"having "
HAVING 子句 在 SQL 中增加 HAVING 子句原因是,WHERE 关键字无法与合计函数一起使用. SQL HAVING 语法 SELECT column_name, aggregate_f ...
- python进程之间的通信——Queue
我们知道进程之间的数据是互不影响的,但有时我们需要在进程之间通信,那怎么办呢? 认识Queue 可以使用multiprocessing模块的Queue实现多进程之间的数据传递,Queue本身是一个消息 ...
- Hive 教程(五)-参数配置
配置基本操作 hive> set; 查看所有配置hive> set key: 查看某个配置hive> set key value: 设置某个配置 我们可以看到一些 hadoop 的配 ...
- EBS描述性弹性域及键弹性域总结
一.描述性弹性域 前言介绍: 描述性弹性域的实质就是系统预留自定字段,系统可以使用说明性弹性域来获取业务所特有的重要附加信息.系统可能自定义说明性弹性域,以显示存储更多信息的字段,提供一套完整的“自定 ...
- Linux经典操作
1.Linux批量终止在运行中包含某个字符串的所有进程. ps -ef|grep celery | grep -v grep|cut -c 9-15|xargs kill -9
- 上海的Costco,谈谈你的理解和感受
众所周知,Costco在上海第一天开业,由于人流量过大,一度暂停营业.我觉得Costco的成功在于不走寻常路,换位思考(站在用户.厂商角度看问题),下面几点是我觉得它做得比较独特的地方: 1. Cos ...
- js中new到底做了什么?如何重写new?
new 构造函数()执行顺序1.在堆中开辟对象内存空间, 记为obj2.在obj 中添加__proto__属性并指向 构造函数.prototype3.将构造函数中的this 指向obj4.执行构造函数 ...
- python CGI环境搭建
本文web服务器使用的为apache. 1. 安装apache yum install -y httpd 2. 配置apache 修改apache配置文件/etc/httpd/conf/httpd.c ...