
机器学习-决策树算法+代码实现(基于R语言)
分类树(决策树)是一种十分常用的分类方法。核心任务是把数据分类到可能的对应类别。
他是一种监管学习,所谓监管学习就是给定一堆样本,每个样本都有一组属性和一个类别,这些类别是事先确定的,通过学习得到一个分类器,这个分类器能够对新出现的对象给出正确的分类。
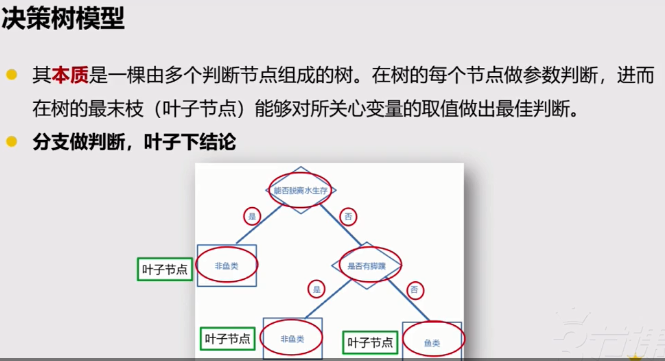
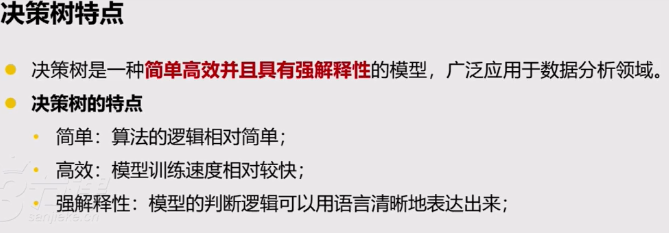
决策树的理解
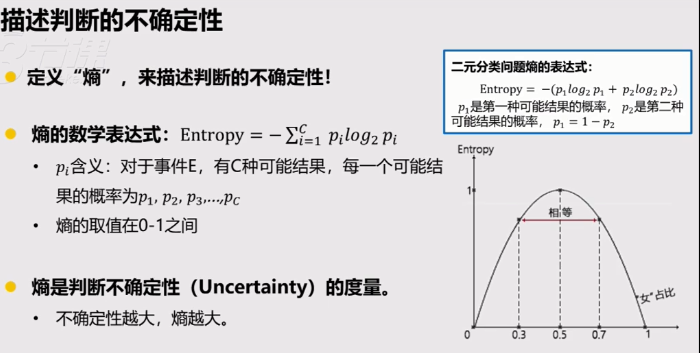
熵的概念对理解决策树很重要
决策树做判断不是百分之百正确,它只是基于不确定性做最优判断。
熵就是用来描述不确定性的。
案例:找出共享单车用户中的推荐者
解析:求出哪一类人群更可能成为共享单车的推荐者。换句话说是推荐者与其他变量之间不寻常的关系。
步骤1
测量节点对应的人群的熵
对于是否推荐这样两分的结果,推荐者比例趋近于0或者1时,熵都为0,推荐者比例趋近于50%时,熵趋近1。
分析师需要根据用户特征,区分出推荐者。通过决策树可以尽可能降低节点人群熵的值(通过决策树不断的分叉)。
步骤2
节点的分叉
不同的分叉方式会得到不同的增益值,计算机会选择最大的增益值,即最优的分叉方式。
详情见后文信息增益相关内容。
步骤3
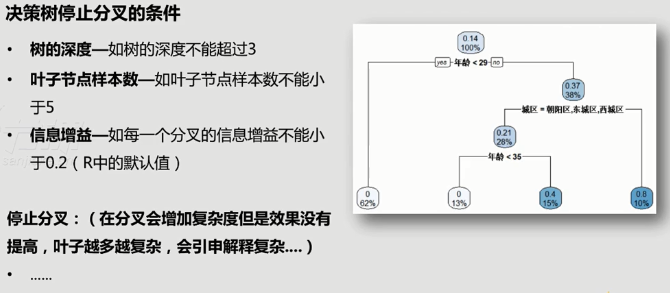
在特定情况下停止分叉。
注意:分支节点太多会把情况搞复杂,反而不利于决策,需要在适当时候停止分叉。
信息增益(IG)的概念
表示经过决策树一次决策后,整个分类数据信息熵下降的大小。

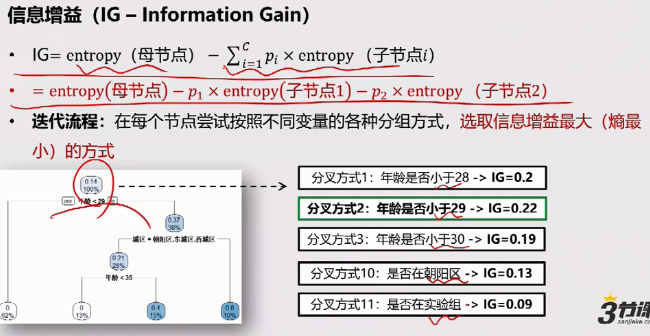
上面求得的IG是母节点的熵减去子节点熵的加权和,得到的结果,是经过一次分叉后所降低的熵的值。
不同的分叉方式会得到不同的增益值,计算机会选择最大的增益值,即最优的分叉方式。
R语言实现
> bike.data <- read.csv(Shared Bike Sample Data - ML.csv)
> library(rpart)
> library(rpart.plot)
> library(rpart.plot)
> bike.data$推荐者 <- bike.data$分数>=9
> rtree_fit <- rpart(推荐者 ~城区+年龄+组别,data=bike.data)
> rpart.plot(rtree_fit)

决策树小结
本质是一种映射关系,将对象的一组属性和对象的值映射到一起,决策树可以和概率完美结合。
优点是:适合处理多类变量,对异常值不敏感,准确度高。
缺点是:
作为一种典型的监督学习算法,在训练时需要大规模数据和计算空间。为了得到最好的决策变量排列顺序,决策树需要反复计算变量的熵信息增益,很耗时间。
决策树是一种贪心算法,每一次决策都谋求最优,追求局部最优的结果是决策树达不到全局最优(与遗传算法比,这是难以回避的缺点)。
决策树剪枝叶技术帮助决策树使用最少的节点完成分类任务,但错误剪枝会使得决策树结果准确性大幅降低,同时剪枝过程也需要大量计算。
决策树不擅长处理连续型变量。当树中连续变量过多时候,决策树犯错误的可能就会增大
机器学习-决策树算法+代码实现(基于R语言)的更多相关文章
- 基于R语言的时间序列指数模型
时间序列: (或称动态数列)是指将同一统计指标的数值按其发生的时间先后顺序排列而成的数列.时间序列分析的主要目的是根据已有的历史数据对未来进行预测.(百度百科) 主要考虑的因素: 1.长期趋势(Lon ...
- 概率图模型 基于R语言 这本书中的第一个R语言程序
概率图模型 基于R语言 这本书中的第一个R语言程序 prior <- c(working =0.99,broken =0.01) likelihood <- rbind(working = ...
- 基于R语言的ARIMA模型
A IMA模型是一种著名的时间序列预测方法,主要是指将非平稳时间序列转化为平稳时间序列,然后将因变量仅对它的滞后值以及随机误差项的现值和滞后值进行回归所建立的模型.ARIMA模型根据原序列是否平稳以及 ...
- Twitter基于R语言的时序数据突变检测(BreakoutDetection)
Twitter开源的时序数据突变检测(BreakoutDetection),基于无参的E-Divisive with Medians (EDM)算法,比传统的E-Divisive算法快3.5倍以上,并 ...
- 机器学习-线性回归(基于R语言)
基本概念 利用线性的方法,模拟因变量与一个或多个自变量之间的关系.自变量是模型输入值,因变量是模型基于自变量的输出值. 因变量是自变量线性叠加和的结果. 线性回归模型背后的逻辑——最小二乘法计算线性系 ...
- 机器学习-K-means聚类及算法实现(基于R语言)
K-means聚类 将n个观测点,按一定标准(数据点的相似度),划归到k个聚类(用户划分.产品类别划分等)中. 重要概念:质心 K-means聚类要求的变量是数值变量,方便计算距离. 算法实现 R语言 ...
- 基于R语言的结构方程:lavaan简明教程 [中文翻译版]
lavaan简明教程 [中文翻译版] 译者注:此文档原作者为比利时Ghent大学的Yves Rosseel博士,lavaan亦为其开发,完全开源.免费.我在学习的时候顺手翻译了一下,向Yves的开源精 ...
- 【转】基于R语言构建的电影评分预测模型
一,前提准备 1.R语言包:ggplot2包(绘图),recommenderlab包,reshape包(数据处理) 2.获取数据:大家可以在明尼苏达州大学的社会化计算研 ...
- 中文分词实践(基于R语言)
背景:分析用户在世界杯期间讨论最多的话题. 思路:把用户关于世界杯的帖子拉下来.然后做中文分词+词频统计,最后将统计结果简单做个标签云.效果例如以下: 兴许:中文分词是中文信息处理的基础.分词之后.事 ...
随机推荐
- luogu P3411 序列变换
链接 P3411 序列变换 如果要最小化答案,那么就最大化不移动的数. 那么不移动的子序列一定是最后答案的一段连续区间,而移动的数我们是一定有办法把他们还原的. 设\(f_{i}\)表示\(i\)点的 ...
- Java集合(容器)学习
1.集合和数组有什么区别,为什么使用集合而不用数组? 相同点:集合和数组都可以存储多个对象,对外作为一个整体存在. 数组的缺点: 长度必须在初始化时指定,且固定不变: 数组采用连续存储空间,删除和添加 ...
- 1.Linux安装redis
Linux安装redis 操作系统是Centos7 1.下载压缩包 2.解压 3.编译 4.启动redis 5.设置redis.conf和防火墙端口开放,外网可以访问 1.下载压缩包 下载地址:htt ...
- LeetCode--056--合并区间(java)
给出一个区间的集合,请合并所有重叠的区间. 示例 1: 输入: [[1,3],[2,6],[8,10],[15,18]] 输出: [[1,6],[8,10],[15,18]] 解释: 区间 [1,3] ...
- Linux 系统参数优化
修改系统所有进程可打开的文件数量 sysctl -w fs.file-max=2097152sysctl -w fs.nr_open=2097152 > vi /etc/sysctl.conff ...
- discuz x3.2设置注册邮件激活_企业邮箱发送邮件失败
在discuz x2.5邮箱设置里面已经说了很多关于邮件设置和常见问题的处理办法了,今天这里主要是说明下Discuz! 邮件发送失败排查思路,适用于任何板块的Discuz程序. Discuz! 邮件发 ...
- ruby类对象和对象
class Box def initialize(w,h) @width,@height=w,h end def getArea puts "class of self #{self.cla ...
- jQuery中的serializer序列化—炒鸡好用
jQuery.serializer()序列化 serialize()函数用于序列化一组表单元素,将表单内容编码为用于提交的字符串. serialize()函数常用于将表单内容序列化,以便用于AJAX提 ...
- Java的常用类 String
String类: 代表字符串, java程序中的所有字符串字面值(如, "abc")都是此类的实例实现 String是一个final类,代表不可变的字符序列 字符串是常量是用双引号 ...
- Redux生态系统
生态系统 Redux 是一个体小精悍的库,但它相关的内容和 API 都是精挑细选的,足以衍生出丰富的工具集和可扩展的生态系统. 如果需要关于 Redux 所有内容的列表,推荐移步至 Awesome R ...