
python-爬取糗事百科热图
此次运用requests和beautifulSoup爬取糗事百科热图,常用的网络库有:urllib,urllib3,requests,选取其中之一就行了;HTML/XML解析器有:lxml,BeautifulSoup,html5lib,selenium,re等。
如果经常爬虫,觉得可以固定选择一种网络库和页面解析器,否则太多了不容易记住,主要思路就是访问页面(网络库)--分析页面元素(可通过浏览区F12查看)--提取需要的数据(页面解析器)。
在爬取的过程中发现,最好headers信息填的全一些,否则会报404错。示例代码:
# -*- coding:utf-8 -*-

from bs4 import BeautifulSoup

import requests

import re

import os

def parseHtml(allPageUrls,headers):

    imgUrls = []

    for i in allPageUrls:

        html = requests.get(i, headers=headers).text

        soup = BeautifulSoup(html, 'lxml').find_all('img', class_="illustration")

        for url in soup:

            #imgUrls.append('http:' + re.findall('src="(\S+)"', str(url))[0])   #也可用正则查找

            imgUrls.append('http:' + url['src'])

    return imgUrls

def downloadImages(urls,path):

    global count

    if not os.path.exists(path):

        print("Download path error!")

        pass

    else:

        path = path.rstrip('/')

    for i in urls:

        count += 1

        img = requests.get(i).content

        with open(path + '//{0}.jpg'.format(count),'wb') as f:

            f.write(img)

def getAllPageUrls(baseUrl,headers):

    allPageUrls = []

    allPageUrls.append(baseUrl)

    html = requests.get(baseUrl, headers=headers).text

    pageNum = BeautifulSoup(html,'lxml').find_all('span',class_='page-numbers')[-1].text.strip()

    for num in range(int(pageNum)):

        if num >= 2:

           allPageUrls.append(baseUrl + 'page/{0}/'.format(num))

    return allPageUrls

def main():

    baseUrl = "https://www.qiushibaike.com/imgrank/"

    headers = {

        "User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:67.0) Gecko/20100101 Firefox/67.0",

        # "Host":"static.qiushibaike.com",

        "Accept": "text/css,*/*;q=0.1",

        "Accept-Encoding": "gzip, deflate, br",

        "Accept-Language": "zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2",

        "Connection": "keep-alive",

        "Cookie": 'Hm_lvt_2670efbdd59c7e3ed3749b458cafaa37=1564111558; Hm_lpvt_2670efbdd59c7e3ed3749b458cafaa37=1564111562; BAIDU_SSP_lcr=https://www.baidu.com/link?url=jWhGNGV5ALzyB_BRJKkXdeb60lmYQ3_Lewk3NHsLe_C9fvNwKDdTPwZDtD2GrY15&wd=&eqid=b4f829d300000e94000000045d3a72c3; _qqq_uuid_="2|1:0|10:1564111558|10:_qqq_uuid_|56:OWQxZTVlNjY4MWY2MjVmOTdjODkwMDE3MTEwZTQ0ZTE2ZGU4NTA1NA==|971036a31548dd5a201f29c949b56990b4895dee0e489693b7b9631f363ca452"; _ga=GA1.2.126854589.1564111558; _gid=GA1.2.839365496.1564111558; _gat=1',

        "TE": "Trailers"

    }

    allPageUrls = getAllPageUrls(baseUrl, headers)  #获取所有页面的访问地址

    allImageUrls = parseHtml(allPageUrls, headers)  #获取所有页面中图片地址

    downloadImages(allImageUrls,'e://qiushibaike')  #下载图片

if __name__ == '__main__':

    count = 0

    main()
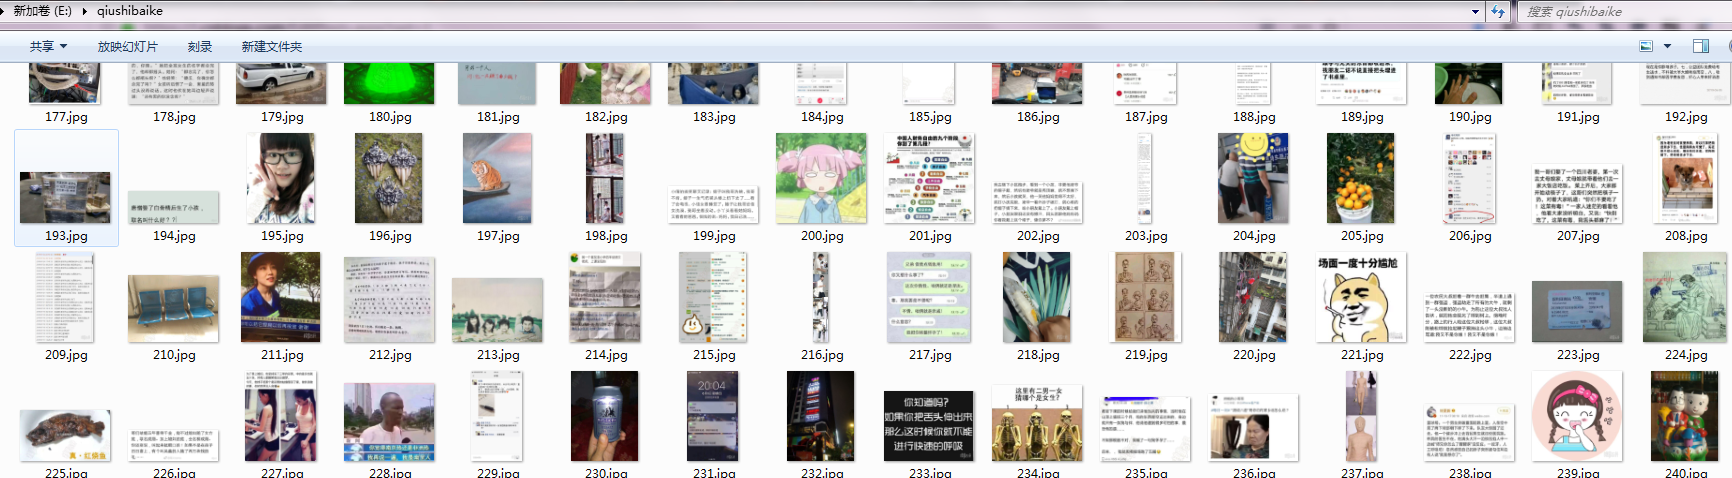
运行结果:
python-爬取糗事百科热图的更多相关文章
- python爬取糗事百科段子
初步爬取糗事百科第一页段子(发布人,发布内容,好笑数和评论数) #-*-coding:utf--*- import urllib import urllib2 import re page = url ...
- Python爬取糗事百科
import urllib import urllib.request from bs4 import BeautifulSoup """ 1.抓取糗事百科所有纯 ...
- python 爬取糗事百科 gui小程序
前言:有时候无聊看一些搞笑的段子,糗事百科还是个不错的网站,所以就想用Python来玩一下.也比较简单,就写出来分享一下.嘿嘿 环境:Python 2.7 + win7 现在开始,打开糗事百科网站,先 ...
- Python爬取糗事百科示例代码
参考链接:http://python.jobbole.com/81351/#comment-93968 主要参考自伯乐在线的内容,但是该链接博客下的源码部分的正则表达式部分应该是有问题,试了好几次,没 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 8.Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- python网络爬虫--简单爬取糗事百科
刚开始学习python爬虫,写了一个简单python程序爬取糗事百科. 具体步骤是这样的:首先查看糗事百科的url:http://www.qiushibaike.com/8hr/page/2/?s=4 ...
- python学习(十六)写爬虫爬取糗事百科段子
原文链接:爬取糗事百科段子 利用前面学到的文件.正则表达式.urllib的知识,综合运用,爬取糗事百科的段子先用urllib库获取糗事百科热帖第一页的数据.并打开文件进行保存,正好可以熟悉一下之前学过 ...
随机推荐
- poj2166 Heapsort[构造递推]
构造一个n个点的大根堆让全部弹出时交换位置次数最多. 真心佩服我自己智商,这种题都做不出来 交换是在每次弹出堆顶,然后把堆尾元素置于堆顶,然后向下调整时产生的.玩样例可以发现似乎数字1每次都出现在堆最 ...
- JavaScript原型初学者指南
视频Videohttps://www.youtube.com/watch... 前言 如果不好好的学习对象,你就无法在JavaScript中获得很大的成就.它们几乎是JavaScript编程语言的每个 ...
- http协议和i/o模型
http协议----基于请求报文和响应报文完成一次http事务 应用层协议格式有两种: 文本(开发容易,但交互解析困难如http smtp),二进制(交互解析容易,但理解起来困难memocache) ...
- Hibernate 缓存机制详细分析
在本篇随笔里将会分析一下hibernate的缓存机制,包括一级缓存(session级别).二级缓存(sessionFactory级别)以及查询缓存,当然还要讨论下我们的N+1的问题. 随笔虽长,但我相 ...
- 科普TPF知识
https://tieba.baidu.com/p/4926092734?see_lz=1&pn=1 707680700 https://tieba.baidu.com/p/492609273 ...
- 上传文件夹 vue
ASP.NET上传文件用FileUpLoad就可以,但是对文件夹的操作却不能用FileUpLoad来实现. 下面这个示例便是使用ASP.NET来实现上传文件夹并对文件夹进行压缩以及解压. ASP.NE ...
- 在百度ueditor上粘贴从word中copy的图片和文字 图片无法显示的问题
我这边从world 里面复制粘贴图片到编辑器中,它自动给我上传了,但是我是用的第三方的要设置一个token值,我找了很久,也没有找到应该在哪里设置这个上传的参数,如果是点击图片上传,我知道在dialo ...
- 成功解决internal/modules/cjs/loader.js:596 throw err; ^ Error: Cannot find module 'minimatch'
成功解决internal/modules/cjs/loader.js:596 throw err; ^ Error: Cannot find module 'minimatch' 解决办法 npm i ...
- task.delay 和 thread.sleep
1.Thread.Sleep 是同步延迟. Task.Delay异步延迟. 2.Thread.Sleep 会阻塞线程,Task.Delay不会. 3.Thread.Sleep不能取消,Task.Del ...
- [CSP-S模拟测试]:小L的数(数位DP+模拟)
题目传送门(内部题132) 输入格式 第一行一个整数$t$. 接下来$t$行每行一个整数$n$. 输出格式 $t$行,每行一个整数表示答案. 样例 样例输入: 41818231232691052109 ...