
在 Ubuntu 上搭建 Hadoop 分布式集群 Eclipse 开发环境
一直在忙Android FrameWork,终于闲了一点,利用空余时间研究了一下Hadoop,并且在自己和同事的电脑上搭建了分布式集群,现在更新一下blog,分享自己的成果。
一 .环境
1.操作系统:Ubuntu 12.04 LTS 64位
2.Java版本:openjdk-7-jdk
3.Hadoop版本:2.6.0
4.结点信息:
|
机器名 |
IP |
hostname |
作用 |
|
master |
10.13.14.83 |
rdcdz140395 |
NameNode and JobTracker |
|
slave-1 |
10.13.14.110 |
rdjdz110716 |
DataNode and TaskTracker |
|
slave-2 |
10.13.14.127 |
rdjdz120312 |
DataNode and TaskTracker |
5.我在每台机器上创建了群组hadoop和用户hduser,并将hduser加入到hadoop群组中,方便管理。
二.安装
1.在这3台电脑上都安装 jdk,ssh,maven
sudo apt-get update

sudo apt-get install openjdk--jdk

sudo apt-get install ssh

sudo apt-get install rsync

sudo apt-get install maven

sudo apt-get update
2.在这3台电脑上都添加Hadoop用户组和用户hduser
sudo addgroup hadoop

sudo adduser --ingroup hadoop hduser

sudo adduser hduser sudo
然后切换到hduser账户,进行下面的操作。
su - hduser
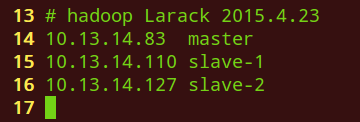
3.修改集群中所有机器的/etc/hosts
10.13.14.83  master

10.13.14.110 slave-

10.13.14.127 slave-
如下图所示
4.建立SSH无密码登录
在Hadoop启动以后,namenode是通过SSH(Secure Shell)来启动和停止各个节点上的各种守护进程的,这就需要在节点之间执行指令的时候是不需要输入密码的方式,故我们需要配置SSH使用无密码公钥认证的方式。
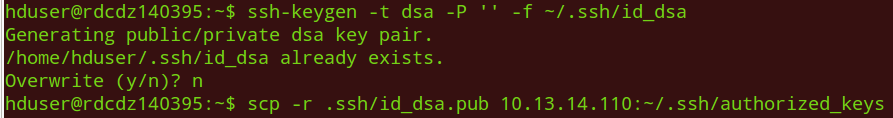
使用下面的命令会在~/.ssh/目录下生成 id_dsa.pub文件,如果我们希望master 结点不需要密码就能使用ssh连接到slave结点,我们需要将master结点上的~/.ssh/id_dsa.pub的内容,添加到slave结点的~/.ssh,并将id_dsa.pub重命名为authorized_keys
ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa

scp -r /home/hduser/.ssh/id_dsa.pub hduser@10.13.14.110:/home/hduser/.ssh/authorized_keys

scp -r /home/hduser/.ssh/id_dsa.pub hduser@10.13.14.127:/home/hduser/.ssh/authorized_keys
5.下载&安装Hadoop
下载Hadoop 解压到master服务器的/home/hduser目录下(配置好master结点后再将其复制到其它的服务器上,一般来说,群集中所有的hadoop都安装在同一目录下)
cd ~

wget http://www.trieuvan.com/apache/hadoop/common/hadoop-2.6.0/hadoop-2.6.0.tar.gz

sudo tar -xzvf hadoop-2.6..tar.gz -C /usr/local

cd /usr/local

sudo mv hadoop-2.6. hadoop

sudo chown -R hduser:hadoop hadoop
6.配置Hadoop环境
(1)修改.bashrc
vim ~/.bashrc
将下面的内容复制到.bashrc最后一行
## Hadoop variables ,start of paste

export JAVA_HOME=/usr/lib/jvm/java--openjdk-amd64

export HADOOP_INSTALL=/usr/local/hadoop

export PATH=$PATH:$HADOOP_INSTALL/bin

export PATH=$PATH:$HADOOP_INSTALL/sbin

export HADOOP_MAPRED_HOME=$HADOOP_INSTALL

export HADOOP_COMMON_HOME=$HADOOP_INSTALL

export HADOOP_HDFS_HOME=$HADOOP_INSTALL

export YARN_HOME=$HADOOP_INSTALL

###end of paste
7.配置Hadoop
(1)修改 hadoop-env.sh
cd /usr/local/hadoop/etc/hadoop

vim hadoop-env.sh
将下面的三行加入到hadoop-env.sh中,删除原来的 "export JAVA_HOME"那行
# begin of paste

export JAVA_HOME=/usr/lib/jvm/java--openjdk-amd64/

export HADOOP_COMMON_LIB_NATIVE_DIR="/usr/local/hadoop/lib/native/"

export HADOOP_OPTS="$HADOOP_OPTS -Djava.library.path=/usr/local/hadoop/lib/"

### end of paste
(2)修改 core-site.xml
vim core-site.xml
将下面的内容复制到 <configuration> 标签内
<property>

   <name>fs.default.name</name>

   <value>hdfs://master:9000</value>

</property>
<property>
  <name>hadoop.tmp.dir</name>
  <value>/usr/local/hadoop/tmp</value>
</property>
(3)修改 yarn-site.xml
vim yarn-site.xml
将下面的内容复制到 <configuration> 标签内
<property>

  <name>yarn.nodemanager.aux-services</name>

  <value>mapreduce_shuffle</value>

</property>

<property>

  <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>

  <value>org.apache.hadoop.mapred.ShuffleHandler</value>

</property>
(4)修改 mapred-site.xml
mv mapred-site.xml.template mapred-site.xml

vim mapred-site.xml
将下面的内容复制到 <configuration> 标签内
<property>

   <name>mapreduce.framework.name</name>

   <value>yarn</value>

</property>
<property>
 <name>mapred.job.tracker</name>
 <value>master:9001</value>
</property>
(5)修改 hdfs-site.xml
mkdir -p ~/mydata/hdfs/namenode

mkdir -p ~/mydata/hdfs/datanode

vim hdfs-site.xml
将下面的内容复制到 <configuration> 标签内
<property>

   <name>dfs.replication</name>

   <value></value>

 </property>

 <property>

   <name>dfs.namenode.name.dir</name>

   <value>file:/home/hduser/mydata/hdfs/namenode</value>

 </property>

 <property>

   <name>dfs.datanode.data.dir</name>

   <value>file:/home/hduser/mydata/hdfs/datanode</value>

 </property>
8.安装 protobuf-2.5.0 or later
curl -# -O https://protobuf.googlecode.com/files/protobuf-2.5.0.tar.gz

tar -xzvf protobuf-2.5..tar.gz

cd protobuf-2.5.

./configure --prefix=/usr

make

sudo make install

cd ..

mvn package -Pdist,native -DskipTests -Dtar
三.启动
1.格式化 namenode
hdfs namenode -format
2.启动服务
start-dfs.sh && start-yarn.sh
3.使用jps查看服务
jps
4.在浏览器上查看
Cluster status: http://localhost:8088
HDFS status: http://localhost:50070
Secondary NameNode status: http://localhost:50090
参考文档:http://blog.csdn.net/feixia586/article/details/24950111
在 Ubuntu 上搭建 Hadoop 分布式集群 Eclipse 开发环境的更多相关文章
- 超快速使用docker在本地搭建hadoop分布式集群
超快速使用docker在本地搭建hadoop分布式集群 超快速使用docker在本地搭建hadoop分布式集群 学习hadoop集群环境搭建是hadoop入门的必经之路.搭建分布式集群通常有两个办法: ...
- 使用docker搭建hadoop分布式集群
使用docker搭建部署hadoop分布式集群 在网上找了非常长时间都没有找到使用docker搭建hadoop分布式集群的文档,没办法,仅仅能自己写一个了. 一:环境准备: 1:首先要有一个Cento ...
- 分布式计算(一)Ubuntu搭建Hadoop分布式集群
最近准备接触分布式计算,学习分布式计算的技术栈和架构知识.目前的分布式计算方式大致分为两种:离线计算和实时计算.在大数据全家桶中,离线计算的优秀工具当属Hadoop和Spark,而实时计算的杰出代表非 ...
- 使用Docker在本地搭建Hadoop分布式集群
学习Hadoop集群环境搭建是Hadoop入门必经之路.搭建分布式集群通常有两个办法: 要么找多台机器来部署(常常找不到机器) 或者在本地开多个虚拟机(开销很大,对宿主机器性能要求高,光是安装多个虚拟 ...
- CentOS7.5搭建Hadoop分布式集群
材料:3台虚拟主机,ip分别为: 192.168.1.201 192.168.1.202 192.168.1.203 1.配置主机名称 三个ip与主机名称分别对应关系如下: 192.168.1.201 ...
- Hadoop集群 -Eclipse开发环境设置
1.Hadoop开发环境简介 1.1 Hadoop集群简介 Java版本:jdk-6u31-linux-i586.bin Linux系统:CentOS6.0 Hadoop版本:hadoop-1.0.0 ...
- Hadoop HA集群 与 开发环境部署
每一次 Hadoop 生态的更新都是如此令人激动 像是 hadoop3x 精简了内核,spark3 在调用 R 语言的 UDF 方面,速度提升了 40 倍 所以该文章肯定得配备上最新的生态 hadoo ...
- VM搭建hadoop分布式集群
1. 安装VMware Workstation Pro 2.安装Ubuntu-16.04 3.以下全程使用sudo –s 切换root权限 4.更新deb软件包列表:apt-get update 5 ...
- Hadoop分布式集群搭建hadoop2.6+Ubuntu16.04
前段时间搭建Hadoop分布式集群,踩了不少坑,网上很多资料都写得不够详细,对于新手来说搭建起来会遇到很多问题.以下是自己根据搭建Hadoop分布式集群的经验希望给新手一些帮助.当然,建议先把HDFS ...
随机推荐
- Codeforces Round #475 (Div. 2)
B. Messages 题意:有n个消息分别在ti的时候收到.设所有消息收到时初始值为A,每过一秒,其值减去B.当在某一秒选择读某个消息时,获值为当前消息的值:如果在某一秒结束的时候,手上有k则消息未 ...
- HackerRank - common-child【DP】
HackerRank - common-child[DP] 题意 给出两串长度相等的字符串,找出他们的最长公共子序列e 思路 字符串版的LCS AC代码 #include <iostream&g ...
- 多种数据库之间 update的不同
sql server update a set a.gqdltks=b.gqdltks,a.bztks=b.bztks from landleveldata a,gdqlpj b where a.GE ...
- springboot-vue项目后台2---pojo对查询结果手动分组
<resultMap id="PResult" type="packs" > <result column="device_type ...
- ng-click得到当前元素,
直接上代码: <!DOCTYPE html> <html> <head> <title></title> <script src=&q ...
- Linux网络配置脚本
#!/bin/bash ip=$1 if [ -f "/etc/sysconfig/network-scripts/ifcfg-bond1" ] then break else # ...
- 20145219 《Java程序设计》第01周学习总结
20145219 <Java程序设计>第01周学习总结 教材学习内容总结 软件分类:系统软件(DOS.Windows.Linux等).应用软件(扫雷.QQ等) 人机交互方式:图形化界面.命 ...
- socket IPC(本地套接字 domain)
1.简介 socket API原本是为网络通讯设计的,但后来在socket的框架上发展出一种IPC机制,就是UNIX Domain Socket.虽然网络socket也可用于同一台主机的进程间通讯(通 ...
- Oracle数据库的数据导入导出
--备份数据库--数据库系统用户账号system/adminuser --查看oracle数据库的用户select * from all_users;--查看oracle数据库的版本号select * ...
- MyEclipse/Eclipse中properties文件中文乱码问题解决
有时候在myeclipse或者eclipse中打开properties文件时会发现其中的中文都是乱码.这是由于当前的properties文件编码格式不支持汉字造成的.当这种情况发生时,我们可以按照以下 ...