
Spark基本术语表+基本架构+基本提交运行模式
一、Spark基本术语表
转载自:http://blog.csdn.net/simple_the_best/article/details/70843756
以下内容来自 http://spark.apache.org/docs/2.1.0/cluster-overview.html#glossary , 需要对 spark 的整个运行过程有所了解才能真正理解这些术语的涵义.
可以先看一下 http://dblab.xmu.edu.cn/blog/972-2 了解一下概况.
| 术语 | 术语简译 | 涵义 |
|---|---|---|
| application | 应用 | 基于 Spark 构建的用户程序. 一般包括了集群上的一个 driver 程序与多个 executor |
| application jar | 应用的 jar 包 | 包含了用户的 Spark application 的一个 jar 包. 在某些情况下用户可能想要创建一个囊括了应用及其依赖的 “超级” jar 包. 但实际上, 用户的 jar 不应该包括 Hadoop 或是 Spark 的库, 这些库会在运行时被进行加载. |
| driver program | 驱动程序 | 运行 application 的 main() 函数和创建 SparkContext 的进程. |
| cluster manager | 集群管理器 | 获取集群资源的一个外部服务, 比如 standalone 管理器, Mesos 和 YARN. |
| deploy mode | 部署模式 | 区分 driver 进程在何处运行. 在 “cluster” 模式下, 框架在集群内部运行 driver. 在 “client” 模式下, 提交者在集群外部运行 driver. |
| worker node | 工作节点 | 集群内任一能够运行 application 代码的节点 |
| executor | 执行者 | 在 worker node 上 application 启动的一个进程, 该进程运行 task 并在内存或磁盘上保存数据. 每个 application 都有其独有的 executor. |
| task | 任务 | 发送到一个 executor 的一系列工作 |
| job | 作业 | 由多个 task 组成的一个并行计算, 这些 task 产生自一个 Spark action (比如, save, collect) 操作. 在 driver 的日志中可以看到 job 这个术语. |
| stage | 阶段 | 每个 job 被分解为多个 stage, 每个 stage 其实就是一些 task 的集合, 这些 stage 之间相互依赖 (与 MapReduce 中的 map 与 reduce stage 类似). 在 driver 的日志中可以看到 stage 这个术语. |
Spark 内部术语解释
- Application:基于 Spark 的用户程序,包含了 driver 程序和集群上的 executor;
- Driver Program:运行 main 函数并且新建 SparkContext 的程序;
- Cluster Manager:在集群上获取资源的外部服务 (例如:standalone,Mesos,Yarn);
- Worker Node:集群中任何可以运行应用代码的节点;
- Executor:是在一个 worker node 上为某应用启动的一个进程,该进程负责运行任务,并且负责将数据存在内存或者磁盘上。每个应用都有各自独立的 executors;
- Task:被送到某个 executor 上的工作单元;
- Job:包含很多任务的并行计算,可以与 Spark 的 action 对应;
- Stage:一个 Job 会被拆分很多组任务,每组任务被称为 Stage(就像 Mapreduce 分 map 任务和 reduce 任务一样)。
二、Spark基本架构
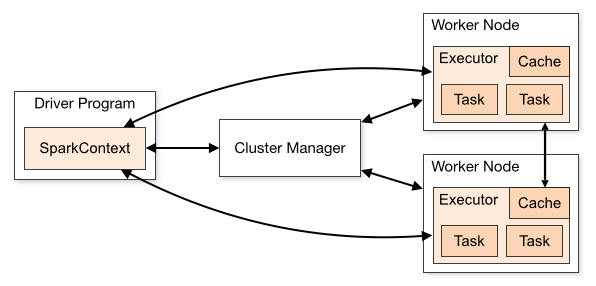
Spark运行架构包括集群资源管理器(Cluster Manager)、运行作业任务的工作节点(Worker Node)、每个应用的任务控制节点(Driver)和每个工作节点上负责具体任务的执行进程(Executor)。其中,集群资源管理器可以是Spark自带的资源管理器,也可以是YARN或Mesos等资源管理框架。
与Hadoop MapReduce计算框架相比,Spark所采用的Executor有两个优点:一是利用多线程来执行具体的任务(Hadoop MapReduce采用的是进程模型),减少任务的启动开销;二是Executor中有一个BlockManager存储模块,会将内存和磁盘共同作为存储设备,当需要多轮迭代计算时,可以将中间结果存储到这个存储模块里,下次需要时,就可以直接读该存储模块里的数据,而不需要读写到HDFS等文件系统里,因而有效减少了IO开销;或者在交互式查询场景下,预先将表缓存到该存储系统上,从而可以提高读写IO性能。
在Spark中,一个应用(Application)由一个任务控制节点(Driver)和若干个作业(Job)构成,一个作业由多个阶段(Stage)构成,一个阶段由多个任务(Task)组成。当执行一个应用时,任务控制节点会向集群管理器(Cluster
Manager)申请资源,启动Executor,并向Executor发送应用程序代码和文件,然后在Executor上执行任务,运行结束后,执行结果会返回给任务控制节点,或者写到HDFS或者其他数据库中。
三、Spark基本提交(submit)运行模式
1、client mode(本地模式)
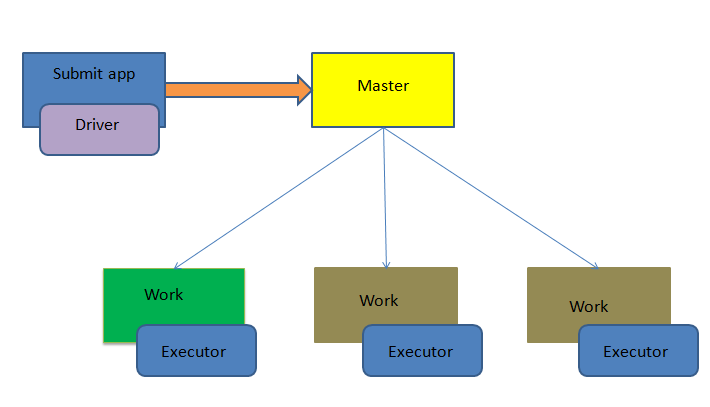
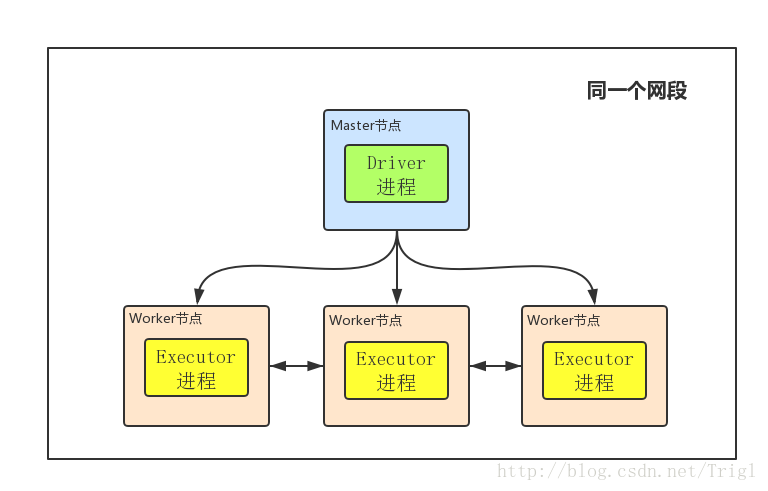
首先明白几个基本概念:Master节点就是你用来提交任务,即执行bin/spark-submit命令所在的那个节点;Driver进程就是开始执行你Spark程序的那个Main函数,虽然这里边画的Driver进程在Master节点上,但注意Driver进程不一定在Master节点上,它可以在任何节点;Worker就是Slave节点,Executor进程必然在Worker节点上,用来进行实际的计算
①client mode下Driver进程运行在Master节点上,不在Worker节点上,所以相对于参与实际计算的Worker集群而言,Driver就相当于是一个第三方的“client”
②正由于Driver进程不在Worker节点上,所以其是独立的,不会消耗Worker集群的资源
③client mode下Master和Worker节点必须处于同一片局域网内,因为Drive要和Executorr通信,例如Drive需要将Jar包通过Netty HTTP分发到Executor,Driver要给Executor分配任务等
④client mode下没有监督重启机制,Driver进程如果挂了,需要额外的程序重启。
2、cluster mode(集群模式)
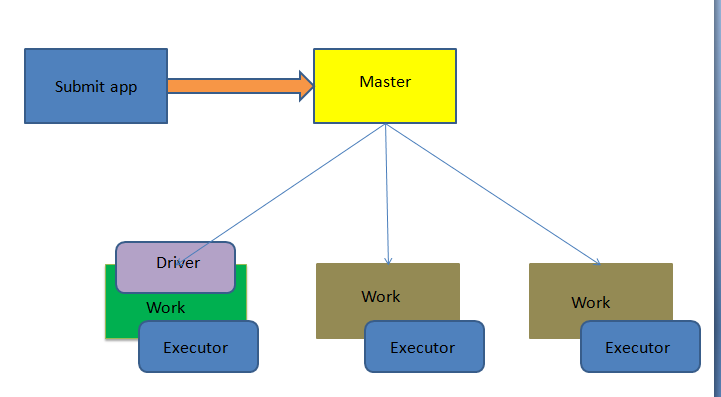
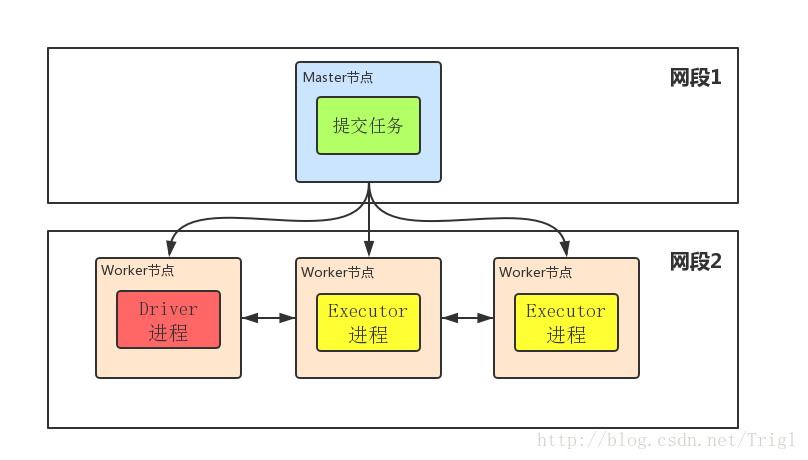
①Driver程序在worker集群中某个节点,而非Master节点,但是这个节点由Master指定
②Driver程序占据Worker的资源
③cluster mode下Master可以使用–supervise对Driver进行监控,如果Driver挂了可以自动重启
④cluster mode下Master节点和Worker节点一般不在同一局域网,因此就无法将Jar包分发到各个Worker,所以cluster mode要求必须提前把Jar包放到各个Worker几点对应的目录下面。
Spark基本术语表+基本架构+基本提交运行模式的更多相关文章
- 3 weekend110的job提交的逻辑及YARN框架的技术机制 + MR程序的几种提交运行模式
途径1: 途径2: 途径3: 成功! 由此,可以好好比较下,途径1和途径2 和途径3 的区别. 现在,来玩玩weekend110的joba提交的逻辑之源码跟踪 原来如此,weekend110的job提 ...
- Spark源码分析之一:Job提交运行总流程概述
Spark是一个基于内存的分布式计算框架,运行在其上的应用程序,按照Action被划分为一个个Job,而Job提交运行的总流程,大致分为两个阶段: 1.Stage划分与提交 (1)Job按照RDD之间 ...
- Hadoop中MR程序的几种提交运行模式
本地模型运行 1:在windows的eclipse里面直接运行main方法,就会将job提交给本地执行器localjobrunner执行 ----输入输出数据可以放在本地路径下(c:/wc ...
- MapReduce程序的几种提交运行模式
本地模型运行 1/在windows的eclipse里面直接运行main方法,就会将job提交给本地执行器localjobrunner执行 ----输入输出数据可以放在本地路径下(c:/wc/ ...
- MR程序的几种提交运行模式
本地模式运行 1-在windows的eclipse里面直接运行main方法 将会将job提交给本地执行器localjobrunner 输入输出数据可以放在本地路径下 输入输出数据放在HDFS中:(hd ...
- 理解Spark运行模式(一)(Yarn Client)
Spark运行模式有Local,STANDALONE,YARN,MESOS,KUBERNETES这5种,其中最为常见的是YARN运行模式,它又可分为Client模式和Cluster模式.这里以Spar ...
- W3C词汇和术语表
以A字母开头的词汇 英文 中文 abstract module 抽象模组 access 访问.存取 access control 存取控制 access control information 存取控 ...
- git-it 教程,一些git知识点。/ 如何解决merge conflict/ 如何使用Github Pages./Git术语表
一个git使用教程 https://:.com/jlord/git-it-electron#what-to-install 一个在线Github的功能教学:https://lab.github.com ...
- Unreal引擎术语表
转自:http://www.cnblogs.com/hmxp8/archive/2012/02/10/2345274.html Unreal引擎术语表 转载自UDN: Actor - 一个可以放置在 ...
随机推荐
- wx小程序横向滚动
.subOper>scroll-view{ margin-bottom: 22rpx; width: 100%; white-space: nowrap; } /* subClass 是scro ...
- Makefile 中 ifeq ifneq 等用法
(1)ifeq的用法 ifeq ($(变量名), 变量值 ) ........ else ifeq ($(..), ..) ......... else ......... endif (2)最近在学 ...
- lava.lang.String数据转换为java.sql.Date
在JavaWeb编程中,往往涉及数据库,javaBean,前端数据数据类型不一致的问题 数据库和javaBean之间可以直接选择相对应的数据类型,而serverlet从前端获取的数据往往是String ...
- C 语言经典面试题 —— 宏
1. 运算符优先级与括号 #define Cube(a) a*a*a 无法解决 Cube(1+1) ⇒ 1+1*1+1*1+1 ⇒ 4,期待的应当是 8,故将其改造为 #define Cube(a) ...
- advanced ip scanner —— 局域网下 ip 及设备的扫描
advanced ip scanner 下载地址:Advanced IP Scanner - Download Free Network Scanner. 用于扫描当前局域网下全部设备及其 ip,构建 ...
- pytorch基础教程1
0.迅速入门:根据上一个博客先安装好,然后终端python进入,import torch ******************************************************* ...
- 将scrapy项目运行在pycharm中
1.在scrapy项目中创建一个py脚本,且尽量在scrapy.cfg同级目录下.我创建的是begin.py 2.配置begin.py.写上这一句就相等于一点开始,就在终端上输入了scrapy cra ...
- 测试那些事儿—简述CPU的工作原理
简单介绍CPU的工作原理 1.内部架构 CPU是由晶体管组成,其根本任务就是执行指令和数据处理,对计算机来说,就是由0和1组成的序列.CPU从逻辑上可分为3个模块,分别是控制单元,运算单元和存储单元. ...
- TP thinkphp 权限管理 权限认证 功能
(如有打扰,请忽略)阿里云ECS大羊群,2U4G低至1.4折,限实名新用户,需要的点吧https://promotion.aliyun.com/ntms/act/vm/aliyun-group/tea ...
- BootStrap------之模态框1
<!DOCTYPE html> <html lang="zh-cn"> <head> <meta charset="utf-8& ...