
02_zookeeper集群安装
zookeeper集群安装
(1) 下载zookeeper安装包,并上传到要组成zookeeper集群的多个机器上
我放置的目录:/usr/local/src/zookeeper-3.4.5.tar.gz, 使用3个节点构成zookeeper集群
(2) 将各个节点上的压缩包进行解压, 得到zookeeper目录
# tar –xzvf zookeeper-3.4..tart.gz
(3) 修改zookeeper目录的owener为当前用户及群组
# chown –R root:root zookeeper-3.4.
(4) 选任意一台机器,进入zookeeper配置目录,将zoo_sample.cfg复制并重命名为zoo.cfg
 #  cd /usr/local/src/zookeeper-3.4./conf

 #  cp zoo_sample.cfg   zoo.cfg
(5) 修改zoo.cfg配置文件
# vim zoo.cfg
修改dataDir路径,同时增加3行集群节点描述,每行对应1个即将作为zookeeper集群节点的机器
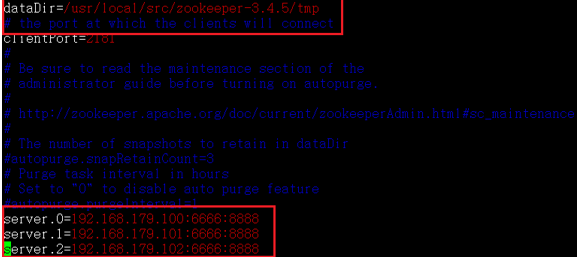
配置文件中的相关参数说明:
tickTime: 毫秒单位,zookeeper时间单位,也是zkserver-client间发送心跳的间隔时间
initLimit: zk集群中follower角色的机器和leader角色的机器,初始连接时能够容忍的最大 无心跳时间(多少个tick)
syncLimit: zk集群中follower角色的机器和leader角色的机器,同步阶段能够容忍的最大无 心跳时间(多少个tick)
dataDir: zk保存数据的本地目录
clientPort: zk公布给外接的,用于client端连接zk集群的端口号(TCP长连接)
server.0=ip:通信端口:选举端口
0,1,2 是zk服务器的内部编号
通信端口,zk集群中的follower和leader间的通信端口
选举端口,zk集群中进行选举时使用的通信端口
(6) 在各个主机上都创建zookeeper的数据目录
# mkdir /usr/local/src/zookeeper-3.4./tmp
(7) 将zoo.cfg文件分发到各个机器
 # scp –rp zoo.cfg  root@slave1:/usr/local/src/zookeeper-3.4./conf

 # scp –rp zoo.cfg  root@slave2:/usr/local/src/zookeeper-3.4./conf
(8) 所有节点都进入到conf中设置的zk的数据目录,并创建新myid文件
节点1
 # cd /usr/local/src/zookeeper-3.4./tmp

 # touch myid

 # vim myid

 写入0
节点2
 # cd /usr/local/src/zookeeper-3.4./tmp

 # touch myid

 # vim myid

 写入1
节点3
 # cd /usr/local/src/zookeeper-3.4./tmp

 # touch myid

 # vim myid

 写入2
0,1,2和zoo.cfg中的server.0, server.1, server.2保持一致
(9) 在所有节点上都启动bin目录下的zkServer.sh
 # cd /usr/local/src/zookeeper-3.4./bin

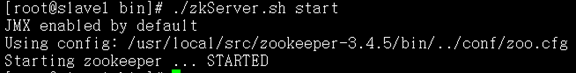
 # ./zkServer.sh start
所有节点的终端上都出现如下提示,则表示zk启动成功
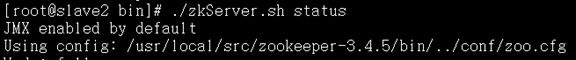
(10) 查看各个节点的zk状态
 # cd /usr/local/src/zookeeper-3.4./bin

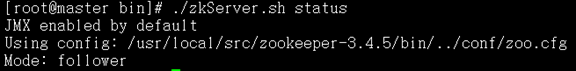
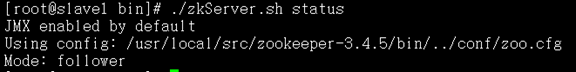
 # ./zkServer.sh  status
节点1
节点2
节点3:
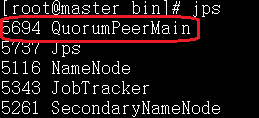
(11) 查看各个节点上的zookeeper进程
Zookeeper以java进程的方式运行,通过JPS可以确定正常运行,安装结束
02_zookeeper集群安装的更多相关文章
- 【Oracle 集群】Oracle 11G RAC教程之集群安装(七)
Oracle 11G RAC集群安装(七) 概述:写下本文档的初衷和动力,来源于上篇的<oracle基本操作手册>.oracle基本操作手册是作者研一假期对oracle基础知识学习的汇总. ...
- kafka集群安装部署
kafka集群安装 使用的版本 系统:centos6.5 centos6.7 jdk:1.7.0_79 zookeeper:3.4.9 kafka:2.10-0.10.1.0 一.环境准备[只列,不具 ...
- CentOS下Hadoop-2.2.0集群安装配置
对于一个刚开始学习Spark的人来说,当然首先需要把环境搭建好,再跑几个例子,目前比较流行的部署是Spark On Yarn,作为新手,我觉得有必要走一遍Hadoop的集群安装配置,而不仅仅停留在本地 ...
- Hadoop多节点集群安装配置
目录: 1.集群部署介绍 1.1 Hadoop简介 1.2 环境说明 1.3 环境配置 1.4 所需软件 2.SSH无密码验证配置 2.1 SSH基本原理和用法 2.2 配置Master无密码登录所有 ...
- codis集群安装
在网上找了很多codis的集群安装方法,看起来都是大同小异,本人结合了大多种方法完成了一套自己使用的codis的集群安装,可以供大家学习使用,如果有什么问题或者不懂的地方欢迎指正 1.集群规划: 三台 ...
- [bigdata] spark集群安装及测试
在spark安装之前,应该已经安装了hadoop原生版或者cdh,因为spark基本要基于hdfs来进行计算. 1. 下载 spark: http://mirrors.cnnic.cn/apache ...
- (原) 1.2 Zookeeper伪集群安装
本文为原创文章,转载请注明出处,谢谢 Zookeeper伪集群安装 zookeeper单机安装配置可以查看 1.1 zookeeper单机安装 1.复制三份zookeeper,分别为zookeeper ...
- 一步步教你Hadoop多节点集群安装配置
1.集群部署介绍 1.1 Hadoop简介 Hadoop是Apache软件基金会旗下的一个开源分布式计算平台.以Hadoop分布式文件系统HDFS(Hadoop Distributed Filesys ...
- kafka 集群安装与安装测试
一.集群安装 1. Kafka下载:wget https://archive.apache.org/dist/kafka/0.8.1/kafka_2.9.2-0.8.1.tgz 解压 tar zxvf ...
随机推荐
- Yii框架2.0的控制器
控制器是继承[[yii\base\Controller]]类的对象,负责处理请求和生成响应. 具体来说,控制器从应用主体接管控制后会分析请求数据并传送到模型, 传送模型结果到视图,最后生成输出响应信息 ...
- C++的全部目标就是最优化资源的利用,以人付出更多为代价。Python刚好是另一个极端(Bjarne就说,一个人至少应该掌握两种计算机语言)
说 C++ 反人类,是如果把 C++ 看作人(程序员)和资源(电子系统)的桥梁,他的全部目标就是最优化资源的利用,以人付出更多为代价.Python刚好是另一个极端.做好两个一起学.Bjarne就说,一 ...
- LRU算法的Python实现
http://flychao88.iteye.com/blog/1977653文章中介绍了常见的几种缓存淘汰策略 LRU:least recently used,最近最少使用算法.其实就是按使用时间倒 ...
- 【Unity Shader编程】之十六 基于MatCap实现适于移动平台的“次时代”车漆Shader
本系列文章由@浅墨_毛星云 出品,转载请注明出处. 文章链接:http://blog.csdn.net/poem_qianmo/article/details/55803629 渲染本文配图使用的 ...
- 19.Eclipse 修改默认的keystore签名文件
Android开发中apk运行都需要签名,就算连接手机直接运行调试,apk都有签名,开发工具会有默认的debug_keyStore Eclipse ADT调试运行使用的是临时生成的Debug专用证书, ...
- 安装pip环境以及pip常用命令使用
1.去到Python的官网下载pip包,下载地址是:https://pypi.python.org/pypi/pip#downloads 2.下载完成之后,解压到一个文件夹,用CMD控制台进入解压目录 ...
- shared_ptr的线程安全
1.9 再论shared_ptr 的线程安全 虽然我们借shared_ptr 来实现线程安全的对象释放,但是shared_ptr 本身不是100% 线程安全的.它的引用计数本身是安全且无锁的,但对象的 ...
- Windows 和 Linux 的文件名
Windows中文件名是区分大小写的,而Linux不区分. 在开发中,发现在Windows可以执行通过,在Linux可能由于文件名不一致而失败.
- Linux系统——inode和block
Linux文件属性 磁盘被分区并格式化为ext4文件系统后,会生成一定数量的inode和block Inode 索引节点 作用:存放文件的属性信息以及作为文件的索引(指向文件的实体block) Blo ...
- $digest / $apply digest in progress报错
有的时候出于某种原因,如jq操作了model.或者$watch.setTimeout等函数改变了model,导致最后没有脏数据检测.所以我没就手动调用了$apply( )等.但是第一次运行的时候ang ...