
HBase 系列(四)—— HBase 集群环境配置
一、集群规划
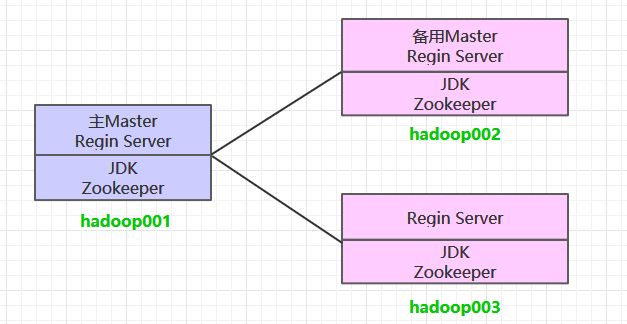
这里搭建一个 3 节点的 HBase 集群,其中三台主机上均为 Regin Server。同时为了保证高可用,除了在 hadoop001 上部署主 Master 服务外,还在 hadoop002 上部署备用的 Master 服务。Master 服务由 Zookeeper 集群进行协调管理,如果主 Master 不可用,则备用 Master 会成为新的主 Master。
二、前置条件
HBase 的运行需要依赖 Hadoop 和 JDK(HBase 2.0+ 对应 JDK 1.8+) 。同时为了保证高可用,这里我们不采用 HBase 内置的 Zookeeper 服务,而采用外置的 Zookeeper 集群。相关搭建步骤可以参阅:
三、集群搭建
3.1 下载并解压
下载并解压,这里我下载的是 CDH 版本 HBase,下载地址为:http://archive.cloudera.com/cdh5/cdh/5/
# tar -zxvf hbase-1.2.0-cdh5.15.2.tar.gz3.2 配置环境变量
# vim /etc/profile添加环境变量:
export HBASE_HOME=usr/app/hbase-1.2.0-cdh5.15.2
export PATH=$HBASE_HOME/bin:$PATH
使得配置的环境变量立即生效:
# source /etc/profile3.3 集群配置
进入 ${HBASE_HOME}/conf 目录下,修改配置:
1. hbase-env.sh
# 配置JDK安装位置
export JAVA_HOME=/usr/java/jdk1.8.0_201
# 不使用内置的zookeeper服务
export HBASE_MANAGES_ZK=false
2. hbase-site.xml
<configuration>
    <property>
        <!-- 指定 hbase 以分布式集群的方式运行 -->
        <name>hbase.cluster.distributed</name>
        <value>true</value>
    </property>
    <property>
        <!-- 指定 hbase 在 HDFS 上的存储位置 -->
        <name>hbase.rootdir</name>
        <value>hdfs://hadoop001:8020/hbase</value>
    </property>
    <property>
        <!-- 指定 zookeeper 的地址-->
        <name>hbase.zookeeper.quorum</name>
        <value>hadoop001:2181,hadoop002:2181,hadoop003:2181</value>
    </property>
</configuration>
3. regionservers
hadoop001
hadoop002
hadoop003
4. backup-masters
hadoop002backup-masters 这个文件是不存在的,需要新建,主要用来指明备用的 master 节点,可以是多个,这里我们以 1 个为例。
3.4 HDFS客户端配置
这里有一个可选的配置:如果您在 Hadoop 集群上进行了 HDFS 客户端配置的更改,比如将副本系数 dfs.replication 设置成 5,则必须使用以下方法之一来使 HBase 知道,否则 HBase 将依旧使用默认的副本系数 3 来创建文件:
- Add a pointer to your
HADOOP_CONF_DIRto theHBASE_CLASSPATHenvironment variable in hbase-env.sh.- Add a copy of hdfs-site.xml (or hadoop-site.xml) or, better, symlinks, under ${HBASE_HOME}/conf, or
- if only a small set of HDFS client configurations, add them to hbase-site.xml.
以上是官方文档的说明,这里解释一下:
第一种 :将 Hadoop 配置文件的位置信息添加到 hbase-env.sh 的 HBASE_CLASSPATH 属性,示例如下:
export HBASE_CLASSPATH=usr/app/hadoop-2.6.0-cdh5.15.2/etc/hadoop第二种 :将 Hadoop 的 hdfs-site.xml 或 hadoop-site.xml 拷贝到 ${HBASE_HOME}/conf 目录下,或者通过符号链接的方式。如果采用这种方式的话,建议将两者都拷贝或建立符号链接,示例如下:
# 拷贝
cp core-site.xml hdfs-site.xml /usr/app/hbase-1.2.0-cdh5.15.2/conf/
# 使用符号链接
ln -s   /usr/app/hadoop-2.6.0-cdh5.15.2/etc/hadoop/core-site.xml
ln -s   /usr/app/hadoop-2.6.0-cdh5.15.2/etc/hadoop/hdfs-site.xml
注:
hadoop-site.xml这个配置文件现在叫做core-site.xml
第三种 :如果你只有少量更改,那么直接配置到 hbase-site.xml 中即可。
3.5 安装包分发
将 HBase 的安装包分发到其他服务器,分发后建议在这两台服务器上也配置一下 HBase 的环境变量。
scp -r /usr/app/hbase-1.2.0-cdh5.15.2/  hadoop002:usr/app/
scp -r /usr/app/hbase-1.2.0-cdh5.15.2/  hadoop003:usr/app/
四、启动集群
4.1 启动ZooKeeper集群
分别到三台服务器上启动 ZooKeeper 服务:
zkServer.sh start4.2 启动Hadoop集群
# 启动dfs服务
start-dfs.sh
# 启动yarn服务
start-yarn.sh
4.3 启动HBase集群
进入 hadoop001 的 ${HBASE_HOME}/bin,使用以下命令启动 HBase 集群。执行此命令后,会在 hadoop001 上启动 Master 服务,在 hadoop002 上启动备用 Master 服务,在 regionservers 文件中配置的所有节点启动 region server 服务。
start-hbase.sh4.5 查看服务
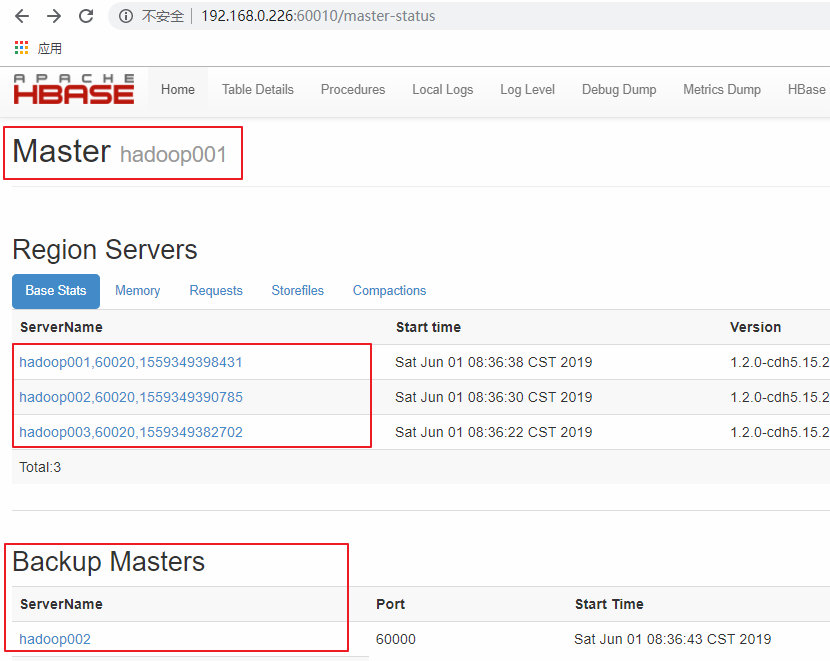
访问 HBase 的 Web-UI 界面,这里我安装的 HBase 版本为 1.2,访问端口为 60010,如果你安装的是 2.0 以上的版本,则访问端口号为 16010。可以看到 Master 在 hadoop001 上,三个 Regin Servers 分别在 hadoop001,hadoop002,和 hadoop003 上,并且还有一个 Backup Matser 服务在 hadoop002 上。
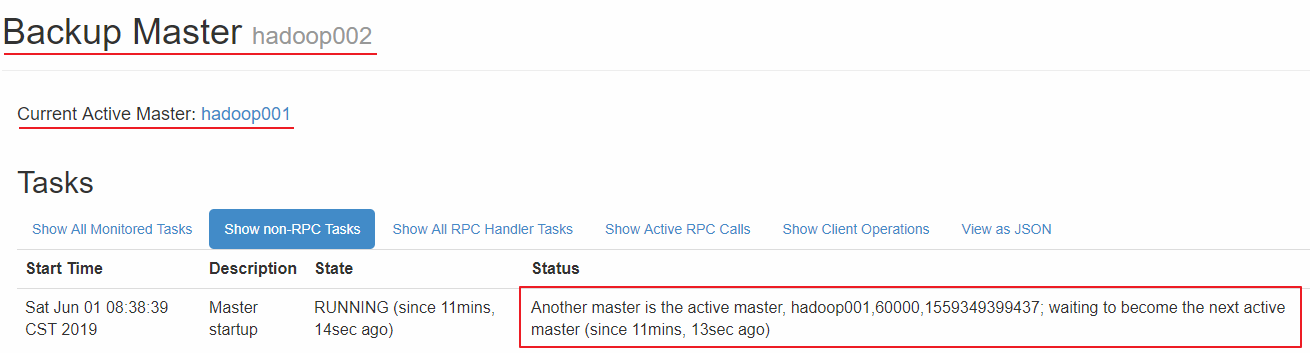
hadoop002 上的 HBase 出于备用状态:
更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
HBase 系列(四)—— HBase 集群环境配置的更多相关文章
- Hive在集群环境配置
本文转载自:https://blog.csdn.net/hanjin7278/article/details/53035739 一.简介 hive是基于Hadoop的一个数据仓库工具,可以将结构化的数 ...
- EHCache分布式缓存集群环境配置
EHCache分布式缓存集群环境配置 ehcache提供三种网络连接策略来实现集群,rmi,jgroup还有jms.同时ehcache可以可以实现多播的方式实现集群,也可以手动指定集群主机序列实现集群 ...
- Kafka集群环境配置
Kafka集群环境配置 1 环境准备 1.1 集群规划 Node02 Node03 Node04 zk zk zk kafka kafka kafka 1.2 jar包下载 安装包:kafka_2.1 ...
- HBase 学习之路(四)—— HBase集群环境配置
一.集群规划 这里搭建一个3节点的HBase集群,其中三台主机上均为Regin Server.同时为了保证高可用,除了在hadoop001上部署主Master服务外,还在hadoop002上部署备用的 ...
- SpringBoot系列教程之Redis集群环境配置
之前介绍的几篇redis的博文都是基于单机的redis基础上进行演示说明的,然而在实际的生产环境中,使用redis集群的可能性应该是大于单机版的redis的,那么集群的redis如何操作呢?它的配置和 ...
- RocketMQ的安装配置:配置jdk环境,配置RocketMQ环境,配置集群环境,配置rocketmq-console
RocketMQ的安装配置 演示虚拟机环境:Centos64-1 (D:\linuxMore\centos6_64) root / itcast : 固定IP 192.168.52.128 一,配置J ...
- 第2章 CentOS7集群环境配置
目录 2.1 关闭防火墙 2.2 设置固定IP 2.3 修改主机名 2.4 添加用户 2.5 修改用户权限 2.6 新建目录 2.7 安装JDK 1.卸载系统自带的JDK 2.安装JDK 2.8 克隆 ...
- redis集群环境配置
为什么需要集群 redis是一个开源的 key->value 高速存储系统,但是由于redis单线程运行,在系统中,只能利用单核的性能 当redis的调用越来越频繁时,可能会出现redis过于繁 ...
- 【集群搭建】Zookeeper集群环境配置
1.下载解压安装文件 2.配置文件:conf/zoo.cfg tickTime=2000 dataDir=/usr/sunny/logs/zookeeper/data dataLogDir=/usr/ ...
随机推荐
- [leetcode] #213 House Robber II Medium (medium)
原题链接 比子母题House Robber多了一个条件:偷了0以后,第n-1间房子不能偷. 转换思路为求偷盗[0,n-1)之间,以及[1,n)之间的最大值. 用两个DP,分别保存偷不偷第0间房的情况. ...
- vue教程(二)--过滤器和监视改动功能
过滤器filter: 1.将数据进行添油加醋的操作. 2.过滤器分两种: 组件内的过滤器(组件内有效). 全局过滤器 组件内:filters:{过滤器名:过滤器函数fn},fn内通过return 返回 ...
- module中module.exports与exports的区别(转)
转https://cnodejs.org/topic/55ccace5b25bd72150842c0a require 用来加载代码,而 exports 和 module.exports 则用来导出代 ...
- Java 内存模型详解
概述 Java的内存模型(Java Memory Model )简称JMM.首先应该明白,Java内存模型是一个规范,主要规定了以下两点: 规定了一个线程如何以及何时可以看到其他线程修改过后的共享变量 ...
- Lombok 使用介绍(常见注解)
目录 @Data @NonNull @Getter & @Setter @ToString @EqualsAndHashCode @NoArgsConstructor, @RequiredAr ...
- Linux学习笔记04
文件查找命令find 文件查找命令: which locate find which:查找命令字所在的位置 locate:模糊匹配(只要包含关键字的文件都查找出来) 不是实时的,基于数据库查找, up ...
- O2优化的实质
重点:如果使用多个-O选项(包含或不包含级别编号),则最后一个选项是有效的选项.------------ ------------ ------------例如:#pragma GCC optimiz ...
- centos6.5-7编译安装Ansible详细部署
一.基础介绍==========================================================================================ansi ...
- 用mongodb 固定集合实现只保留固定数量的记录,自动淘汰老旧数据
在一个保存report记录的场景中,我们使用MongoDB进行数据存储 example: db: report Collection: daily_report 创建db: use report; ...
- extjs4 表单验证自定义
extjs4 在验证上面支持的也特别好,他可以使用自带的格式验证,也可以自定义验证 比如:正则验证,密码重复填写对比验证,以及 调用后台方法验证,下面将验证方法统一写出以供参考 function lo ...