
深度学习tensorflow实战笔记(2)图像转换成tfrecords和读取
1、准备数据
首选将自己的图像数据分类分别放在不同的文件夹下,比如新建data文件夹,data文件夹下分别存放up和low文件夹,up和low文件夹下存放对应的图像数据。也可以把up和low文件夹换成0和1。根据自己数据类别,自己设定。如图所示
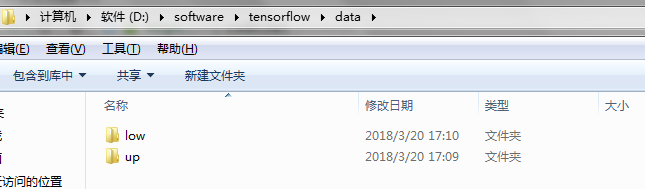
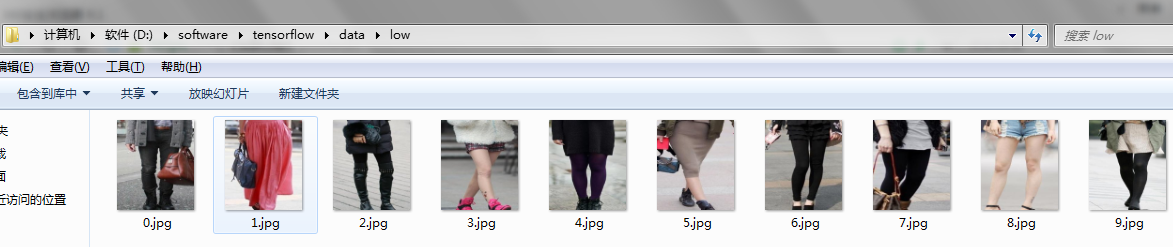
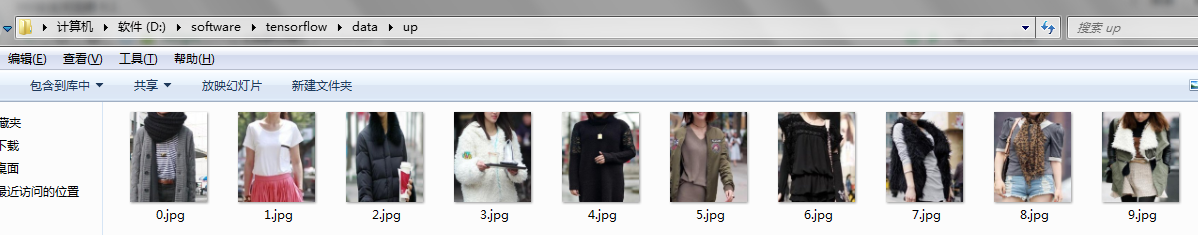
以上三张图片注意看目录。这样数据就准备好了。
2、将图像数据转换成tfrecords
 import os

 import tensorflow as tf

 from PIL import Image

 import matplotlib.pyplot as plt

 import numpy as np

 sess=tf.InteractiveSession()

 cwd = "D://software//tensorflow//data//"  #数据所在目录位置

 classes = {'up', 'low'} #预先自己定义的类别,根据自己的需要修改

 writer = tf.python_io.TFRecordWriter("train.tfrecords")  #train表示转成的tfrecords数据格式的名字

 for index, name in enumerate(classes):

     class_path = cwd + name + "/"

     for img_name in os.listdir(class_path):

         img_path = class_path + img_name

         img = Image.open(img_path)

         img = img.resize((300, 300))  #图像reshape大小设置,根据自己的需要修改

         img_raw = img.tobytes()

         example = tf.train.Example(features=tf.train.Features(feature={

             "label": tf.train.Feature(int64_list=tf.train.Int64List(value=[index])),

             'img_raw': tf.train.Feature(bytes_list=tf.train.BytesList(value=[img_raw]))

         }))

         writer.write(example.SerializeToString())

 writer.close()
3、从tfrecords中读取数据
直接上代码:
 #读取文件

 def read_and_decode(filename,batch_size):

     #根据文件名生成一个队列

     filename_queue = tf.train.string_input_producer([filename])

     reader = tf.TFRecordReader()

     _, serialized_example = reader.read(filename_queue)   #返回文件名和文件

     features = tf.parse_single_example(serialized_example,

                                        features={

                                            'label': tf.FixedLenFeature([], tf.int64),

                                            'img_raw' : tf.FixedLenFeature([], tf.string),

                                        })

     img = tf.decode_raw(features['img_raw'], tf.uint8)

     img = tf.reshape(img, [300, 300, 3])                #图像归一化大小

    # img = tf.cast(img, tf.float32) * (1. / 255) - 0.5   #图像减去均值处理,根据自己的需要决定要不要加上

     label = tf.cast(features['label'], tf.int32)

     #特殊处理,去数据的batch,如果不要对数据做batch处理,也可以把下面这部分不放在函数里

     img_batch, label_batch = tf.train.shuffle_batch([img, label],

                                                     batch_size= batch_size,

                                                     num_threads=64,

                                                     capacity=200,

                                                     min_after_dequeue=150)

     return img_batch, tf.reshape(label_batch,[batch_size])
需要注意的地方:
img = tf.cast(img, tf.float32) * (1. / 255) - 0.5 #图像减去均值处理,根据自己的需要决定要不要加上
 #特殊处理,去数据的batch,如果不要对数据做batch处理,也可以把下面这部分不放在函数里

     img_batch, label_batch = tf.train.shuffle_batch([img, label],

                                                     batch_size= batch_size,

                                                     num_threads=64,

                                                     capacity=200,

                                                     min_after_dequeue=150)
如果不需要把数据做batch处理,则函数的第二个形参batch_size就去掉,函数直接返回img和label。也可以把batch处理部分放在函数外面,根据自己的需要自己修改一下。
4、转换和读取函数的调用
 tfrecords_file = 'train.tfrecords'   #要读取的tfrecords文件

 BATCH_SIZE = 4      #batch_size的大小

 image_batch, label_batch = read_and_decode(tfrecords_file,BATCH_SIZE)

 print(image_batch,label_batch)    #注意,这里不是tensor,tensor需要做see.run()处理
下面就定义session,执行即可,有一个地方需要注意,
image_batch, label_batch = read_and_decode(tfrecords_file,BATCH_SIZE) #需要注意
虽然能够把数据读取出来,但是不是tensor,在训练的时候需要image,label=sess.run([image_batch,label_batch])处理后,才能投入训练。具体细节下一篇博客再做详细介绍。
如果还有问题未能得到解决,搜索887934385交流群,进入后下载资料工具安装包等。最后,感谢观看!
深度学习tensorflow实战笔记(2)图像转换成tfrecords和读取的更多相关文章
- 深度学习tensorflow实战笔记(1)全连接神经网络(FCN)训练自己的数据(从txt文件中读取)
1.准备数据 把数据放进txt文件中(数据量大的话,就写一段程序自己把数据自动的写入txt文件中,任何语言都能实现),数据之间用逗号隔开,最后一列标注数据的标签(用于分类),比如0,1.每一行表示一个 ...
- 深度学习tensorflow实战笔记 用预训练好的VGG-16模型提取图像特征
1.首先就要下载模型结构 首先要做的就是下载训练好的模型结构和预训练好的模型,结构地址是:点击打开链接 模型结构如下: 文件test_vgg16.py可以用于提取特征.其中vgg16.npy是需要单独 ...
- 深度学习-tensorflow学习笔记(1)-MNIST手写字体识别预备知识
深度学习-tensorflow学习笔记(1)-MNIST手写字体识别预备知识 在tf第一个例子的时候需要很多预备知识. tf基本知识 香农熵 交叉熵代价函数cross-entropy 卷积神经网络 s ...
- 深度学习-tensorflow学习笔记(2)-MNIST手写字体识别
深度学习-tensorflow学习笔记(2)-MNIST手写字体识别超级详细版 这是tf入门的第一个例子.minst应该是内置的数据集. 前置知识在学习笔记(1)里面讲过了 这里直接上代码 # -*- ...
- 深度学习入门实战(二)-用TensorFlow训练线性回归
欢迎大家关注腾讯云技术社区-博客园官方主页,我们将持续在博客园为大家推荐技术精品文章哦~ 作者 :董超 上一篇文章我们介绍了 MxNet 的安装,但 MxNet 有个缺点,那就是文档不太全,用起来可能 ...
- 深度学习Tensorflow相关书籍推荐和PDF下载
深度学习Tensorflow相关书籍推荐和PDF下载 baihualinxin关注 32018.03.28 10:46:16字数 481阅读 22,673 1.机器学习入门经典<统计学习方法&g ...
- 深度学习Keras框架笔记之AutoEncoder类
深度学习Keras框架笔记之AutoEncoder类使用笔记 keras.layers.core.AutoEncoder(encoder, decoder,output_reconstruction= ...
- 深度学习Keras框架笔记之TimeDistributedDense类
深度学习Keras框架笔记之TimeDistributedDense类使用方法笔记 例: keras.layers.core.TimeDistributedDense(output_dim,init= ...
- 深度学习Keras框架笔记之Dense类(标准的一维全连接层)
深度学习Keras框架笔记之Dense类(标准的一维全连接层) 例: keras.layers.core.Dense(output_dim,init='glorot_uniform', activat ...
随机推荐
- Zookeeper工作过程详解
一.Zookeeper工作机制 分布式和集中式系统相比,有很多优势,比如更强的计算能力,存储能力,避免单点故障等问题.但是由于在分布式部署的方式遇到网络故障等问题的时候怎么保证各个节点数据的一致性和可 ...
- Thinkphp5.0第五篇
原样输出 使用literal标签防止模板标签被解析 例如 {literal} {$name}<br/> {/literal} 模板单行注释 {//注释内容} 多行注释 {/*注释内容*/} ...
- Java 学习笔记之 Sleep停止线程
Sleep停止线程: 在Sleep状态下被interrupt,interrupted 状态会被擦除,返回false. 线程在Sleep状态下被interrupt: public class Sleep ...
- ShutdownHook- Java 优雅停机解决方案
想象一下,如果你现在刚好在 word 上写需求文档,电脑突然重启.等待开机完成,你可能会发现写了一个小时文档没有保存,就这么没了... 一个正在运行 Java 应用如果突然将其停止,影响不止数据丢失, ...
- HashMap 取数算法
Map,百度翻译给我的解释是映射,在Java编程中,它是存储键值对(key-value)的一种容器,也是Java程序员常用的对象.这篇博客介绍下HashMap的实现:java是面向对象编程语言,jdk ...
- Angry Words 愤怒的话
_ Words said in anger are like scars left by nails in a fence. Even though you can pull all the nail ...
- lua多线程解决方案
直观的讲:lua并不支持多线程,lua语言本身具有携程功能,但携程仅仅是一种中继器. lua多线程的目的:有并发需求时,共享一些数据. 例如使用lua写一个并发服务器.用户登陆之后,用户数据储存在lu ...
- Vue-CLI 项目在pycharm中配置
Vue-CLI Vue-CLI 项目在pycharm中配置 第一步 pycharm索引到vue项目的根目录,打开 第二步 安装vue.js插件来高亮 .vue 文件代码(见插图) 第三步 第四步 配置 ...
- python selenium之CSS定位
ccs的优点:css相对xpath语法比xpath简洁,定位速度比xpath快 css的缺点:css不支持用逻辑运算符来定位,而xpath支持.css定位语法形式多样,相对xpath比较难记. css ...
- 引入jar包到本地仓库方法
1. 将jar放到本地某个位置,然后cmd到目标位置:2. 执行mvn install:install-file -DgroupId=com.alipay -DartifactId=alipay-tr ...