
embedding技术
word2vec
Word2Vec是一个可以将语言中的字词转换为低维、稠密、连续的向量表达(Vector Respresentations)的模型,其主要依赖的假设是Distributional Hypothesis(1954年由Harris提出分布假说,即上下文相似的词,其语义也相似;我的理解就是词的语义可以根据其上下文计算得出)
Word2vec主要分为CBOW(Continuous Bag of Words)和Skip Gram两种模式,其中CBOW是从原始数据推测目标字词;而Skip-Gram是从目标字词推测原始语句,其中CBOW对小型数据比较合适,而Skip-Gram在大型预料中表现得更好。
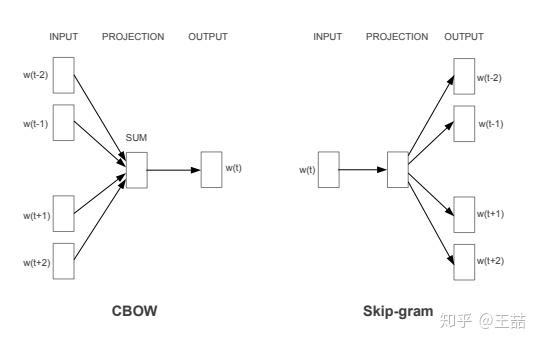
负采样
负采样的基本思想是用采样一些负例的方式近似代替遍历整个词汇。
目标函数
$ J^h( \theta ) = log \sigma( \Delta S_{\theta}(w,h)) + k log(1 - \sigma(\Delta S_{\theta}(w,h))) $
\(其中h=w_1,...,w_n为上下文词序列\)
\(P_n(w)代表负样本分布为,w是抽样词\)
\(P_d(w)代表正样本(真实数据)分布\)
$ \sigma(x)=\frac{1}{1+e^{-x}}是sigmoid函数 $
$ \theta 代表模型参数$
\(k 代表负样本与正样本的比例\)
\(P^h( D=1|w,\theta ) = \frac{P^h_{\theta}(w)}{P^h_{\theta}(w)+kP_n(w)}=\sigma(\Delta S_{\theta}(w,h)) 代表在给定上下文h,参数\theta情况下w是正样本的概率\)
\(其中S_{\theta}(w,h)=\hat{q}(h)^T q_w + b_w = (\sum^n_{i=1}c_i \bigodot r_{w_i})^T q_w + b_w\)
\(\hat{q}(h) = \sum^n_{i=1}c_i \bigodot r_{w_i}是上下文词向量的线性加权,代表对目标词的估计值\)
\(c_i代表上下文词在位置i的权重向量\)
\(r_{w_i}代表上下文词i的词向量表示\)
\(q_w代表目标词的词向量表示\)
\(b_w代表上下文无关的偏置项\)
反向梯度
$ \frac{\partial }{\partial \theta} J^{h,w}(\theta) = (1-\sigma(\Delta S_{\theta}(w,h))) \frac{\partial }{\partial \theta}logP^h_\theta(w) - \sum^k_{i=1}[\sigma(\Delta S_{\theta}(w,h))\frac{\partial }{\partial \theta}logP^h_\theta(x_i)]$
公式中使用k个噪音样本的词向量加和来代替词典全部词汇的加和,所以NCE的训练时间只线性相关于负样本个数,与词典大小无关。
层次softmax
Hierarchical Softmax中不更新每个词的输出词向量,更新的是二叉树(哈夫曼树)上节点对应的向量。代价由
embedding技术的更多相关文章
- 将句子表示为向量(上):无监督句子表示学习(sentence embedding)
1. 引言 word embedding技术如word2vec,glove等已经广泛应用于NLP,极大地推动了NLP的发展.既然词可以embedding,句子也应该可以(其实,万物皆可embeddin ...
- 推文《阿里凑单算法首次公开!基于Graph Embedding的打包购商品挖掘系统解析》笔记
推文<阿里凑单算法首次公开!基于Graph Embedding的打包购商品挖掘系统解析>笔记 从17年5月份开始接触Graph Embedding,学术论文读了很多,但是一直不清楚这技术是 ...
- GNN 相关资料记录;GCN 与 graph embedding 相关调研
最近做了一些和gnn相关的工作,经常听到GCN 和 embedding 相关技术,感觉很是困惑,所以写下此博客,对相关知识进行索引和记录: 参考链接: https://www.toutiao.com/ ...
- 深度解析Graph Embedding
Graph Embedding是推荐系统.计算广告领域最近非常流行的做法,是从word2vec等一路发展而来的Embedding技术的最新延伸:并且已经有很多大厂将Graph Embedding应用于 ...
- GNN 相关资料记录;GCN 与 graph embedding 相关调研;社区发现算法相关;异构信息网络相关;
最近做了一些和gnn相关的工作,经常听到GCN 和 embedding 相关技术,感觉很是困惑,所以写下此博客,对相关知识进行索引和记录: 参考链接: https://www.toutiao.com/ ...
- 【转载】Emdedding向量技术在蘑菇街推荐场景的应用
花名:越祈 部门:算法中心搜索策略组 入职时间:2017/06/01 主要从事蘑菇街推荐算法相关研发工作 蘑菇街是一家社会化导购电商平台,推荐一直是其非常重要的流量入口.在电商平台中,推荐的场景覆盖到 ...
- C_C++圣战(摘录)
我的回忆和有趣的故事 --- C/C++圣战篇 李维 (声明以下的这篇文章内容是我个人的回忆以及看法,没有任何特别的偏见,许多的事情是根据我的记忆以及从许多人的诉说中得知的,也许内容不是百分之百的正确 ...
- 深度召回模型在QQ看点推荐中的应用实践
本文由云+社区发表 作者:腾讯技术工程 导语:最近几年来,深度学习在推荐系统领域中取得了不少成果,相比传统的推荐方法,深度学习有着自己独到的优势.我们团队在QQ看点的图文推荐中也尝试了一些深度学习方法 ...
- 手把手教你用 Keras 实现 LSTM 预测英语单词发音
1. 动机 我近期在研究一个 NLP 项目,根据项目的要求,需要能够通过设计算法和模型处理单词的音节 (Syllables),并对那些没有在词典中出现的单词找到其在词典中对应的押韵词(注:这类单词类似 ...
随机推荐
- IDEA实用教程(一)
IDEA实用教程 一. IDEA简介 简介 IDEA 全称IntelliJ IDEA,是java语言开发的集成环境. IDEA是JetBrains公司的产品. JetBrains官网 : https: ...
- unity编辑器扩展_08(创建自定义窗口)
代码: using UnityEngine;using UnityEditor; public class MyWidow : EditorWindow{ [MenuItem("Win ...
- 红黑树以及与AVL树的区别
http://blog.csdn.net/zwan0518/article/details/12219055 http://blog.csdn.net/v_july_v/article/details ...
- GCN和GCN在文本分类中应用
1.GCN的概念 传统CNN卷积可以处理图片等欧式结构的数据,却很难处理社交网络.信息网络等非欧式结构的数据.一般图片是由c个通道h行w列的矩阵组成的,结构非常规整.而社交网络.信息网络 ...
- 基于Taro与Typescript开发的网易云音乐小程序
基于Taro与网易云音乐api开发,技术栈主要是:typescript+taro+taro-ui+redux,目前主要是着重小程序端的展示,主要也是借此项目强化下上述几个技术栈的使用,通过这个项目也可 ...
- CF #535 (Div. 3) E2 Array and Segments (Hard version) 利用线段树进行区间转移
传送门 题意: 有m个区间,n个a[ i ] , 选择若干个区间,使得整个数组中的最大值和最小值的差值最小.n<=1e5,m<=300; 思路: 可以知道每个i,如果一个区间包含这个 ...
- SDU暑期集训排位(2)
A. Art solved by sdcgvhgj 3min 签到 B. Biology solved by sdcgvhgj 85min 暴力 C - Computer Science solved ...
- lightoj 1145 - Dice (I)(dp+空间优化+前缀和)
题目链接:http://www.lightoj.com/volume_showproblem.php?problem=1145 题解:首先只要是dp的值只和上一个状态有关系那么就可以优化一维,然后这题 ...
- Mysql相关:navicat for mysql 加注释
在 navicat 中有三种注释的书写方式: 以 # 开头的字符串,可以多个 # 连续以 – 开头的字符串,注意:只能是 – ,而且 – 后面需要加一个半角空格以 /* */ 包围的字符串,类似于 J ...
- Error executing DDL via JDBC Statement 导致原因之一:列名使用了sql关键字
WARN: GenerationTarget encountered exception accepting command : Error executing DDL via JDBC Statem ...