
MapReduce面试题
什么是mapreduce
Mapreduce是一个分布式运算程序的编程框架,是用户开发“基于hadoop的数据分析应用”的核心框架。容错高,扩展好,适合pB数据处理
MapReduce 执行过程分析
第一阶段map

.map task读取HDFS文件。每个block,启动一个map task。每个map task按照行读取一个block中的内容,对每一行执行map函数

.map函数对输入的数据进行拆分split,得到一个数组,组成一个键值对<word, >

.分区,每个分区对应1个reduce task

.对每个分区中的数据,按照key进行分组并排序

.在map段执行小reduce,输出<key,times>

第二阶段reduce

.每个分区对应一个reduce task,这个reduce task会读取相同分区的map输出;reduce task对接收到的所有map输出,进行排序分组<hello,{,}><me,{}><you,{}>

.执行reduce 操作,对一个分组中的value进行累加<hello,><me,><you,>

.每个分区输出到一个HDFS文件中
Mapreduce数据倾斜原因和解决方案
原因:

    简单来说数据倾斜就是数据的key 的分化严重不均,造成一部分数据很多,一部分数据很少的局面。

    情形:group by 维度过小,某值的数量过多

    后果:处理某值的reduce非常耗时

    去重 distinct count(distinct xx)

    情形:某特殊值过多

    后果:处理此特殊值的reduce耗时

    连接 join

    情形1:其中一个表较小,但是key集中

    后果1:分发到某一个或几个Reduce上的数据远高于平均值

    情形2:大表与大表,但是分桶的判断字段0值或空值过多

    后果2:这些空值都由一个reduce处理,非常慢

解决:

    调优参数

  set hive.map.aggr=true:在map中会做部分聚集操作,效率更高但需要更多的内存。

  set hive.groupby.skewindata=true:数据倾斜时负载均衡,当选项设定为true,生成的查询计划会有两个MRJob。第一个MRJob 中,Map的输出结果集合会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的GroupBy Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MRJob再根据预处理的数据结果按照GroupBy Key分布到Reduce中(这个过程可以保证相同的GroupBy Key被分布到同一个Reduce中),最后完成最终的聚合操作。

、在 key 上面做文章,在 map 阶段将造成倾斜的key 先分成多组,例如 aaa 这个 key,map 时随机在 aaa 后面加上 ,,, 这四个数字之一,把 key 先分成四组,先进行一次运算,之后再恢复 key 进行最终运算。

、能先进行 group 操作的时候先进行 group 操作,把 key 先进行一次 reduce,之后再进行 count 或者 distinct count 操作。

、join 操作中,使用 map join 在 map 端就先进行 join ,免得到reduce 时卡住。
Java的序列化和hadoop序列化机制(Writable)
.紧凑

紧凑的格式能让我们充分利用网络带宽,而带宽是数据中心最稀缺的资源

.快速

进程通信形成了分布式系统的骨架,所以需要尽量减少序列化和反序列化的性能开销,这是基本的;

.可扩展

协议为了满足新的需求变化,所以控制客户端和服务器过程中,需要直接引进相应的协议,这些是新协议,原序列化方式能支持新的协议报文;

.互操作

能支持不同语言写的客户端和服务端进行交互;
Mapreduce的动态执行流程
MRAppMaster向RM申请2个container;

RM分配2个container,

NM启动该container,把container的地址返回给master。

container中开始运行map task或者reduce task。

在运行过程中,master与map task、reduce task保持心跳通讯,监测task的执行情况。

当map task和reduce task运行结束时,回收container。

当job运行结束时,master告诉RM,可以把自己回收了。

RM就让NM杀死master所在的container。

整个job运行完毕
切片机制
一个split的大小是由goalSize, minSize, blockSize这三个值决定的。
computeSplitSize的逻辑是,先从goalSize和blockSize两个值中选出最小的那个(比如一般不设置map数,这时blockSize为当前文件的块size,而goalSize是文件大小除以用户设置的map数得到的,如果没设置的话,默认是1)。
CombineTextInputFormat案例实操
// 如果不设置InputFormat,它默认用的是TextInputFormat.class

job.setInputFormatClass(CombineTextInputFormat.class);

CombineTextInputFormat.setMaxInputSplitSize(job, );// 4m

CombineTextInputFormat.setMinInputSplitSize(job, );// 2m
suffer机制
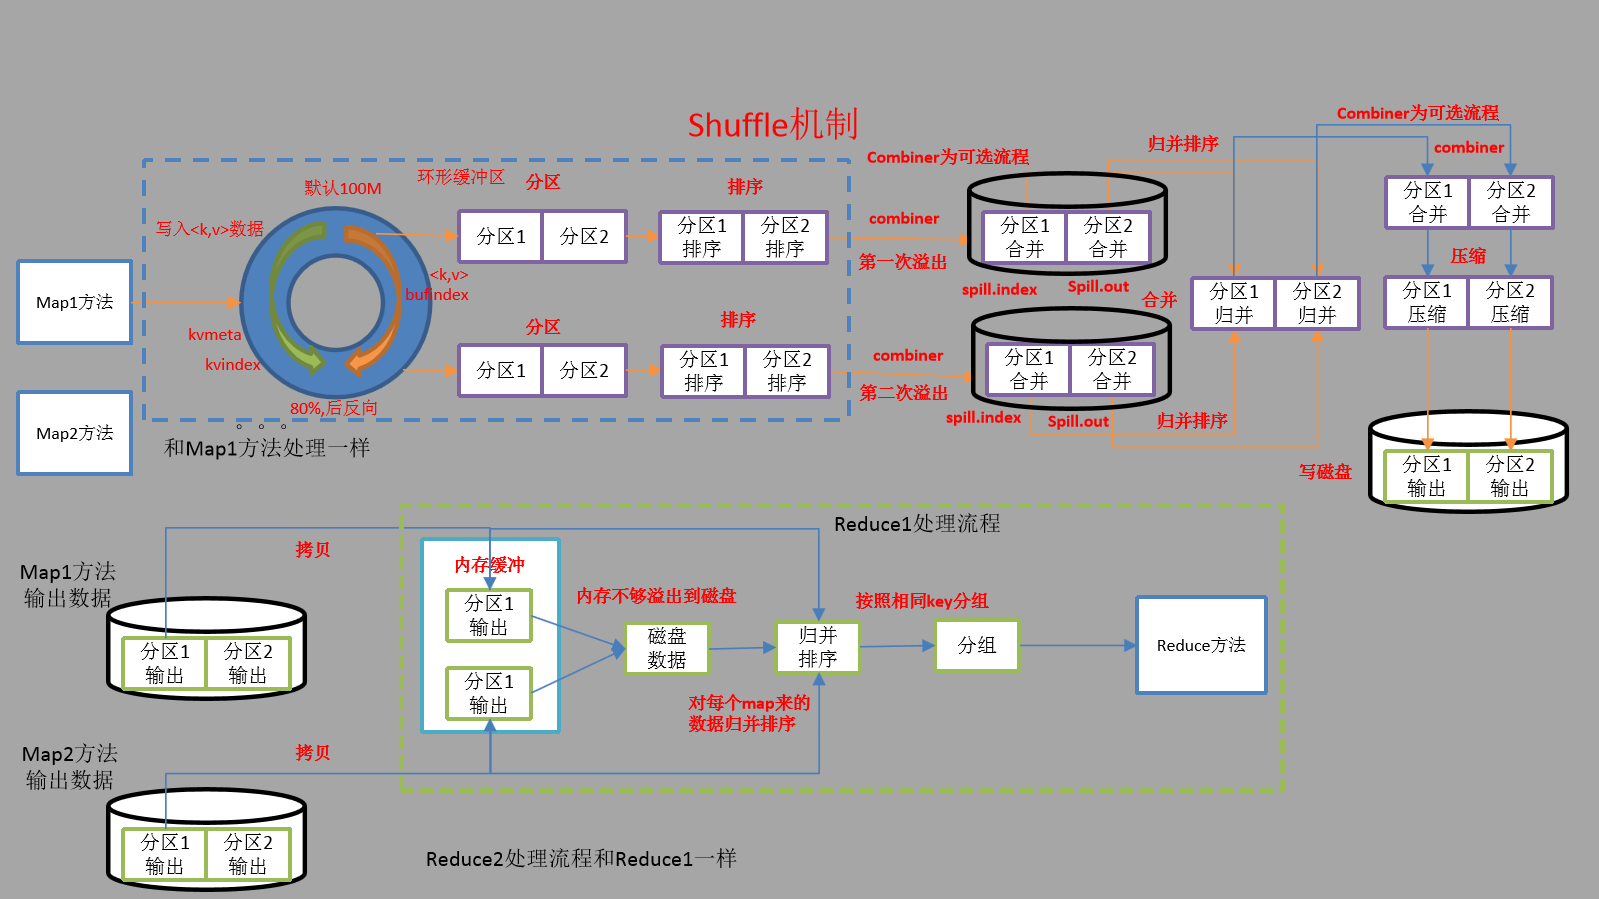
WritableComparable排序
bean对象实现WritableComparable接口重写compareTo方法,就可以实现排序

@Override

public int compareTo(FlowBean o) {

    // 倒序排列,从大到小

    return this.sumFlow > o.getSumFlow() ? - : ;

if(this.sumFlow==o.getSumFlow()){

This.downFlow>o.getDownFlow() ? - :

}

}
自定义Partitioner
()自定义类继承Partitioner,重写getPartition()方法

    public class ProvincePartitioner extends Partitioner<Text, FlowBean> {

    @Override

    public int getPartition(Text key, FlowBean value, int numPartitions) {

// 1 获取电话号码的前三位

        String preNum = key.toString().substring(, );

        int partition = ;

        // 2 判断是哪个省

        if ("".equals(preNum)) {

            partition = ;

        }else if ("".equals(preNum)) {

            partition = ;

        }else if ("".equals(preNum)) {

            partition = ;

        }else if ("".equals(preNum)) {

            partition = ;

        }

        return partition;

    }

}
()在job驱动中,设置自定义partitioner:

job.setPartitionerClass(CustomPartitioner.class);

()自定义partition后,要根据自定义partitioner的逻辑设置相应数量的reduce task

job.setNumReduceTasks();
MapReduce面试题的更多相关文章
- Hadoop工程师面试题(1)--MapReduce实现单表汇总统计
数据源格式描述: 输入t1.txt源数据,数据文件分隔符"*&*",字段说明如下: 字段序号 字段英文名称 字段中文名称 字段类型 字段长度 1 TIME_ID 时间(到时 ...
- Hadoop,MapReduce,HDFS面试题
今天发这个的目的是为了给自己扫开迷茫,告诉自己该进阶了,下面内容不一定官方和正确.全然个人理解,欢迎大家留言讨论 1.什么是hadoop 答:是google的核心算法MapReduce的一个开源实现. ...
- Hadoop面试题总结(三)——MapReduce
1.谈谈Hadoop序列化和反序列化及自定义bean对象实现序列化? 1)序列化和反序列化 (1)序列化就是把内存中的对象,转换成字节序列(或其他数据传输协议)以便于存储(持久化)和网络传输. (2) ...
- hadoop 学习笔记:mapreduce框架详解
开始聊mapreduce,mapreduce是hadoop的计算框架,我学hadoop是从hive开始入手,再到hdfs,当我学习hdfs时候,就感觉到hdfs和mapreduce关系的紧密.这个可能 ...
- Hadoop 之面试题
颜色区别: 蓝色:hive,橙色:Hbase.黑色hadoop 请简述hadoop怎样实现二级排序. 你认为用Java,Streaming,pipe 方式开发map/reduce,各有哪些优缺点: 6 ...
- Hadoop 面试题之Hbase
Hadoop 面试题之九 16.Hbase 的rowkey 怎么创建比较好?列族怎么创建比较好? 答: 19.Hbase 内部是什么机制? 答: 73.hbase 写数据的原理是什么? 答: 75.h ...
- Hadoop学习笔记:MapReduce框架详解
开始聊mapreduce,mapreduce是hadoop的计算框架,我学hadoop是从hive开始入手,再到hdfs,当我学习hdfs时候,就感觉到hdfs和mapreduce关系的紧密.这个可能 ...
- Java笔试题解答和部分面试题
面试类 银行类的问题 问题一:在多线程环境中使用HashMap会有什么问题?在什么情况下使用get()方法会产生无限循环? HashMap本身没有什么问题,有没有问题取决于你是如何使用它的.比如,你 ...
- 面试题_125_to_133_Java 面试中其他各式各样的问题
这部分包含 Java 中关于 XML 的面试题,JDBC 面试题,正则表达式面试题,Java 错误和异常及序列化面试题 125)嵌套静态类与顶级类有什么区别?(答案)一个公共的顶级类的源文件名称与类名 ...
随机推荐
- Tips on Java
1.JAVA种数组的两种定义方式. int[] nums; int nums[]. 2.整型默认为int,如果需要long,须加l或L.小数默认double,d或D可省略,但如果需要float,须加f ...
- 程序复杂程度(步长) N
我们知道计算机在运算时速度是固定的,程序运行的时间就与程序复杂程度有关.例如我们计算1-10相加 与 1-100相加,后者就要比前者多10倍时间. 例1 找出n个数中最大的一个 max= n[0] ...
- BZOJ 5507: [gzoi2019]旧词 LCT
和之前那个 [LNOI]LCA 几乎是同一道题,就是用动态树来维护查分就行. code: #include <bits/stdc++.h> using namespace std; #de ...
- C# await async Task
//原文:https://www.cnblogs.com/yan7/p/8401681.html //原文:https://www.cnblogs.com/s5689412/p/10073507.ht ...
- 解决IE报错:Locale 'chinese' is not well-formed,或RangeError: 区域设置“chinese”的格式不正确的问题
接之前的此博客问题处理:js处理时间时区问题 由于 toLocaleString():据本地时间格式,把 Date 对象转换为字符串.总是会带有上午/下午,所以我加了参数:new Date('2019 ...
- 【UVA11988】破损的键盘
题目链接 维护一个链表,以及当前位置.head.tail的指针,模拟就行了 #include<iostream> #include<cstring> #include<c ...
- centos7下配置ftp服务器
第一步,安装vsftpd这款ftp服务器软件,yum install -y vsftpd 第二步,设置vsftpd服务开机自启动,然后重启服务,查看ftp服务端口,centos6命令如下: #chkc ...
- 龙贝格积分(c++)
用龙贝格算法计算积分 #include <iostream> #include<cmath> #include <iomanip> using namespace ...
- tomcat启动报错java.lang.OutOfMemoryError:PermGen space解决办法
tomcat启动错误提示: 严重: Error waiting for multi-thread deployment of WAR files to completejava.util.concur ...
- RPC接口测试(一)什么是 RPC 框架
什么是 RPC 框架 RPC 框架----- 远程过程调用协议RPC(Remote Procedure Call Protocol)-----允许像调用本地服务一样调用远程服务. RPC是指远程过程调 ...