
scrapy+splash 爬取京东动态商品
作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3159
splash是容器安装的,从docker官网上下载windows下的docker进行安装。
下载完成之后直接点击安装,安装成功后,桌边会出现三个图标:
点击 Docker QuickStart 图标来启动 Docker Toolbox 终端。
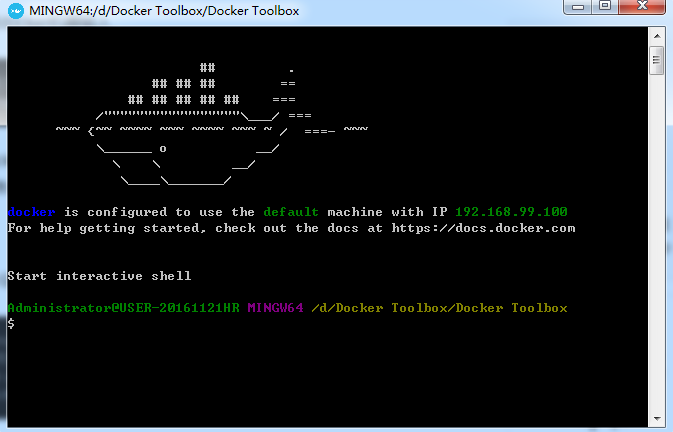
使用docker启动服务命令启动Splash服务
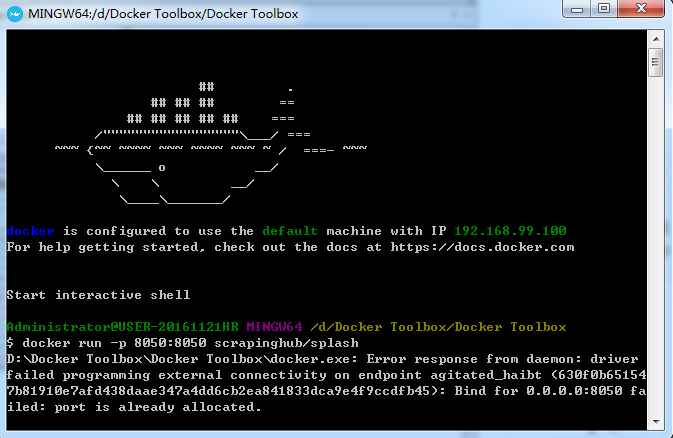
docker run -p 8050:8050 scrapinghub/splash
这里我已经开启服务了打开cmd,在当前目录下开始scrapy爬虫:
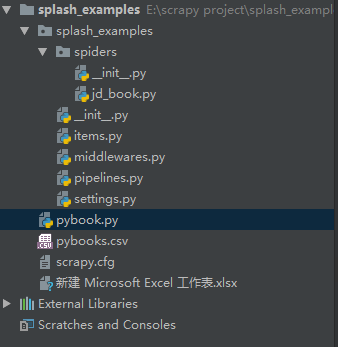
scrapy startproject scrapy_examples
在spider文件夹中新建python文件jd_book.py用于编写爬虫
在项目下新建pybook.py用于对数据文件csv处理
京东上的商品是动态加载的,爬取python书籍的前20页,获取每个商品的评论数、书名、简介。
SplashRequest(url,endpoint='execute',args={'lua_source':lua_script},cache_args=['lua_source'])请求页面并执行JS函数渲染页面
endpoint='execute':在页面中执行一些用户自定义的JavaScript代码
args={'lua_source':lua_script}:用户自定义的lua脚本
cache_args=['lua_source']:让Splash服务器缓存该函数
用户自定义的lua脚本中必须包含一个main函数作为程序入口,main函数被调用时会传入一个splash对象(lua中的对象),用户可以调用该对象上的方法操纵Splash。
splash.args属性:用户传入参数的表,通过该属性可以访问用户传入的参数
splash:go方法:类似于在浏览器中打开某url地址的页面,页面所需资源会被加载,并进行JavaScript渲染
splash:wait方法:等待页面渲染,time参数为等待的秒数
splash:runjs方法:在当前页面下,执行一段JavaScript代码
splash:html方法:splash:html()获取当前页面的HTML文本。
middlewares.py随机产生User-Agent添加到每个请求头中
pipelines.py处理爬取的数据并存入数据库
settings.py配置splash服务信息、设置请求延迟反爬虫、添加数据库信息
 # -*- coding:utf-8 -*-

 import scrapy

 from scrapy import Request

 from scrapy_splash import SplashRequest

 from splash_examples.items import PyBooksItem

 lua_script ='''

 function main(splash)

     splash:go(splash.args.url)

     splash:wait(2)

     splash:runjs("document.getElementsByClassName('pn-next')[0].scrollIntoView(true)")

     splash:wait(2)

     return splash.html()

 end

 '''

 class JDBookSpider(scrapy.Spider):

     name = "jd_book"

     allowed_domains = ['search.jd.com']

     base_url = 'https://search.jd.com/Search?keyword=python&enc=utf-8&wq=python'

     def start_requests(self):

         yield Request(self.base_url,callback=self.parse_urls,dont_filter=True)

     def parse_urls(self,response):

         for i in range(20):

             url = '%s&page=%s' % (self.base_url,2*i+1)

             yield SplashRequest(url,

                                 endpoint='execute',

                                 args={'lua_source':lua_script},

                                 cache_args=['lua_source'])

     def parse(self, response):

         for sel in response.css('ul.gl-warp.clearfix>li.gl-item'):

             pyjdbooks = PyBooksItem()

             pyjdbooks['name'] = sel.css('div.p-name').xpath('string(.//em)').extract_first()

             pyjdbooks['comment']=sel.css('div.p-commit').xpath('string(.//a)').extract_first()

             pyjdbooks['promo_words']=sel.css('div.p-name').xpath('string(.//i)').extract_first()

             yield pyjdbooks
jd_book.py
 import scrapy

 class PyBooksItem(scrapy.Item):

     name=scrapy.Field()

     comment=scrapy.Field()

     promo_words=scrapy.Field()
items.py
 from fake_useragent import UserAgent

 # 随机的User-Agent

 class RandomUserAgent(object):

     def process_request(self, request, spider):

         request.headers.setdefault("User-Agent", UserAgent().random)
middlewares.py
 class SplashExamplesPipeline(object):

     def __init__(self):

         self.book_set = set()

     def process_item(self, item, spider):

         if not(item['promo_words']):

             item['promo_words'] = item['name']

         comment = item['comment']

         if comment[-2:] == "万+":

             item['comment'] = str(int(float(comment[:-2])*10000))

         elif comment[-1] == '+':

             item['comment'] = comment[:-1]

         return item

 import pymysql

 class MysqlPipeline(object):

     def __init__(self, host, database, user, password, port):

         self.host = host

         self.database = database

         self.user = user

         self.password = password

         self.port = port

     @classmethod

     def from_crawler(cls, crawler):

         return cls(

             host=crawler.settings.get('MYSQL_HOST'),

             database=crawler.settings.get('MYSQL_DATABASE'),

             user=crawler.settings.get('MYSQL_USER'),

             password=crawler.settings.get('MYSQL_PASSWORD'),

             port=crawler.settings.get('MYSQL_PORT'),

         )

     def open_spider(self, spider):

         self.db = pymysql.connect(self.host, self.user, self.password, self.database, charset='utf8', port=self.port)

         self.cursor = self.db.cursor()

     def close_spider(self, spider):

         self.db.close()

     def process_item(self, item, spider):

         data = dict(item)

         keys = ', '.join(data.keys())

         values = ', '.join(['%s'] * len(data))

         sql = 'insert into books (%s) values (%s)' % (keys, values)

         self.cursor.execute(sql, tuple(data.values()))

         self.db.commit()

         return item
pipelines.py
 BOT_NAME = 'splash_examples'

 SPIDER_MODULES = ['splash_examples.spiders']

 NEWSPIDER_MODULE = 'splash_examples.spiders'

 #Splash服务器地址

 SPLASH_URL = 'http://192.168.99.100:8050'

 #开启Splash的两个下载中间件并调整HttpCompressionMiddleware的次序

 DOWNLOADER_MIDDLEWARES = {

     'splash_examples.middlewares.RandomUserAgent':345,

     'scrapy_splash.SplashCookiesMiddleware': 723,

     'scrapy_splash.SplashMiddleware': 725,

     'scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware': 810,

 }

 #设置去重过滤器

 DUPEFILTER_CLASS='scrapy_splash.SplashAwareDupeFilter'

 #用来支持cache_args

 SPIDER_MIDDLEWARES ={

     'scrapy_splash.SplashDeduplicateArgsMiddleware':100,

 }

 # 使用Splash的Http缓存

 HTTPCACHE_STORAGE = 'scrapy_splash.SplashAwareFSCacheStorage'

 # Obey robots.txt rules

 ROBOTSTXT_OBEY = False

 COOKIES_ENABLED = False

 DOWNLOAD_DELAY = 3

 ITEM_PIPELINES = {

     'splash_examples.pipelines.SplashExamplesPipeline':400,

     'splash_examples.pipelines.MysqlPipeline':543,

 }

 MYSQL_HOST = 'localhost'

 MYSQL_DATABASE = 'pybooks'

 MYSQL_PORT = 3306

 MYSQL_USER = 'root'

 MYSQL_PASSWORD = 'root'
settings.py
在Terminal中执行爬虫:scrapy crawl jd_book -o pybooks.csv
将数据存储到数据库并生成csv文件用于分析可视化

在数据库中查看有1187条信息
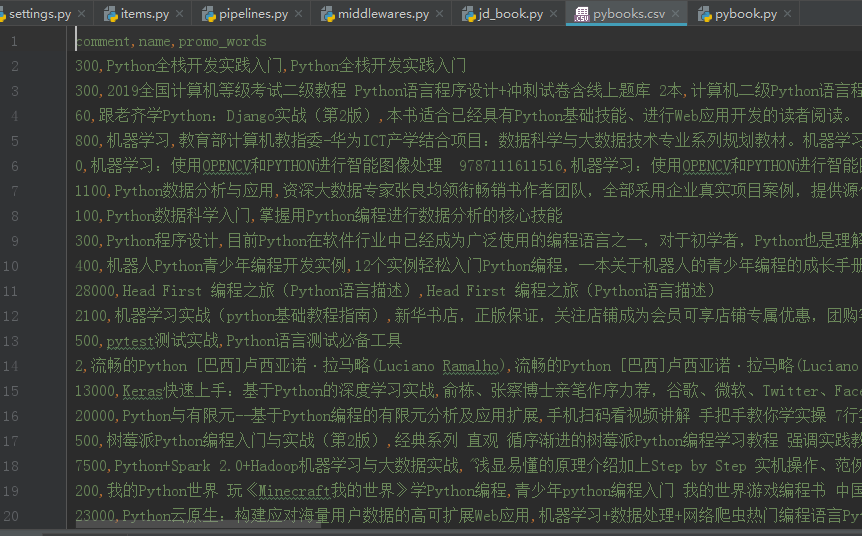

做数据分析可视化
 import pandas as pd

 import jieba

 from wordcloud import WordCloud

 import matplotlib.pyplot as plt

 obj = pd.read_csv('pybooks.csv')

 Books = obj.sort_values('comment',ascending=False)[:200]

 promoWords = []

 for promo in Books['promo_words']:

     promoWords.append(promo)

 promoWordsStr = ''.join(promoWords)

 bookTxt = jieba.lcut(promoWordsStr)

 stopwords = ['学习','入门','掌握','教程','图书','使用','全面','推荐','读者','专家']

 bookTxt = [token for token in bookTxt if token not in stopwords]

 bookTxtSet = set(bookTxt)

 txtCount = {}

 for i in bookTxtSet:

     if len(i) == 1:

         continue

     txtCount[i] = bookTxt.count(i)

 txtCount = sorted(txtCount.items(),key=lambda key:key[1],reverse=True)

 TxtStr = ' '.join(bookTxt)

 ciyun = WordCloud(background_color = '#122',width=400,height=300,margin = 1).generate(TxtStr)

 plt.imshow(ciyun)

 plt.axis("off")

 plt.show()

 print(txtCount)
pybook.py

scrapy+splash 爬取京东动态商品的更多相关文章
- Scrapy实战篇(八)之Scrapy对接selenium爬取京东商城商品数据
本篇目标:我们以爬取京东商城商品数据为例,展示Scrapy框架对接selenium爬取京东商城商品数据. 背景: 京东商城页面为js动态加载页面,直接使用request请求,无法得到我们想要的商品数据 ...
- JS+Selenium+excel追加写入,使用python成功爬取京东任何商品~
之前一直是requests库做爬虫,这次尝试下使用selenium做爬虫,效率不高,但是却没有限制,文章是分别结合大牛的selenium爬虫以及excel追加写入操作而成,还有待优化,打算爬取更多信息 ...
- python利用urllib实现的爬取京东网站商品图片的爬虫
本例程使用urlib实现的,基于python2.7版本,采用beautifulsoup进行网页分析,没有第三方库的应该安装上之后才能运行,我用的IDE是pycharm,闲话少说,直接上代码! # -* ...
- 毕设二:python 爬取京东的商品评论
# -*- coding: utf-8 -*- # @author: Tele # @Time : 2019/04/14 下午 3:48 # 多线程版 import time import reque ...
- Scrapy爬虫框架(实战篇)【Scrapy框架对接Splash抓取javaScript动态渲染页面】
(1).前言 动态页面:HTML文档中的部分是由客户端运行JS脚本生成的,即服务器生成部分HTML文档内容,其余的再由客户端生成 静态页面:整个HTML文档是在服务器端生成的,即服务器生成好了,再发送 ...
- 一起学爬虫——使用selenium和pyquery爬取京东商品列表
layout: article title: 一起学爬虫--使用selenium和pyquery爬取京东商品列表 mathjax: true --- 今天一起学起使用selenium和pyquery爬 ...
- Scrapy实战篇(七)之Scrapy配合Selenium爬取京东商城信息(下)
之前我们使用了selenium加Firefox作为下载中间件来实现爬取京东的商品信息.但是在大规模的爬取的时候,Firefox消耗资源比较多,因此我们希望换一种资源消耗更小的方法来爬取相关的信息. 下 ...
- scrapy爬取京东iPhone11评论(一)
咨询行业中经常接触到文本类信息,无论是分词做词云图,还是整理编码分析用,都非常具有价值. 本文将记录使用scrapy框架爬取京东IPhone11评论的过程,由于一边学习一边实践,更新稍慢请见谅. 1. ...
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
随机推荐
- 车间管理难?APS系统为你智能排程
对 APS系统不熟或者不了解他的一些运行规则也是在实施项目中导致经常不能正常运行不可忽视的因素,对 APS系统的早期了解是整个项目实施运行的成功至关重要的因素. 如果不了解 APS潜在的因素和运行准则 ...
- PHP实现智能语音播报
原文地址 https://www.jianshu.com/p/91a046ec6ebc 大家估计都知道现在很多AI音响能够给你播报天气,叫你起床...甚至能够接受语音指令!所谓的人工智能音响,听起来很 ...
- Java开发环境之RabbitMQ
查看更多Java开发环境配置,请点击<Java开发环境配置大全> 捌章:RabbitMQ安装教程 1)下载安装Erlang 官网下载:http://www.erlang.org,有时比较难 ...
- 【Docker】docker的安装和常用命令
一.docker安装和启动 1.yum 命令 yum install docker 2.docker启动命令 sudo systemctl start docker 二.docker常用命令 dock ...
- 17、Learning and Transferring IDs Representation in E-commerce笔记
一.摘要 电子商务场景:主要组成部分(用户ID.商品ID.产品ID.商店ID.品牌ID.类别ID等) 传统的编码两个缺陷:如onehot,(1)存在稀疏性问题,维度高(2)不能反映关系,以两个不同的i ...
- C#Winform使用CefSharp将WebBowser控件替换为Chrome内核
先废话一段 ,好久没写博客了,也是跟环境工作有关,之前做技术,天天博客园的翻着 (还是喜欢博客园,因为大家都无私分享交流啊,不像CSDN啥东西都要积分,鄙视之),现在偶尔需要个什么东西了才打开VS写写 ...
- Linux 安装Anaconda 提示“bunzip2: command not found”
问题: 安装Anaconda 过程中提示缺少“bunzip2” 解决思路: 由于缺少bunzip2 包,需要通过yum 方式安装bzip2 yum install -y bzip2 Linux bun ...
- test20190903 JKlover
100+65+100=265,T2就差了一点. 乌合之众 给出一个 n × n 的, 元素为自然数的矩阵.这个矩阵有许许多多个子矩阵, 定义它的所有子矩阵形成的集合为 S . 对于一个矩阵 k , 定 ...
- PHP——仿造微信OpenId
前言 这就是拿来玩的,其次假的就是假的,成不了真的! 代码 首先我观察了两个公众号关注后的生成openid的规则,发现了以下规则 1. OpenID都是28位 2. 前六位是有规律的 然后接下来就按着 ...
- modbus-poll和modbus-slave工具的学习使用——环境搭建
在modbus的学习工具中,非modbus-poll和modbus-slave莫属了,在电脑上模拟的过程中,两者缺一不可 ,当然还需要虚拟串口工具:Configure Virtual Serial P ...