
聊聊Lambda架构
定义
在数据分析场景中,我们可能会遇到这样的问题。例如,我们要做一个推荐系统,如果我们用批处理任务去做,一天或者一小时的推荐频次明显延迟太大。如果用流处理任务,虽然延迟的问题解决了,然而只用实时数据而没有历史数据,那么准确性就无法保证。因此需要结合批处理的历史数据和流处理的实时数据进行处理,既能保证准确性,又能保证实时性。再比如反作弊系统,实时识别作弊用户的时候同时需要用到用户的历史行为。
针对上述问题,Storm 的作者 Nathan Marz 提出了 Lambda 架构。根据维基百科的定义,Lambda 架构的设计是为了在处理大规模数据时,同时发挥流处理和批处理的优势。通过批处理提供全面、准确的数据,通过流处理提供低延迟的数据,从而达到平衡延迟、吞吐量和容错性的目的。为了满足下游的即席查询,批处理和流处理的结果会进行合并。
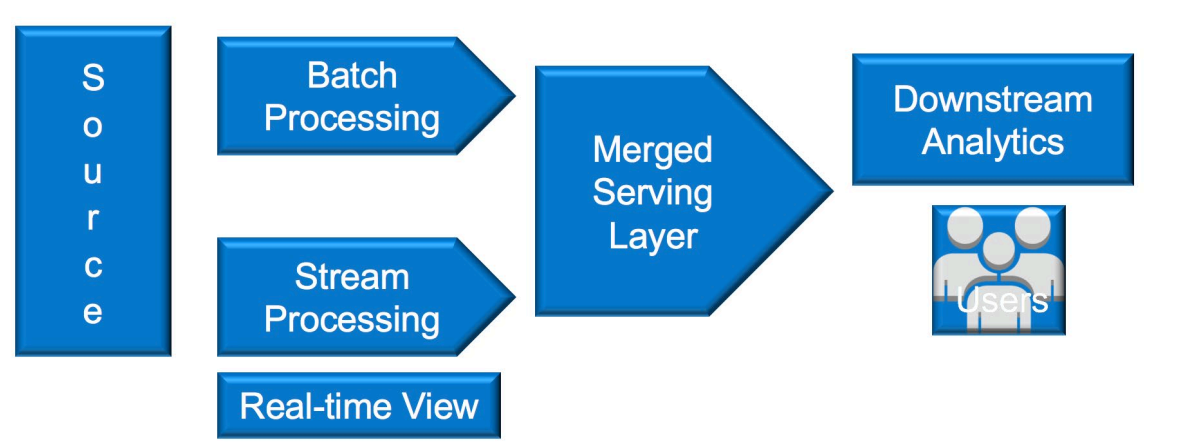
从上面定义可以看出,Lambda 架构包含三层,Batch Layer、Speed Layer 和 Serving Layer。架构图如下:
下面分别介绍这三层架构的作用。
- Batch Layer:批处理层,对离线的历史数据进行预计算,为了下游能够快速查询想要的结果。由于批处理基于完整的历史数据集,因此准确性可以得到保证。批处理层可以用 Hadoop、Spark 和 Flink 等框架计算
- Speed Layer:加速处理层,处理实时的增量数据,这一层重点在于低延迟。加速层的数据不如批处理层那样完整和准确,但是可以填补批处理高延迟导致的数据空白。加速层可以用 Storm、Spark streaming 和 Flink 等框架计算
- Serving Layer:合并层,计算历史数据和实时数据都有了, 合并层的工作自然就是将两者数据合并,输出到数据库或者其他介质,供下游分析。
Amazon AWS 的 Lambda 架构
这里,我将用 AWS 作为例子来介绍 Lambda 架构,AWS Lambda 架构图如下
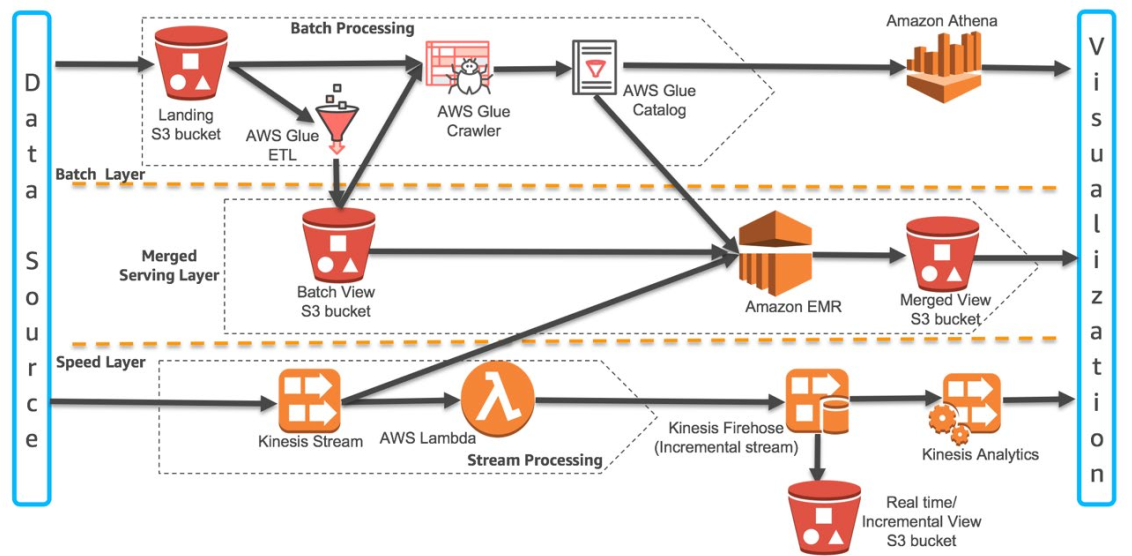
Batch Layer:使用 S3 bucket 从各种数据源收集数据,使用 AWS Glue 进行 ETL,输出到 Amazon S3。数据也可以输出到 Amazon Athena (交互式查询工具)
Speed Layer: 从上图看加速层有三个过程
- Kinesis Stream 从实时数据流中处理增量的数据,这部分数据数据输出到 Serving Layer 的 Amazon EMR,也可以输出到 Kinesis Firehose 对增量数据进行后续处理
- Kinesis Firehose 处理增量数据并写入 Amazone S3 中
- Kinesis Analytics 提供 SQL 的能力对增量的数据进行分析
其实只有上面第一个组件与我们今天讨论的 Lambda 架构有关,其他两个组件只是针对实时处理的。
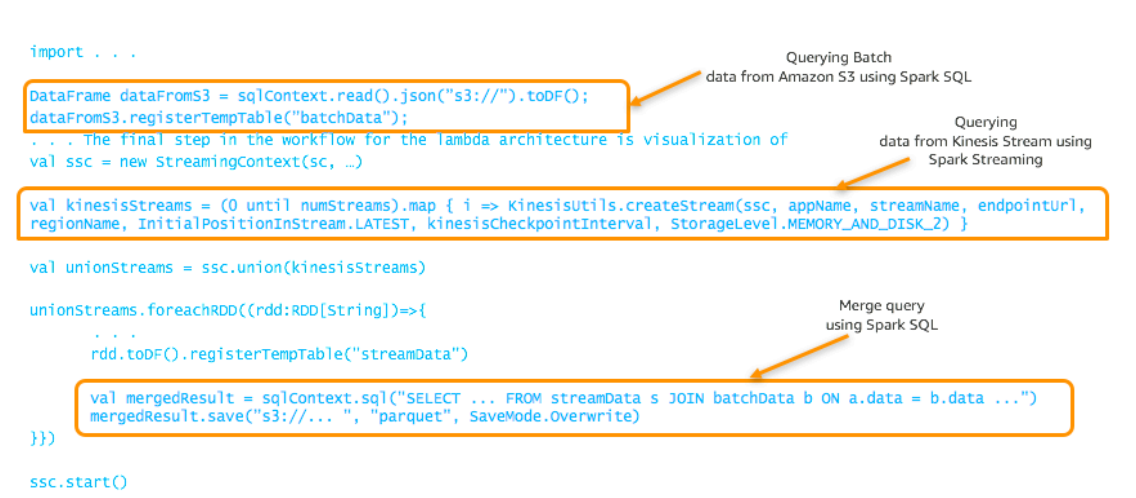
Serving Layer:合并层使用基于 Amazon EMR 的 Spark SQL 来合并 Batch Layer 和 Speed Layer 的数据。批处理数据可以从 Amazon S3 加载批处理数据,实时数据可以从 Kinesis Stream 直接加载,合并的数据可以写到 Amazone S3。下面是一段合并数据代码
以上便是 Amazon AWS 实现 Lambda 架构的简单介绍。
我的经历
接下来分享下我之前的项目经历。其实,我们的项目跟上面的 Lambda 架构并不是特别贴合,但是我觉得思想是一致的。本质上都是批处理和流处理相关补充,同时发挥二者的优势。
我们的业务是处理用户的定位数据,最开始主要使用 Spark Streaming 进行增量处理,处理后的数据实时写入 MongoDB。数据读写以用户 id 为粒度,由于粒度比较细,因此每天的数据量比较大。前端如果查询时间跨度较大的数据,每次都需按照用户粒度数据做聚合,导致查询响应比较慢且容易影响实时写入。因此,我们用批处理任务对历史的离线数据进行预计算,再存储到 MongoDB。同时我们开发了基于 gRPC 实现的一套 Service 来充当 Serving Layer,将历史的数据与实时的数据合并返回给前端,避免前端直接连接数据库。在这个项目中我们的 Batch Layer 和 Speed Layer 都是用的 Spark 框架,因此维护相对容易。
之前介绍 Lambda 都是用加速层弥补批处理层的空白,但是上面的例子中是用批处理层弥补加速层的不足。因此,架构设计只是一个思想,具体的实施还是要根据业务进行灵活变通,不能生搬硬套。
小结
本篇文章简单介绍了 Lambda 架构的内容,同时介绍了 Amazon AWS 实现 Lambda 架构的例子。最后举了一个我自己项目中的一个例子。经过整篇内容我们了解了 Lambda 架构的优势,但是它有没有缺点呢。显然也是有的,我能想到的有以下几点:
- 批处理层、加速层和合并层用到的框架可能不一样,因此会增加了开发的成本
- 批处理层和加速层处理的结果有可能不一致,如果用户看到的数据会变,这个体验不太好
- 如果某一层的逻辑变了,是不是其他两层或者一层的逻辑也要跟着变,因此层与层处理逻辑耦合度较大
你还能想到其他的问题吗, 以及有没有更好的架构能解决这个问题?欢迎交流
欢迎关注公众号「渡码」

聊聊Lambda架构的更多相关文章
- 大数据Lambda架构
1 Lambda架构介绍 Lambda架构划分为三层.各自是批处理层,服务层,和加速层.终于实现的效果,能够使用以下的表达式来说明. query = function(alldata) 1.1 批处理 ...
- 大数据平台Lambda架构详解
Lambda架构由Storm的作者Nathan Marz提出.旨在设计出一个能满足.实时大数据系统关键特性的架构,具有高容错.低延时和可扩展等特. Lambda架构整合离线计算和实时计算,融合不可变( ...
- Others-大数据平台Lambda架构浅析(全量计算+增量计算)
大数据平台Lambda架构浅析(全量计算+增量计算) 2016年12月23日 22:50:53 scuter_victor 阅读数:1642 标签: spark大数据lambda 更多 个人分类: 造 ...
- Lambda架构
转载:https://blog.csdn.net/brucesea/article/details/45937875 1.Lambda架构背景介绍 Lambda架构是由Storm的作者Nathan M ...
- 【大数据】大数据处理-Lambda架构-Kappa架构
大数据处理-Lambda架构-Kappa架构 elasticsearch-head Elasticsearch-sql client NLPchina/elasticsearch-sql: Use S ...
- lambda架构简介
1.Lambda架构背景介绍 Lambda架构是由Storm的作者Nathan Marz提出的一个实时大数据处理框架.Marz在Twitter工作期间开发了著名的实时大数据处理框架Storm,Lamb ...
- 带有Apache Spark的Lambda架构
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 目标 市场上的许多玩家已经建立了成功的MapReduce工作流程来每天处理以TB计的历史数据.但是谁愿意等待24小时才能获得最新的分析结果? ...
- 大数据处理中的Lambda架构和Kappa架构
首先我们来看一个典型的互联网大数据平台的架构,如下图所示: 在这张架构图中,大数据平台里面向用户的在线业务处理组件用褐色标示出来,这部分是属于互联网在线应用的部分,其他蓝色的部分属于大数据相关组件,使 ...
- 深入理解大数据架构之——Lambda架构
目录 传统系统的问题 Lambda架构简介 Lambda架构关键特性 数据系统的本质 Lambda的三层架构 Lambda架构组件选型 总结 原文链接:https://jiang-hao.com/ar ...
随机推荐
- wpf 代码设置图片路径(后台和xamll)
项目中经常使用背景图片,当一个小组共通开发时,路径的选择应该是在项目运行的固定文件夹下 此时,可用代码实现:pack://SiteOfOrigin:,,,/Images/Icons/HomePageB ...
- 个人项目wc(Java)
个人项目(Java) 一丶Github地址:https://github.com/SAH2019/S ...
- 【原创】Centos 7 升级安装python3.7.4
1.安装必须的软件 #更新源中包列表 yum -y update #先安装扩展源EPEL 才能安装pip 否则会报错 yum -y install epel-release //解决ssl问题,否则报 ...
- Odoo学习笔记一:odoo初探
转载请注明原文地址:https://www.cnblogs.com/ygj0930/p/11189194.html 一:Odoo架构 1:数据库服务器层:postgreSQL数据库服务器,用于存储所有 ...
- Windows | Ubuntu 16.04/18.04 安装Pycharm并永久破解以及安装配置Anaconda3
Ubuntu 18.04下 1.安装python 2._版本,输入 sudo apt install python 命令行输入 python或python3会打开对应的版本. 输入 exit()或C ...
- pdfium去掉v8支持
GYP_DEFINES='pdf_enable_v8=0 pdf_enable_xfa=0' build/gyp_pdfium 未测试 ???????????
- day10_7.10 函数的嵌套等
一.命名关键字参数.(了解) 1.在函数阶段,写在*与** 可变长参数之间的形参称为命名关键字参数. 在给命名关键字参数传值时,只能用关键字为其传值.诸如以下函数的形参 def func(x,y=,* ...
- Mybatis-Plus 代码生成器基本使用
Mybatis-Plus 代码生成器基本使用 参考 https://mp.baomidou.com/guide/generator.html#%E4%BD%BF%E7%94%A8%E6%95%99%E ...
- Spring Data介绍
Spring Data是Spring 的一个子项目.用于简化数据库访问,支持NoSQL和关系数据库存储.其主要目标是使数据库的访问变得方便快捷. Spring Data 项目所支持NoSQL存储: M ...
- NOIP 2005 采药
洛谷 P1048 采药 洛谷传送门 JDOJ 1277: [NOIP2005]采药 T3 JDOJ传送门 Description 辰辰是个天资聪颖的孩子,他的梦想是成为世界上最伟大的医师.为此,他 ...