
12 IO流(九)——装饰流 BufferedInputStream/OutputStream
我们按功能可以将IO流分为节点流与处理流
节点流:可以直接从数据源或目的地读写数据
处理流(装饰流):不直接连接到数据源或目的地,是其他流(必须包含节点流)进行封装。目的主要是简化操作和提高性能。
Buffered流的引入
当我们使用节点流来传输数据时,节点流单次传输的数据太少,会频繁读写硬盘,这使得整体速度不高,就像蚂蚁搬家。
这时我们引入处理流Buffered流,就好像找来一辆卡车来搬家,单次运输的数据多了,访问硬盘的次数少了,速度得到提升。
copy文件示例
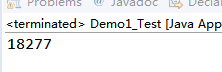
不引入Buffered流copy一个600m的文件,计算它所花费的时间,此节点流的缓冲区大小为1024B
import java.io.*;

public class IOTest01

{

	public static void main(String[] args)

	{

		//文件源

		String src = "1.rar";

		String dest = "1_cp.rar";

		//计算copy花费的时间

		long l1 = System.currentTimeMillis();

		copy(src,dest);

		long l2 = System.currentTimeMillis();

		long time = l2-l1;

		System.out.println(time);

	}

	public static void copy(String srcPath,String destPath){

		//选择流

		//操作

		try(InputStream is = new FileInputStream(srcPath);

			OutputStream os = new FileOutputStream(destPath)){

			byte[] flush = new byte[1024];

			int len = -1;

			while((len = is.read(flush))!=-1){//读入

				os.write(flush,0,len);//写出

			}

			os.flush();//刷新

		}catch(IOException e){

			e.printStackTrace();

		}

	}

}
输出时间(cmd中):
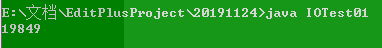
输出时间(Eclipse中):
引入Buffered流 重点
引用Buffered流包装的方法一
InputStream is = new FileInputStream(filePath);
InputStream bis = new BufferedInputStream(is);
输出流同理
引用Buffered流包装的方法二
InputStream bis = new BufferedInputStream(new FileInputStream(filePath));
输出流同理
其它
Buffered流无需放在最外层,只需要保证它在节点流外层即可。
包装后的copy的时间花费
copy 600MB文件,缓冲区为byte[1024]情况下:
在Eclipse中
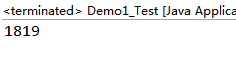
甚至在Eclipse中多运行几次后时间也变长了:

这是为什么???
在cmd中
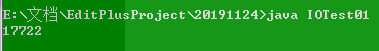
为何差别这么大????
提出问题
设想不引用Buffered流,直接修改字节流的缓冲池大小,看能不能提高速度(600MB的文件):
当缓冲池大小为byte[1024*1000]花费的时间为:

当缓冲池大小为byte[1024*100]花费的时间为:
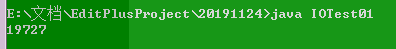
当缓冲池大小为byte[1024*50]花费的时间为:
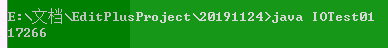
当缓冲池大小为byte[1024*20]花费的时间为:
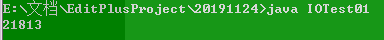
当缓冲池大小为byte[1024*8]花费的时间为:
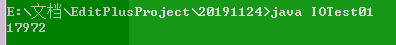
可见缓冲区大小与花费时间不成规律,这究竟是怎么回事呢?
完整代码
import java.io.*;

public class IOTest01

{

	public static void main(String[] args)

	{

		//文件源

		String src = "1.rar";

		String dest = "1_cp.rar";

		//计算copy花费的时间

		long l1 = System.currentTimeMillis();

		copy(src,dest);

		long l2 = System.currentTimeMillis();

		long time = l2-l1;

		System.out.println(time);

	}

	public static void copy(String srcPath,String destPath){

		//选择流

		//操作

		try(InputStream is = new BufferedInputStream(new FileInputStream(srcPath));

			OutputStream os = new BufferedOutputStream(new FileOutputStream(destPath))){

			byte[] flush = new byte[1024];

			int len = -1;

			while((len = is.read(flush))!=-1){//读入

				os.write(flush,0,len);//写出

			}

			os.flush();//刷新

		}catch(IOException e){

			e.printStackTrace();

		}

	}

}
12 IO流(九)——装饰流 BufferedInputStream/OutputStream的更多相关文章
- Java IO流以及装饰器模式在其上的运用
流概述 Java中,流是一种有序的字节序列,可以有任意的长度.从应用流向目的地称为输出流,从目的地流向应用称为输入流. Java的流族谱 Java的 java.io 包中囊括了整个流的家族,输出流和输 ...
- 12 IO流
File类:构造方法 * File(String pathname):根据一个路径得到File对象 * File(String parent, String child):根据一个目录和一 ...
- IO流与装饰者模式
java使用IO流来处理不同设备之间数据的交互;所有的IO操作实际上都是对 Stream 的操作 从功能上划分: 输入流: 当数据从源进入的编写的程序时,称它为输入流; 输出流: 从程序输出回另一个源 ...
- java 输入输出IO流 字节流| 字符流 的缓冲流:BufferedInputStream;BufferedOutputStream;BufferedReader(Reader in);BufferedWriter(Writer out)
什么是缓冲流: 缓冲流的基本原理,是在创建流对象时,会创建一个内置的默认大小的缓冲区数组,通过缓冲区读写,减少系统IO次数,从而提高读写的效率. 图解: 1.字节缓冲流BufferedInputStr ...
- 13 IO流(十)——BufferedReader/BufferedWriter 装饰流
Buffered字符包装流 与Buffered字节装饰流一样,只不过是对字符流进行包装. 需要注意的地方 Buffered字符流在Reader与Writer上有两个新的方法:String readLi ...
- java IO之 字符流 (字符流 = 字节流 + 编码表) 装饰器模式
字符流 计算机并不区分二进制文件与文本文件.所有的文件都是以二进制形式来存储的,因此, 从本质上说,所有的文件都是二进制文件.所以字符流是建立在字节流之上的,它能够提供字符 层次的编码和解码.列如,在 ...
- java 21 - 12 IO流的打印流
打印流 字节流打印流 PrintStream 字符打印流 PrintWriter打印流的特点: A:只有写数据的,没有读取数据.只能操作目的地,不能操作数据源.(只能写入数据到文件中,而不能从文件中提 ...
- java IO流 之 其他流
一.内存操作流(ByteArrayInputStream.ByteArrayOutputStream) (一). public class ByteArrayInputStream extends ...
- JAVA IO 字节流与字符流
文章出自:听云博客 题主将以三个章节的篇幅来讲解JAVA IO的内容 . 第一节JAVA IO包的框架体系和源码分析,第二节,序列化反序列化和IO的设计模块,第三节异步IO. 本文是第一节. ...
随机推荐
- Nodejs仿Apache的部分功能
一.初步实现Apache的部分功能 //1.加载模块 var http=require('http'); var fs=require('fs'); //2.创建server var server=h ...
- Codeforces 526C.Om Nom and Candies
题目描述 一个只有两个物品的背包问题,但是范围都是1e9,需要考虑根号或者log的复杂度. 如果这两个物品中的某一个花费超过了根号C,那么我们可以直接枚举这件物品的数量,另一件物品的数量可以计算得出. ...
- mysql max()函数,min()函数,获取最大值以及最小值
mysql> select * from table1; +----------+------------+-----+---------------------+ | name_new | t ...
- 微信小程序之使用wx:for遍历循环
效果图如下: 实现代码如下:type.js: // pages/type/type.js Page({ /** * 页面的初始数据 */ data: { types: "" }, ...
- 第10组Alpha冲刺(1/4)
队名:凹凸曼 组长博客 作业博客 组员实践情况 童景霖 过去两天完成了哪些任务 文字/口头描述 学习Android studio和Java,基本了解APP前端的制作 完善项目APP原型 展示GitHu ...
- Devops(四):Docker 镜像管理
参考 <Docker中上传镜像到docker hub中> <Docker 镜像管理> <通过容器提交镜像(docker commit)以及推送镜像(docker push ...
- Facets:一款Google开源机器学习数据集可视化工具
Homepage/演示网站:https://pair-code.github.io/facets/ Pypi:https://pypi.org/project/facets-overview/ Git ...
- 更新Alpine Linux源 sed -i 's/dl-cdn.alpinelinux.org/mirrors.ustc.edu.cn/g' /etc/apk/repositories apk add xxx
更新Alpine Linux源 国内镜像源 清华TUNA镜像源:https://mirror.tuna.tsinghua.edu.cn/alpine/中科大镜像源:http://mirrors.ust ...
- 关于idea跳过错误编译的理解, 跳过报错的代码启动项目去debug测试其他正常的代码
关于idea跳过错误编译的理解 2018年07月13日 19:06:32 weixin_39669410 阅读数 1296 其实idea使用eclipse编译器可以实现跳过报错的代码启动项目去de ...
- Mqtt paho 回调函数触发机制跟踪
Python Mqtt paho 回调函数触发机制跟踪,我使用的是 buildroot 里面的 mqtt paho , 代码在 ''' buildroot-2017.02.8/output/build ...