
python3.4+pyspider爬58同城(二)
之前使用python3.4+selenium实现了爬58同城的详细信息,这次用pyspider实现,网上搜了下,目前比较流行的爬虫框架就是pyspider和scrapy,但是scrapy不支持python3,所以…
直接上代码,后面注解:
|
#!/usr/bin/env python from pyspider.libs.base_handler import * class Handler(BaseHandler): @every(minutes=24 * 60) @config(age=10 * 24 * 60 * 60) @config(priority=2) return { |
crawl_config = { 'itag':'v226' } #访问表头,useragent等请求信息都是在这里配置,其中itag表示版本的意思。pyspider有一个机制,如果在主页run一遍,那么每个请求的url都会有一个md5,标记这个任务已经结束,你再次点击run,pyspider不会再去请求同样的url,所以有时候我们修改完代码后,需要让任务执行一遍,重新将itag的版本号改一下就行。 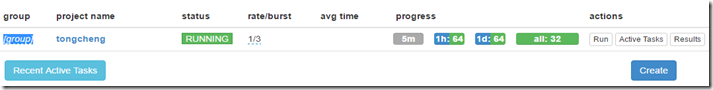 |
|
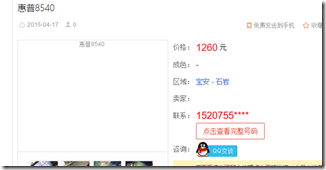
on_start 函数类似java main函数,是运行代码的入口。 self.crawl('http://sz.58.com/pbdn/0/pn1/', callback=self.index_page) #意思是去请求'http://sz.58.com/pbdn/0/pn1/'网址,返回的内容交给index_page这个函数去处理。 index_page 函数,处理'http://sz.58.com/pbdn/0/pn1/'网址返回的内容,从代码我们可以看到,pyspider请求网站返回的对象都是用response为变量,而responce.doc()意思就是使用pyquery去处理网页返回的内容,所以responce.doc()该方法其实类似于: from pyquery import PyQuery as doc 将pyquery封装。 detail_page函数作用,就是获取网页的详细信息,获取下图区域,价格,浏览量等信息,并且返回一个字典
|
|
fetch_type='js' #pyspider调用phantomjs去渲染js,因为浏览量是js渲染,如果我们使用requests去请求,得不到该数据。pyspider已经封装了调用phantomjs函数库,所以我们在使用fetch_type时候,要保证安装了phantomjs。 |
|
@every(minutes=24 * 60) 这些装饰器作用是告诉pyspider多久自动执行一次,这样我们每天就可以获取最新的信息,此处代表每天执行一次。 @config(age=10 * 24 * 60 * 60)表示已经得到的数据保留十天,十天后弃掉 |
python3.4+pyspider爬58同城(二)的更多相关文章
- python3.4+selenium爬58同城(一)
爬取http://bj.58.com/pbdn/0/pn2/中除转转.推广商品以外的产品信息,因为转转和推广的详情信息不规范,需要另外写一个方法存放,后期补上,详情页如下 这周学习了爬虫,但是遇到一些 ...
- Python 爬58同城 城市租房信息
爬取完会自动生成csv电子表格文件,含有房价.押付.链接等信息 环境 py2.7 pip install lxml pip install cssselect #coding:utf-8 impo ...
- 使用Python3.x抓取58同城(南京站)的演出票的信息
#!/usr/bin/env python #-*-coding: utf-8 -*- import re import urllib.request as request from bs4 impo ...
- python3爬虫-爬取58同城上所有城市的租房信息
from fake_useragent import UserAgent from lxml import etree import requests, os import time, re, dat ...
- scrapy爬取58同城二手房问题与对策
测试环境: win10,单机爬取,scrapy1.5.0,python3.6.4,mongodb,Robo 3T 其他准备: 代理池:测试环境就没有用搭建的flask抓代理,因为我找到的几个免费网站有 ...
- 用Python写爬虫爬取58同城二手交易数据
爬了14W数据,存入Mongodb,用Charts库展示统计结果,这里展示一个示意 模块1 获取分类url列表 from bs4 import BeautifulSoup import request ...
- 养只爬虫当宠物(Node.js爬虫爬取58同城租房信息)
先上一个源代码吧. https://github.com/answershuto/Rental 欢迎指导交流. 效果图 搭建Node.js环境及启动服务 安装node以及npm,用express模块启 ...
- 利用python爬取58同城简历数据
利用python爬取58同城简历数据 利用python爬取58同城简历数据 最近接到一个工作,需要获取58同城上面的简历信息(http://gz.58.com/qzyewu/).最开始想到是用pyth ...
- 【Android测试】【随笔】与 “58同城” 测试开发交流
◆版权声明:本文出自胖喵~的博客,转载必须注明出处. 转载请注明出处:http://www.cnblogs.com/by-dream/p/5384698.html 初衷 一直都有一个这样的想法: 虽然 ...
随机推荐
- Linux - create usergroup, user and Assigning permissions
第一步:登录已有的Linux系统,使用root账户,登录好以后,如下图: 这样,就登录到Linux系统中,而且是用root用户登录的 注意:如果,你想要创建用户和用户组,那么你当前登录的用户必须有ro ...
- windows安装配置mysql-5.7.13-winx64方法
1.mysql-5.7.13-winx64.zip下载 官方下载地址:http://dev.mysql.com/downloads/mysql/ 2.解压到D:\mysql\mysql-5.7.13- ...
- 符号化Symbol(符号)体系
http://apps.hi.baidu.com/share/detail/23143648# 符号化Symbol(符号)体系 ArcGIS Engine9.3为开发人员提供了32种符号,主要分为三大 ...
- The square chest
The square chest Sophia pressed the button in front of her, slamming her fist against it. The door r ...
- yii第一个应用blog
1. 连接到数据库 大多数 Web 应用由数据库驱动,我们的测试应用也不例外.要使用数据库,我们首先需要告诉应用如何连接它.修改应用的配置文件 WebRoot/testdrive/protected/ ...
- 【HDU1394】Minimum Inversion Number(线段树)
大意:n次操作原串查询逆序数,求出所有串中最小的逆序数. 求逆序数属于线段树的统计问题,建立空树,每次进行插点时进行一次query操作即可.n次操作可以套用结论:如果是0到n的排列,那么如果把第一个数 ...
- 【转载】视频编码(H264概述)
一视频编码介绍 1.1 视频压缩编码的目标 1)保证压缩比例 2)保证恢复的质量 3)易实现,低成本,可靠性 1.2 压缩的出发点(可行性) 1)时间相关性 在一组视频序列中,相邻相邻两帧只有极少的不 ...
- JConsole 连接配置
远程监控配置 JDK配置 在%JAVA_HOME%/jre/lib/management目录下,jmxremote.password.template.jmxremote.password需要修改配置 ...
- 禁止 favicon.ico 请求
favicon.ico 图标用于收藏夹图标和浏览器标签上的显示,如果不设置,浏览器会请求网站根目录的这个图标,如果网站根目录也没有这图标会产生 404.出于优化的考虑,要么就有这个图标,要么就禁止产生 ...
- ios变量的property属性设置和意义
IOS 的@property和@synthesize帮我们轻易的生成对象的getter和setter方法来完成对对象的赋值和访问.但是如果我们如果要动态设置对象的getter和setter方法可以使用 ...