
macbook安装scala、hadoop、saprk环境
一、scala安装
1. 安装jdk
有mac专用的jdk安装包,这里下载安装jdk1.8
2. 安装scala
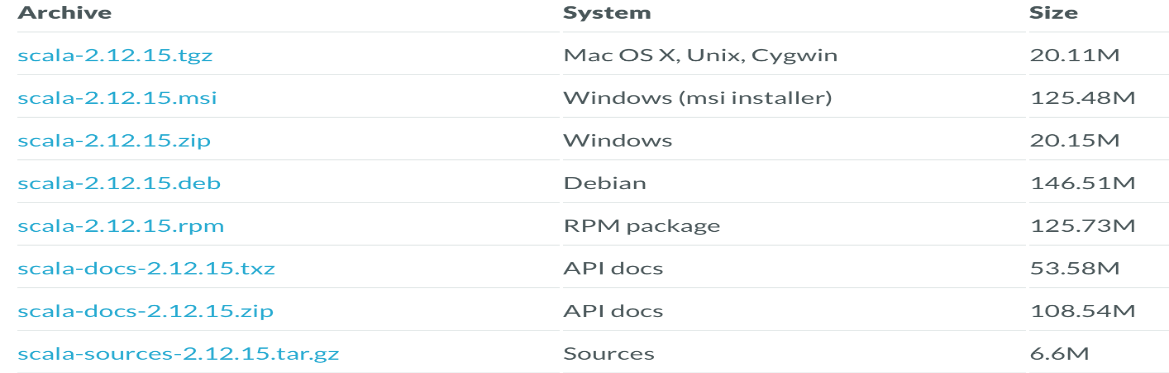
2.1下载scala
2.2解压到指定目录
tar -zxvf /Users/lodestar/Desktop/临时/scala-2.12.15.tar -C /Users/lodestar/software
2.3环境变量配置
vi ./bash_profile
我本机装过python和maven,这里再加入scala配置
PATH="/Library/Frameworks/Python.framework/Versions/3.7/bin:${PATH}"
export PATH
export M2_HOME=/Library/apache-maven-3.6.3
export PATH=$PATH:$M2_HOME/bin
export SCALA_HOME=/Users/lodestar/software/scala-2.12.15
export PATH=$SCALA_HOME/bin:$PATH
保存退出
source .bash_profile让配置生效
echo $SCALA_HOME 验证配置是否生效
2.4.执行./scala进入控制台

2.5 编写,编译执行scala代码
文件后缀.scala;编译:scalac Helloworld.scala
3.Hadoop安装
3.1下载后解压到指定目录
tar -zxvf /Users/lodestar/Desktop/临时/hadoop-2.8.5.tar.gz -C /Users/lodestar/hadoop
hadoop目录结构如下:
bin:客户端工具
sbin:启动hadoop相关进程的脚本
etc/hoadoop:hadoop配置文件
share:常用例子
3.2 hadoop参数配置
vi ./bash_profile
export HADOOP_HOME=/Users/lodestar/hadoop/hadoop-2.8.5
export PATH=$HADOOP_HOME/bin:$PATH
export JAVA_HOME= /Library/Java/JavaVirtualMachines/jdk1.8.0_201.jdk/Contents/Home
export PATH=$JAVA_HOME/bin:$PATH
hadoop-env.sh
export JAVA_HOME= /Library/Java/JavaVirtualMachines/jdk1.8.0_201.jdk/Contents/Home
core-site.xml
<property>
<name>fs.defaultFS</name>
<value>hdfs://localhost:8020</value>
</property>
hdfs-site.xml
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/Users/lodestar/hadoop/tmp</value>
</property>
slaves
hadoop000
3.4.ssh免密码登录,否则启动hadoop需要不断输入密码
--hadoop用户操作
ssh localhost --产生.ssh的隐藏目录
ssh-keygen -t rsa --产生密钥对(1路回车)
cat id_rsa.pub >> authorized_keys --讲公钥写入authorized_keys
chmod 600 authorized_keys --authorized_keys 只有创建者有读写权限
ssh localhost 测试,不需要密码配置成功
3.5 初始化文件系统
第一次启动前格式化文件系统
hdfs namenode -format
3.6 启动hadoop
进入sbin目录:
启动Start-dfs.sh
关闭stop-dfs.sh
3.7验证
Jps命令查询看到namenode和datanode进程
测试一下:
hadoop fs -ls /
hadoop fs -put README.txt /
进入浏览器查看hdfs状态
4 Spark安装和配置
4.1、Spark安装
tar xvf /Users/lodestar/Desktop/临时/spark-3.0.3-bin-hadoop2.7.tar -C /Users/lodestar/spark
4.2、Spark配置
1.配置环境变量
修改~/.bash_profile
export SPARK_HOME=/Users/lodestar/spark/spark-3.0.3-bin-hadoop2.7
export PATH=$SPARK_HOME/bin:$SPARK_HOME/sbin:$PATH
使得配置修改生效:source .bash_profile
2.修改配置文件spark-env.sh
1.修改conf下的spark-env.sh.template为spark-env.sh
cp spark-env.sh.template spark-env.sh
2:修改配置
export JAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.8.0_201.jdk/Contents/Home
export SCALA_HOME=/Users/lodestar/software/scala-2.12.15
export SPARK_HOME=/Users/lodestar/spark/spark-3.0.3-bin-hadoop2.7
#SPRAK MASTER地址
export SPARK_MASTER_IP=127.0.0.1
export SPARK_LOCAL_IP=127.0.0.1
export SPARK_EXECUTOR_MEMORY=500M
export SPARK_WORKER_MEMORY=1G
#spark master UI地址
export master=spark://127.0.0.1:7070
3.修改配置文件slaves
1.修改conf下的spark-env.sh.template为spark-env.sh
cp slaves.template slaves
echo “localhost” >> slaves
4.启动spark
./start-all.sh
使用jps查看,master上会有Master和Worker,worker节点上会有Worker
http://1192.168.251.86:8080查看spark的web界面
5.执行spark提供的默认demo
spark-submit --class org.apache.spark.examples.SparkPi --master spark://lodestardembp-2:7077 /Users/lodestar/spark/spark-3.0.3-bin-hadoop2.7/examples/jars/spark-examples_2.12-3.0.3.jar
--这里以前写的是localhos:7077,始终不能正常解析,后面换成spark web ui上的机器名
macbook安装scala、hadoop、saprk环境的更多相关文章
- Spark简单介绍,Windows下安装Scala+Hadoop+Spark运行环境,集成到IDEA中
一.前言 近几年大数据是异常的火爆,今天小编以java开发的身份来会会大数据,提高一下自己的层面! 大数据技术也是有很多: Hadoop Spark Flink 小编也只知道这些了,由于Hadoop, ...
- scala+hadoop+spark环境搭建
一.JDK环境构建 在指定用户的根目录下编辑.bashrc文件,添加如下部分: # .bashrc # Source global definitions if [ -f /etc/bashrc ]; ...
- RHEL7.2 安装Eclipse-oxygen Hadoop开发环境
1 Eclipse-oxygen下载地址 http://www.eclipse.org/downloads/download.php?file=/technology/epp/downloads/re ...
- [Linux] 安装JDK和Maven及hadoop相关环境
紧接上一篇,继续安装hadoop相关环境 JDK安装: 1. 下载,下面这两个地址在网上找的,可以直接下载: http://download.oracle.com/otn-pu ...
- 安装Scala开发环境
Scala 介绍 Step 1: 安装 Java开发环境 Scala 版本与Java版本的兼容关系 从Oracle网站下载JDK URL: http://www.oracle.com/technetw ...
- linux环境下载和安装scala
Linux下安装Scala和Windows下安装类似,步骤如下: 1.首先访问下载链接:http://www.scala-lang.org/download/默认这里下载的是Windows版本,这时点 ...
- 从VMware虚拟机安装到hadoop集群环境配置详细说明(第一期)
http://blog.csdn.net/whaoxysh/article/details/17755555 虚拟机安装 我安装的虚拟机版本是VMware Workstation 8.04,自己电脑上 ...
- ubuntu环境下eclipse的安装以及hadoop插件的配置
ubuntu环境下eclipse的安装以及hadoop插件的配置 一.eclipse的安装 在ubuntu桌面模式下,点击任务栏中的ubuntu软件中心,在搜索栏搜索eclipse 注意:安装过程需要 ...
- linux安装scala环境
(安装scala的前提是已经安装好了jdk) 1.下载scala的安装包 wget https://scala-lang.org/files/archive/scala-2.11.0-M2.tgz 2 ...
随机推荐
- SYCOJ570传纸条
题目-传纸条 (shiyancang.cn) 算法(线性DP) O(n3)O(n3)首先考虑路径有交集该如何处理.可以发现交集中的格子一定在每条路径的相同步数处.因此可以让两个人同时从起点出发,每次同 ...
- Numpy实现简单BP神经网络识别手写数字
本文将用Numpy实现简单BP神经网络完成对手写数字图片的识别,数据集为42000张带标签的28x28像素手写数字图像.在计算机完成对手写数字图片的识别过程中,代表图片的28x28=764个像素的特征 ...
- 服务器表单字符串转化Vue表单挂在到对应DOM节点
今天在项目开发中,遇到从后端返回的vue文件(包含template,js,css)的文件,试过用v-html解析文件,渲染到页面,但是无法渲染,后来去查了一堆资料,自己写了一个全局方法来解析这类文件 ...
- day 17 i++优先级大于 *i
(1).有下列定义语句,int *p[4];以下选项中与此语句等价的是[C] (A).int p[4]; (B).int **P; (C).int *(p[4]); (D).int (*p)[4]; ...
- eclipse导入项目jdk版本不一样
一:eclipse导入项目jdk版本不一样解决方案 参考博文: https://www.cnblogs.com/chenmingjun/p/8472885.html 选中项目右键 --> Pro ...
- Redis的过期删除策略(和内存淘汰机制)-转
版权声明:本文为CSDN博主「奥修诺斯」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明.原文链接:https://blog.csdn.net/qq_39944869/ ...
- 5种高大上的yml文件读取方式,你知道吗?
原创:微信公众号 码农参上,欢迎分享,转载请保留出处. 在上一篇文章中,我们从源码角度分析了SpringBoot解析yml配置文件的全流程,那么我们今天就来点实战,总结一下除了烂大街的@Value和@ ...
- Python 安装MySQL 错误处理
正常情况下如果使用python 连接数据库需要安装 python-MySQL 类库 #pip install python-MySQL 等待安装完成即可 使用时 import MySQLdb ==== ...
- 返回值List是JsonArray
MyController中: index.jsp中
- Ubuntu14.4配置vnc
一.安装Xrdp Windows远程桌面使用的是RDP协议,所以ubuntu上就要先安装Xrdp,在ubuntu软件中心搜索xrdp安装. 安装xrdp的同时会自动安装vnc4server,xbase ...