cuSPARSELt开发NVIDIA Ampere结构化稀疏性
深度神经网络在各种领域(例如计算机视觉,语音识别和自然语言处理)中均具有出色的性能。处理这些神经网络所需的计算能力正在迅速提高,因此有效的模型和计算至关重要。神经网络剪枝(删除不必要的模型参数以生成稀疏网络)是一种在保持准确性的同时降低模型复杂性的有用方法。
为了利用细粒度的网络剪枝,NVIDIA Ampere GPU架构引入了细粒度的结构稀疏性的概念。在NVIDIA A100 GPU上,结构显示为2:4模式:每四个元素中至少有两个必须为零。通过使用新的NVIDIA Sparse Tensor Core跳过零值的计算,这可以将一个矩阵乘法(也称为GEMM)操作数的数据占用空间和带宽减少2倍,并使吞吐量翻倍。
cuSPARSELt:用于稀疏矩阵-密集矩阵乘法的高性能CUDA库
为了简化NVIDIA Ampere架构稀疏功能的使用,NVIDIA引入了cuSPARSELt ,这是一种高性能CUDA库,专用于常规矩阵操作,其中至少一个操作数是稀疏矩阵。cuSPARSELt库可以使用NVIDIA第三代Tensor Core稀疏矩阵乘累加(SpMMA)操作,而无需进行底层编程。该库还提供用于剪枝和压缩矩阵的辅助函数。
· NVIDIA Sparse Tensor Core支持
o BFLOAT16输入/输出,FP32张量核心累积
· Row-major and column-major memory layouts的内存布局
NVIDIA Sparse Tensor Core support
Mixed-precision support:
FP16 inputs/output, FP32 Tensor Core accumulation
BFLOAT16 inputs/output, FP32 Tensor Core accumulation
INT8 inputs/output, INT32 Tensor Core accumulation
Row-major and column-major memory layouts
Matrix pruning and compression utilities
Auto-tuning functionality
cuSPARSELt库遵循等效方法,并采用与
cuBLASLt和
cuTENSOR类似的概念。库编程模型要求以某种方式组织计算,以使相同的设置可以重复用于不同的输入。
· 用户偏好和约束:提供算法选择或限制可行实现(候选)的搜索空间。
· 计划:收集执行的描述符,并在需要时“找到”最佳实施。
1. 初始化库句柄:cusparseLtInit。
2. 指定输入/输出矩阵特征:cusparseLtDenseDescriptorInit, cusparseLtStructuredDescriptorInit。
3. 初始化矩阵乘法描述符和它的属性(例如操作,计算类型等): cusparseLtMatmulDescriptorInit。
4. 初始化算法选择描述符:cusparseLtMatmulAlgSelectionInit。
5. 初始化矩阵乘法计划:cusparseLtMatmulPlanInit。
6. 剪枝A矩阵:cusparseLtSpMMAPrune。如果用户提供已经满足2:4结构化稀疏性约束的矩阵,例如由
ASP库生成的权重矩阵,则不需要此步骤。
7. 压缩剪枝后的矩阵:cusparseLtSpMMACompress。
8. 执行矩阵乘法:cusparseLtMatmul。可以使用不同的输入多次重复此步骤。
9. 销毁矩阵乘法计划和库句柄:cusparseLtMatmulPlanDestroy,cusparseLtDestroy。
稀疏的GEMM性能
与密集矩阵乘法一样,稀疏矩阵乘法的性能随GEMM尺寸,布局和数据类型而变化。这是当前软件与稀疏GEMM相对性能的快照。
下表显示了cuSPARSELt和cuBLAS在以下操作中的性能:
D = alpha * op(A)* op(B)+ beta * C
在该操作中,A,B,和 D=C分别是尺寸的密集矩阵MXK,KXN,和M×N个。矩阵的布局A和B与Ñ为列主顺序(OP是非转置)和Ť为行优先顺序(OP调换)。
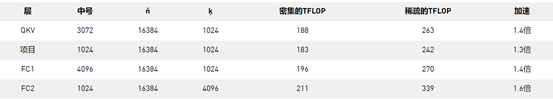
为了展示使用cuSPARSELt可以针对实际工作负载实现的性能,下表显示了带有主要列TN FP16内核的剪枝后的BERT-Large模型(seqlen = 128,BS = 128)使用的一些常见GEMM大小。通常,工作量越大,稀疏性可以提供的帮助越多。
表1. BERT-Large模型和不同层的cuSPARSELt性能。
结构化稀疏矩阵-矩阵乘法代码示例
首先,包括cuSPARSELt标头,设置一些设备指针和数据结构,并初始化cuSPARSELt句柄。
#include <cusparseLt.h> // cusparseLt header // Device pointers and coefficient definitions float alpha = 1.0f; float beta = 0.0f; __half* dA = ... __half* dB = ... __half* dC = ... // cusparseLt data structures and handle initialization cusparseLtHandle_t handle; cusparseLtMatDescriptor_t matA, matB, matC; cusparseLtMatmulDescriptor_t matmul; cusparseLtMatmulAlgSelection_t alg_sel; cusparseLtMatmulPlan_t plan; cudaStream_t stream = nullptr; cusparseLtInit(&handle);
接下来,初始化结构化的稀疏输入矩阵(matrix A),密集输入矩阵(matrix B)和密集输出矩阵(matrix C)描述符。
cusparseLtStructuredDescriptorInit(&handle, &matA, num_A_rows, num_A_cols, lda, alignment, type, order, CUSPARSELT_SPARSITY_50_PERCENT); cusparseLtDenseDescriptorInit(&handle, &matB, num_B_rows, num_B_cols, ldb, alignment, type, order); cusparseLtDenseDescriptorInit(&handle, &matC, num_C_rows, num_C_cols, ldc, alignment, type, order);
准备好描述符后,可以准备矩阵乘法运算的描述符,选择用于执行matmul运算的算法,并初始化matmul计划。
cusparseLtMatmulDescriptorInit(&handle, &matmul, opA, opB, &matA, &matB, &matC, &matC, compute_type); cusparseLtMatmulAlgSelectionInit(&handle, &alg_sel, &matmul, CUSPARSELT_MATMUL_ALG_DEFAULT); int alg = 0; // set algorithm ID cusparseLtMatmulAlgSetAttribute(&handle, &alg_sel, CUSPARSELT_MATMUL_ALG_CONFIG_ID, &alg, sizeof(alg)); size_t workspace_size, compressed_size; cusparseLtMatmulGetWorkspace(&handle, &alg_sel, &workspace_size); cusparseLtMatmulPlanInit(&handle, &plan, &matmul, &alg_sel, workspace_size);
如果稀疏矩阵尚未被其他进程剪枝,则可以在此时进行。不要忘记检查稀疏模式的有效性,以确保可以使用稀疏张量核心来加速它。
cusparseLtSpMMAPrune(&handle, &matmul, dA, dA, CUSPARSELT_PRUNE_SPMMA_TILE, stream); // checking the correctness int is_valid = 0; cusparseLtSpMMAPruneCheck(&handle, &matmul, dA, &is_valid, stream); if (is_valid != 0) { std::printf("!!!! The matrix does not conform to the SpMMA sparsity pattern. " "cusparseLtMatmul does not provide correct results\n"); return EXIT_FAILURE; }
现在已将矩阵A剪枝为2:4稀疏度,可以将其压缩到大约原始大小的一半。与实际的矩阵乘法(小于5%)相比,该步骤的执行时间可以忽略不计。
cusparseLtSpMMACompressedSize(&handle, &plan, &compressed_size); cudaMalloc((void**) &dA_compressed, compressed_size); cusparseLtSpMMACompress(&handle, &plan, dA, dA_compressed, stream);
设置完成后,执行matmul操作。cusparseLtMatmul使用不同的B矩阵可以多次重复调用 。只需设置一次稀疏矩阵。对于A矩阵值更改的用例,cusparseLtSpMMACompress必须再次调用该例程以设置稀疏矩阵的数据结构。
void* d_workspace = nullptr; int num_streams = 0; cudaStream_t* streams = nullptr; cusparseLtMatmul(&handle, &plan, &alpha, dA_compressed, dB, &beta, dC, dD, d_workspace, streams, num_streams) )
最后,通过破坏matmul计划和cuSPARSELt句柄来清理已使用的内存。
cusparseLtMatmulPlanDestroy(&plan); cusparseLtDestroy(&handle);
通过cuSPARSELt库,可以轻松利用NVIDIA Sparse Tensor Core运算,从而在不降低网络准确性的情况下,显着提高了用于深度学习应用程序的矩阵矩阵乘法的性能。该库还提供了用于矩阵压缩,剪枝和性能自动调整的实用程序。简而言之,与普通的密集数学方法相比,cuSPARSELt减少了计算,功耗,执行时间和内存存储。
- 【转】移动Web单页应用开发实践——页面结构化
1. 前言 在开发面向现代智能手机的移动Web应用的时候,无法避免一个事实,就是需要开发单页应用(Single Page WebApp).对于不同的系统需求,单页应用的粒度会不同,可能是整个系统都使用 ...
- 移动Web单页应用开发实践——页面结构化
1. 前言 在开发面向现代智能手机的移动Web应用的时候,无法避免一个事实,就是需要开发单页应用(Single Page WebApp).对于不同的系统需求,单页应用的粒度会不同,可能是整个系统都使用 ...
- Play Framework Web开发教程(33): 结构化页面-组合使用模板
和你编写代码相似,你编写的页面也能够由多个小的片段组合而成,这些小的片段本身也能够由更小的片段构成.这些小片段一般是能够在其他页面反复使用的:有些部分能够用在全部页面,而有些部分是某些页面特定的.本篇 ...
- 第六章 Odoo 12开发之模型 - 结构化应用数据
在本系列文章第三篇Odoo 12 开发之创建第一个 Odoo 应用中,我们概览了创建 Odoo 应用所需的所有组件.本文及接下来的一篇我们将深入到组成应用的每一层:模型层.视图层和业务逻辑层. 本文中 ...
- 【转】自编码算法与稀疏性(AutoEncoder and Sparsity)
目前为止,我们已经讨论了神经网络在有监督学习中的应用.在有监督学习中,训练样本时有类别标签的.现在假设我们只有一个没带类别标签的训练样本集合 ,其中 .自编码神经网络是一种无监督学习算法,它使用了 ...
- [AI开发]基于DeepStream的视频结构化解决方案
视频结构化的定义 利用深度学习技术实时分析视频中有价值的内容,并输出结构化数据.相比数据库中每条结构化数据记录,视频.图片.音频等属于非结构化数据,计算机程序不能直接识别非结构化数据,因此需要先将这些 ...
- .NET Core开发日志——结构化日志
在.NET生态圈中,最早被广泛使用的日志库可能是派生自Java世界里的Apache log4net.而其后来者,莫过于NLog.Nlog与log4net相比,有一项较显著的优势,它支持结构化日志. 结 ...
- CMM模型,结构化开发方法和面向对象开发方法的比较,UML(统一建模语言),jackson开发方法
CMM模型 一.CMM简介 CMM,英文全称为Capability Maturity Model for Software,即:软件成熟度模型. CMM的核心是把软件开发视为一个过程.它是对于软件在定 ...
- [AI开发]视频结构化类应用的局限性
算法不是通用的,基于深度学习的应用系统不但做不到通用,即使对于同一类业务场景,还需要为每个场景做定制.特殊处理,这样才能有可能到达实用标准.这种局限性在计算机视觉领域的应用中表现得尤其突出,本文介绍基 ...
随机推荐
- 看了这篇还不会Linux性能分析和优化,你来打我
前言 一般互联网的项目都是部署在linux服务器上的,如果linux服务器出了问题,那么咱们平时学习的高并发,稳定性之类的是没有任何意义的,所以对linux性能的把握就显得非常重要,当然很多同学可能觉 ...
- C/C++ 实现VA与FOA之间的转换
PE结构中的地址互转,这次再来系统的复习一下关于PE结构中各种地址的转换方式,最终通过编程来实现自动解析计算,最后将这个功能集成到我的迷你解析器中,本章中使用的工具是上次讲解PE结构文章中制作的CMD ...
- LA3971组装电脑
题意: 你有b块钱,想要组装一台电脑,给你提供一些零件,每种零件提供一个或几个,组装电脑的前提是每种零件只能也必须选择一个,每种零件都有自己的种类,名字,价格,还有品质,要求是在能配成电脑 ...
- Python脚本抓取京东手机的配置信息
以下代码是使用python抓取京东小米8手机的配置信息 首先找到小米8商品的链接:https://item.jd.com/7437788.html 然后找到其配置信息的标签,我们找到其配置信息的标签为 ...
- UVA11019KMP(二维矩阵匹配出现次数)
题意: 给你两个矩阵,一个大的一个小的,然后问你这个小矩阵在大的矩阵里出现了多少次? 思路: 说好了AC自动机的,我自己尝试写了个暴力的KMP竟然过了,AC自动机自己的模板还没写完 ...
- Windows PE导出表编程4(重构导出表实现私有函数导出)
本次是尝试调用DLL里面的私有函数. 一: 之前先探索一下,首先可以考虑用偏移量来调用,就是如果知道了某个私有函数和某个导出的公共函数的相对便宜的话,直接加载dll获取公共函数地址,然后自己手动去偏移 ...
- pycharm2019
812LFWMRSH-eyJsaWNlbnNlSWQiOiI4MTJMRldNUlNIIiwibGljZW5zZWVOYW1lIjoi5q2j54mIIOaOiOadgyIsImFzc2lnbmVlT ...
- android手势识别
一.简单手势识别: 简单手势识别分为以下几个步骤: 1.手指触碰屏幕时,触发MotionEvent事件: 2.该事件被OnTouchListener监听,可在它的onTouch()方法中获得该Moti ...
- 检查dtd和Xschema文件限制下的xml文件是否符合的Java文件
先来xml文件: 1 <?xml version="1.0" encoding="utf-8"?> 2 <!DOCTYPE orders SY ...
- 云空调来自 GitHub 的冷气——GitHub 热点速览 v.21.20
作者:HelloGitHub-小鱼干 万物皆可上云,air-conditioner 是上周火爆小鱼干朋友圈和公众号信息流的云空调项目.第一眼的时候,你会觉得和这个云空调还挺别致的,第二眼,si~~感到 ...