
[转帖]Flink完全分布式集群安装
https://zhuanlan.zhihu.com/p/131592261
Flink支持完全分布式模式,这时它由一个master节点和多个worker节点构成。在本节,我们将搭建一个如下的三个节点的Flink集群。
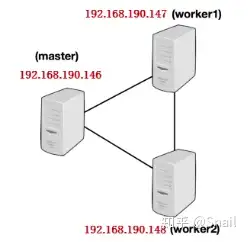
一、Flink集群安装、配置和运行
Flink完全分布式集群搭建步骤如下:
1、配置从master到worker节点的SSH无密登录,并保持保节点上相同的目录结构。
2、Flink要求在主节点和所有工作节点上设置JAVA_HOME环境变量,并指向Java安装的目录。
使用如下命令检查Java的安装和版本信息:
$ java -version3、下载Flink安装包。下载地址:https://flink.apache.org/downloads.html。可以选择任何喜欢的Hadoop/Scala组合。
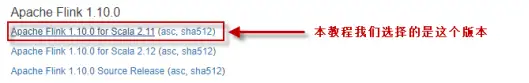
4、将下载的最新版本的Flink压缩包拷贝到master节点的"~/software/"目录下,并解压缩到"~/bigdata/"目录下,步骤如下:
 $ cd ~/bigdata/

 $ tar xzf ~/software/flink-1.10.0-bin-scala_2.11.tgz

 $ cd flink-1.10.0
5、在master节点上配置Flink
所有的配置都在"conf/flink-conf.yaml"文件中。在实际应用中,以下几个配置项是非常重要的:
- jobmanager.heap.mb:每个JobManager的可用内存量,以MB为单位。
- taskmanager.heap.mb:每个TaskManager的可用内存量,以MB为单位。
- taskmanager.numberOfTaskSlots:每台机器上可用的cpu数量,默认为1。
- parallelism.default:集群中cpu的总数。
- io.tmp.dirs:临时目录。
首先用编辑器nano打开该配置文件(你也可以用任何你喜欢的编辑器,如vim,都可以)。
$ nano conf/flink-conf.yaml编辑如下内容(注意,冒号后面一定要有一个空格):
 jobmanager.rpc.address: master   // 指向master节点

 jobmanager.rpc.port: 6123

 jobmanager.heap.size: 1024m      // 定义允许JVM在每个节点上分配的最大主内存量

 taskmanager.memory.process.size: 1024m

 taskmanager.numberOfTaskSlots: 2

 parallelism.default: 1
6、每个节点下的Flink必须保持相同的目录内容。因此将配置好的Flink拷贝到集群中的另外两个节点work01和work02,使用如下的命令:
 $ scp -r ~/bigdata/flink-1.10.0  hduser@worker01:~/bigdata/

 $ scp -r ~/bigdata/flink-1.10.0  hduser@worker02:~/bigdata/
7、最后,必须提供集群中所有用作worker节点的列表。在"conf/slaves"文件中添加每个slave节点信息(IP或hostname均可),每个节点一行,如下所示。每个工作节点稍后将运行一个TaskManager:
 master

 worker01

 worker02
8、启动集群:
$ ./bin/start-cluster.sh这个脚本会在本地节点启动一个JobManager并通过SSH连接到所有的worker节点(在slaves文件中列出的) 以启动每个节点上的TaskManager。注意观察启动过程中的输出信息,如下:
Starting cluster.

Starting standalonesession daemon on host master.

Starting taskexecutor daemon on host master.

Starting taskexecutor daemon on host worker01.

Starting taskexecutor daemon on host worker02.
可以看出,Flink先在master上启动standalonesession进程,然后依次在master、worker01和worker02上启动taskexecutor进程。
启动以后,分别在master、worker01和worker02节点上执行jps命令,查看各节点上的进程是否正常启动了。
二、执行Flink自带的流处理程序-单词计数
1、首先,启动netcat服务器,运行在9000端口:
$ nc -l 90002、在另一个终端,启动Flink示例程序,监听netcat服务器。它将从套接字中读取文本,并每5秒打印前5秒内每个不同单词出现的次数,即处理时间的滚动窗口。
$ ./bin/flink run examples/streaming/SocketWindowWordCount.jar --hostname master --port 90003、回到第一个终端窗口,在正在运行的netcat终端窗口,随意输入一些内容,单词之间用空格分隔,Flink将会处理它。
 good good study

 day day up
4、分别使用ssh登录master、worker01和worker02节点,并执行以下命令,查看日志中的输出:
 $ cd ~/bigdata/flink-1.10.0

 $ tail -f  log/flink-*-taskexecutor-*.out
可以看到如下输出结果:
 good : 2

 study : 1

 day : 2

 up : 1
5、还可以检查Flink Web UI来查看Job是怎样执行的。
打开浏览器,输入地址:http://master:8081 ,可查看检查调度程序的web前端。web前端应该报告有三个可用的TaskManager实例,以及正在执行的作业。Flink WebUI包含许多关于Flink集群及其作业(JobGraph、指标、检查点统计、TaskManager状态等)的有用而有趣的信息。
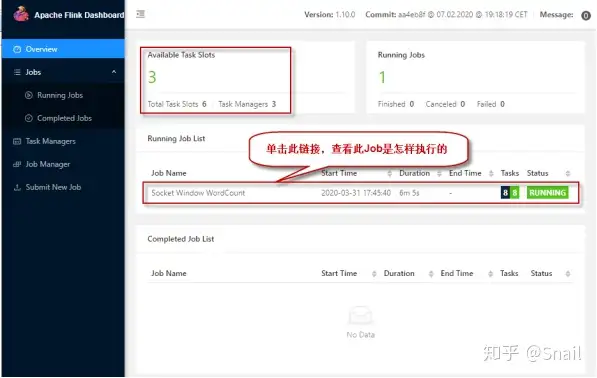
点击正在运行的作业,查看作业运行的详细信息,如下图所示:
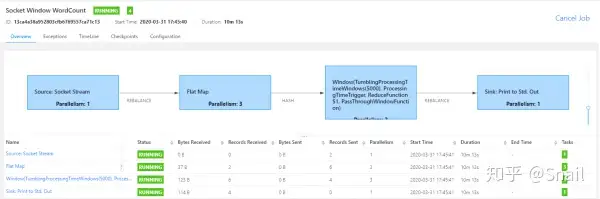
三、运行Flink自带的批处理作业-单词计数
Flink安装包自带了一个以文本文件作为数据源的单词计数程序,位于Flink安装目录下的"example/batch/"子目录下的WordCount.jar包中。
1、可以执行下面的命令来在Flink集群上执行该程序,读取HDFS上的输入数据文件进行处理,并输出计算结果到HDFS上。
注:从flink 1.8开始,Hadoop不再包含在Flink的安装包中,所以需要单独下载并拷贝到Flink的lib目录下。请从Flink官网下载flink-shaded-hadoop2-uber-2.7.5-1.10.0.jar并拷贝到Flink的lib目录下。
$ start-dfs.sh

$ ./bin/flink run ./examples/batch/WordCount.jar

   --input  hdfs://hadoop:8020/wc.txt

--output hdfs://hadoop:8020/result上面的命令是在运行WordCount时读写HDFS中的文件,其中--input参数指定要处理的输入文件,--output指定计算结果输出到的结果文件。(注:如果不加hdfs://前缀,默认使用本地文件系统)
2、执行以下命令查询输出结果:
$ hdfs dfs -cat hdfs://hadoop:8020/result可以看到以下计算结果:
day 2

good 2

study 1

up 1
3、要停止Flink集群,在终端窗口输入以下命令:
$ ./bin/stop-cluster.sh注:
停止单个的Job Manager的命令:
./bin/jobmanager.sh stop cluster停止单个的Task Manager命令:
./bin/taskmanager.sh stop cluster[转帖]Flink完全分布式集群安装的更多相关文章
- hadoop学习之hadoop完全分布式集群安装
注:本文的主要目的是为了记录自己的学习过程,也方便与大家做交流.转载请注明来自: http://blog.csdn.net/ab198604/article/details/8250461 要想深入的 ...
- (转)ZooKeeper伪分布式集群安装及使用
转自:http://blog.fens.me/hadoop-zookeeper-intro/ 前言 ZooKeeper是Hadoop家族的一款高性能的分布式协作的产品.在单机中,系统协作大都是进程级的 ...
- HBase 1.2.6 完全分布式集群安装部署详细过程
Apache HBase 是一个高可靠性.高性能.面向列.可伸缩的分布式存储系统,是NoSQL数据库,基于Google Bigtable思想的开源实现,可在廉价的PC Server上搭建大规模结构化存 ...
- 一张图讲解最少机器搭建FastDFS高可用分布式集群安装说明
很幸运参与零售云快消平台的公有云搭建及孵化项目.零售云快消平台源于零售云家电3C平台私有项目,是与公司业务强耦合的.为了适用于全场景全品类平台,集团要求项目平台化,我们抢先并承担了此任务.并由我来主 ...
- ZooKeeper伪分布式集群安装及使用
ZooKeeper伪分布式集群安装及使用 让Hadoop跑在云端系列文章,介绍了如何整合虚拟化和Hadoop,让Hadoop集群跑在VPS虚拟主机上,通过云向用户提供存储和计算的服务. 现在硬件越来越 ...
- kafka2.9.2的伪分布式集群安装和demo(java api)测试
目录: 一.什么是kafka? 二.kafka的官方网站在哪里? 三.在哪里下载?需要哪些组件的支持? 四.如何安装? 五.FAQ 六.扩展阅读 一.什么是kafka? kafka是LinkedI ...
- ubuntu12.04+kafka2.9.2+zookeeper3.4.5的伪分布式集群安装和demo(java api)测试
博文作者:迦壹 博客地址:http://idoall.org/home.php?mod=space&uid=1&do=blog&id=547 转载声明:可以转载, 但必须以超链 ...
- Spark On YARN 分布式集群安装
一.导读 最近开始学习大数据分析,说到大数据分析,就必须提到Hadoop与Spark.要研究大数据分析,就必须安装这两个软件,特此记录一下安装过程.Hadoop使用V2版本,Hadoop有单机.伪分布 ...
- Hadoop学习---CentOS中hadoop伪分布式集群安装
注意:此次搭建是在ssh无密码配置.jdk环境已经配置好的情况下进行的 可以参考: Hadoop完全分布式安装教程 CentOS环境下搭建hadoop伪分布式集群 1.更改主机名 执行命令:vi / ...
- Linux单机环境下HDFS伪分布式集群安装操作步骤v1.0
公司平台的分布式文件系统基于Hadoop HDFS技术构建,为开发人员学习及后续项目中Hadoop HDFS相关操作提供技术参考特编写此文档.本文档描述了Linux单机环境下Hadoop HDFS伪分 ...
随机推荐
- 面试官:请说一下Mysql事务实现原理
在日常工作中,数据库是我们必须使用的,其中使用最多的也是大部分中小公司的选择是Mysql,跳槽面试中也是必问的,今天我们就说一下Mysql事务 MySQL中的事务实现原理主要涉及以下几个方面: ACI ...
- 直接在*.vue文件(SFC)中使用JSX/TSX渲染函数,真香!
前言 在日常开发中vue的模版语法在大多数情况都能够满足我们的需求,但是在一些复杂的业务场景中使用模版语法就有些麻烦了.这个时候灵活的JSX/TSX渲染函数就能派上用场了,大多数同学的做法都是将*.v ...
- Feign传递参数
传递单个参数 1客户端 @RequestMapping("/one") public BaseResp one(@RequestParam("id") Inte ...
- 3种依赖管理工具实现requirements.txt文件生成
1.pip 实现方式 要使用 pip 生成 requirements.txt 文件,可以使用以下命令: pip freeze > requirements.txt 这个命令会将当前环境中 ...
- react路由权限v6
方法 1.模拟vue的路由拦截(未尝试) 2.进入页面拦截(模拟后台管理系统) route v6常用属性 页面梳理 路由表 公共路由 权限路由 layout(+权限判定) 登录 页面布局 路由表 点击 ...
- 鲲鹏BoostKit虚拟化使能套件,让数据加密更安全
摘要:借助华为鲲鹏BoostKit虚拟化使能套件(简称鲲鹏BoostKit虚拟化),可加速迈向云计算之旅.本次KAE加速引擎让数据加密更安全直播将介绍鲲鹏BoostKit加速库全景,基于BoostKi ...
- OpenFeign 各种用法、 logger 日志记录
<spring-cloud-openfeign.version>2.2.6.RELEASE</spring-cloud-openfeign.version>对应的SpringB ...
- Go--记录下踩map的坑
这两天新调个接口的时候,一直提示签名错误,但所需的时间,工号,token都是对的,完全没有头绪,卡了两天后,终于找到原因了 原因是我的校验信息,是要将时间,工号,token封装在一起成字符串,然后用m ...
- AcWing 第 2 场周赛
比赛链接:Here AcWing 3626. 三元一次方程 暴力即可 void solve() { int n; cin >> n; for (int i = 0; i <= n / ...
- 嵌入式软件工程师笔试面试指南-ARM体系与架构
哈喽,大家好.我终于回来了!19号刚提交完大论文,就被抓去出差了,折腾了整整一周,26号晚上,才回到学校.鸽了好久都没更新干货了.今天更新一篇关于Arm的笔试面试题目,文章内容已同步更新在github ...