
python中的编码与解码
编码与解码
ASCII & UTF-8
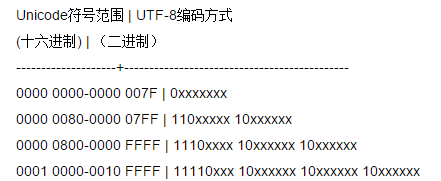
python中的解码和编码
|
1
2
3
|
s = u'严'sprint type(s), s |
第一行定义了一个unicode对象(不是utf8)
|
1
2
3
|
u = s.encode('utf8')uprint type(u),u |
|
1
2
|
t = s.encode('utf8').decode('utf8')t |
第二行会输出u'\u4e25'
文件的编码格式
|
1
2
|
fr = open('encode.py','r')fstr = fr.read() |
参考
python中的编码与解码的更多相关文章
- python中的编码和解码
计算机中常见的编码方式有多种,英文一般是ascii编码,其他有unicode,utf-8,gbk,utf-16等编码. 常见编码方式: ASCII编码:ASCII是早期的编码,包含英文字母.数字和 ...
- Python中的编码和解码问题
关于Python中遇到的中文字符串的读取和输入时总是遇到一堆问题,到现在还不是特别明白,只是有了一个大概率的理解,就是:字符串是用什么编码格式编码的,就用什么编码格式来解码. encode()对字符串 ...
- Python中的编码与解码(转)
Python中的字符编码与解码困扰了我很久了,一直没有认真整理过,这次下静下心来整理了一下我对方面知识的理解. 文章中对有些知识没有做深入的探讨,一是我自己也没有去深入的了解,例如各种编码方案的实现方 ...
- python中base64编码与解码
在python3中用base64进行编码和解码的时候特别注意: 题目要求: 准备一张.jpg图片,比如:mm.jpg,读取图片数据并通过b85encode加密之后写入到新文件mm.txt文件中,然后读 ...
- Python 中 base64 编码与解码
base64 是经常使用的一种加密方式,在 Python 中有专门的库支持. 本文主要介绍在 Python2 和 Python3 中的使用区别: 在 Python2 环境: Python 2.7.16 ...
- python中的编码问题:以ascii和unicode为主线
1.unicode.gbk.gb2312.utf-8的关系 http://www.pythonclub.org/python-basic/encode-detail 这篇文章写的比较好,utf-8 ...
- 【转】【Python】 python中的编码问题报错 'ascii' codec can't decode 及 URL地址获取中文
1.unicode.gbk.gb2312.utf-8的关系 http://www.pythonclub.org/python-basic/encode-detail 这篇文章写的比较好,utf-8是u ...
- python基础系列教程——Python中的编码问题,中文乱码问题
python基础系列教程——Python中的编码问题,中文乱码问题 如果不声明编码,则中文会报错,即使是注释也会报错. # -*- coding: UTF-8 -*- 或者 #coding=utf-8 ...
- 转 python3中SQLLIT编码与解码之Unicode与bytes
#########sample########## sqlite3.OperationalError: Could not decode to UTF-8 column 'logtype' with ...
随机推荐
- VMware12安装虚拟机教程、Ubuntu16.04安装教程(包括vmware tools的安装)
转自https://jingyan.baidu.com/article/c275f6ba07e269e33d756714.html 方法/步骤 1 虚拟机.Linux操作系统介绍及下载地址 虚拟机VM ...
- [Usaco2007 Open]Fliptile 翻格子游戏 状压dp
n,m<=15,直接搞肯定不行,考虑一行一行来, 每一行的状态只与三行有关,所以从第一行开始枚举,每一次让下面一行填上他上面那行的坑 最后一行必须要同时满足他自己和他上面那行,否则舍去 #inc ...
- BZOJ_1132_[POI2008]Tro_计算几何
BZOJ_1132_[POI2008]Tro_计算几何 Description 平面上有N个点. 求出所有以这N个点为顶点的三角形的面积和 N<=3000 Input 第一行给出数字N,N在[3 ...
- maven+springmvc的配置
1. 首先创建1个mavenweb项目 如果没有的话最好是去官网下载一个最新版本的eclipse 里面什么都有 maven/gradle 啥的 2. 选择路径 没啥影响 就是一个路径 默认就行 ...
- 学会python可以上天!20行代码获取斗鱼平台房间数据,就是这么牛逼!
Python(发音:英[?pa?θ?n],美[?pa?θɑ:n]),是一种面向对象.直译式电脑编程语言,也是一种功能强大的通用型语言,已经具有近二十年的发展历史,成熟且稳定.它包含了一组完善而且容易理 ...
- 【SAP HANA】SAP HANA开篇(1)
有幸当前工作能够接触到SAP S/4,能够接触到史上无敌的HANA内存数据库.HANA的技术我就不多讲了,感兴趣的人可以去百度一下.当然,有人想在本机安装HANA来学习,但前提是你得有128G内存以上 ...
- JVM 第一次学习总结(2019年4月)
1.内存模型 起源:在计算机系统,加入了一层读写速度尽可能接近处理器运算速度的高速缓存来作为内存和处理器之间的缓冲. 问题:缓存一致性.在多处理器系统中,每个处理器都有自己的高速缓存(抽象为工作内存) ...
- ReactJs 的各个版本生命周期、API变化 汇总(一、V16.0.0)
目录 一.React 各个版本之间的纵向对比 二.React 的基础 1.Components and Props 三.React V 16.0.0 1. The Component Lifecycl ...
- 打造自己的Android常用知识体系
前言 Android常用知识体系是什么鬼?所谓常用知识体系,就是指对项目中重复使用率较高的功能点进行梳理.注意哦,不是Android知识体系. 古语道:学而不思则罔,思而不学则殆.如果将做项目类比为“ ...
- 从零单排学Redis【铂金二】
前言 只有光头才能变强 好的,今天我们要上[铂金二]了,如果还没有上铂金的,赶紧先去蹭蹭经验再回来(不然不带你上分了): 从零单排学Redis[青铜] 从零单排学Redis[白银] 从零单排学Redi ...