
SQL Server-聚焦过滤索引提高查询性能
前言
这一节我们还是继续讲讲索引知识,前面我们讲了聚集索引、非聚集索引以及覆盖索引等,在这其中还有一个过滤索引,通过索引过滤我们也能提高查询性能,简短的内容,深入的理解,Always to review the basics。
过滤索引,在查询条件上创建非聚集索引(1)
过滤索引是SQL 2008的新特性,被应用在表中的部分行,所以利用过滤索引能够提高查询,相对于全表扫描它能减少索引维护和索引存储的成本。当我们在索引上应用WHERE条件时就是过滤索引。也就是满足如下格式:
CREATE NONCLUSTERED INDEX <index name>

ON <table> (<columns>)

WHERE <criteria>;

GO
下面我们来看一个简单的查询

USE AdventureWorks2012

GO

SELECT SalesOrderDetailID, UnitPrice

FROM Sales.SalesOrderDetail

WHERE UnitPrice > 2000

GO
上述列中未建立任何索引,当然除了SalesOrderDetailID默认创建的聚集索引,这种情况下我们能够猜想到其执行的查询计划必然是主键创建的聚集索引扫描,如下
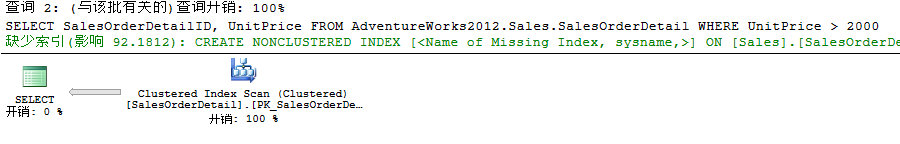
上述我们已经说过此时未在查询条件上创建索引,所以此时必然走的是主键创建的聚集索引,接下来我们首先在UnitPrice列上创建非聚集索引来提高查询性能,
CREATE NONCLUSTERED INDEX idx_SalesOrderDetail_UnitPrice

ON Sales.SalesOrderDetail(UnitPrice)
此时我们再来比较二者查询开销
USE AdventureWorks2012

GO

DBCC FREEPROCCACHE

DBCC DROPCLEANBUFFERS

SELECT SalesOrderDetailID, UnitPrice

FROM AdventureWorks2012.Sales.SalesOrderDetail WITH(INDEX([PK_SalesOrderDetail_SalesOrderID_SalesOrderDetailID]))

WHERE UnitPrice > 2000

GO

SELECT SalesOrderDetailID, UnitPrice

FROM  Sales.SalesOrderDetail WITH(INDEX([idx_SalesOrderDetail_UnitPrice]))

WHERE UnitPrice >
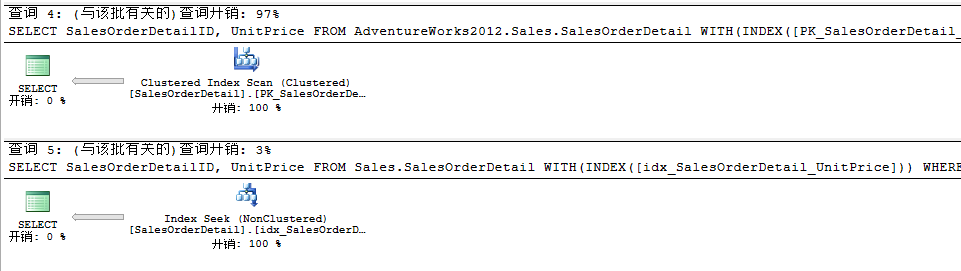
此时在查询条件上建立了非聚集索引之后,查询开销提升的非常明显,提升达到了90%以上,因为非聚集索引也会引用了主键创建的聚集索引,所以这个时候不会导致Bookmark Lookup或者Key Lookup查找。接下来我们我们再添加一个带有条件的非聚集索引即过滤索引
CREATE NONCLUSTERED INDEX idxwhere_SalesOrderDetail_UnitPrice

ON Sales.SalesOrderDetail(UnitPrice)

WHERE UnitPrice >
此时我们再来看看创建了过滤索引之后和之前非聚集索引性能开销差异:
USE AdventureWorks2012

GO

DBCC FREEPROCCACHE

DBCC DROPCLEANBUFFERS

SELECT SalesOrderDetailID, UnitPrice

FROM AdventureWorks2012.Sales.SalesOrderDetail WITH(INDEX([idx_SalesOrderDetail_UnitPrice]))

WHERE UnitPrice > 2000

SELECT SalesOrderDetailID, UnitPrice

FROM  Sales.SalesOrderDetail WITH(INDEX([idxwhere_SalesOrderDetail_UnitPrice]))

WHERE UnitPrice >
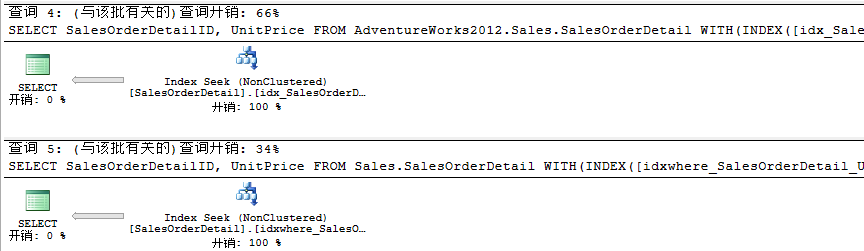
此时我们知道创建的非聚集过滤索引与传统创建的非聚集索引相比,我们的查询接近减少了一半。
唯一过滤索引
唯一过滤索引对于所有列必须唯一且不为空(只允许一个NULL存在)也是非常好的解决方案,所以此时在创建唯一过滤索引时需要将NULL值除外,比如如下:
CREATE UNIQUE NONCLUSTERED INDEX uq_fix_Customers_Email

ON Customers(Email)

WHERE Email IS NOT NULL

GO
过滤索引结合INCLUDE
当我们再添加一个额外列时,使用默认主键创建的聚集索引时,此时会走聚集索引扫描,然后我们在查询条件上创建一个过滤索引,我们强制使用这个过滤索引时,此时由于添加额外列,会导致需要返回到基表中再去获取数据,所以也就造成了Key Lookup查找,如下:
USE AdventureWorks2012

GO

SELECT SalesOrderDetailID, UnitPrice, UnitPriceDiscount

FROM Sales.SalesOrderDetail

WHERE UnitPrice > 2000

GO

此时我们需要用INCLUDE来包含额外列。
CREATE NONCLUSTERED INDEX [idx_SalesOrderDetail_UnitPrice] ON Sales.SalesOrderDetail(UnitPrice) INCLUDE(UnitPriceDiscount)
我们再创建一个过滤索引同时包括额外列
CREATE NONCLUSTERED INDEX [idxwhere_SalesOrderDetail_UnitPrice] ON Sales.SalesOrderDetail(UnitPrice) INCLUDE(UnitPriceDiscount)

WHERE UnitPrice >
接下来再来执行比较添加过滤索引和未添加过滤索引同时都包括了额外列的性能查询差异。
SELECT SalesOrderDetailID, UnitPrice, UnitPriceDiscount

FROM AdventureWorks2012.Sales.SalesOrderDetail WITH(INDEX([idx_SalesOrderDetail_UnitPrice]))

WHERE UnitPrice > 2000

SELECT SalesOrderDetailID, UnitPrice, UnitPriceDiscount

FROM  Sales.SalesOrderDetail WITH(INDEX([idxwhere_SalesOrderDetail_UnitPrice]))

WHERE UnitPrice >

此时性能用INCLUDE来包含额外列性能也得到了一定的改善。
过滤索引,在主键上创建非聚集索引(2)
在第一个案列中,我们可以直接在查询列上创建非聚集索引,因为其类型是数字类型,要是查询条件是字符类型呢?首选现在我们先创建一个测试表
USE TSQL2012

GO

CREATE TABLE dbo.TestData

(

    RowID       integer IDENTITY NOT NULL,

    SomeValue   VARCHAR(max) NOT NULL,

    StartDate   date NOT NULL,

    CONSTRAINT PK_Data_RowID

        PRIMARY KEY CLUSTERED (RowID)

);
添加10万条测试数据
USE TSQL2012

GO

INSERT dbo.TestData WITH (TABLOCKX)

    (SomeValue, StartDate)

SELECT

    CAST(N.n AS VARCHAR(max)) + 'JeffckyWang',

    DATEADD(DAY, (N.n - 1) % 31, '20140101')

FROM dbo.Nums AS N

WHERE

    N.n >= 1

    AND N.n < 100001;
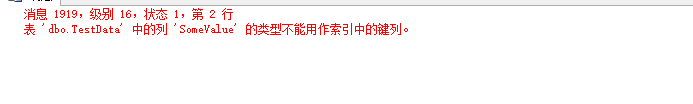
如果我们需要获取表TestData中SomeValue = 'JeffckyWang',此时我们想要在SomeValue上创建一个非聚集索引然后进行过滤,如下
USE TSQL2012

GO

CREATE NONCLUSTERED INDEX idx_noncls_somevalue

ON dbo.TestData(SomeValue)

WHERE SomeValue = 'JeffckyWang'
更新
SQL Server对创建索引大小有限制,最大是900字节,上述直接写的VARCHAR(MAX),所以会出错,切记,切记。
此时我们在主键上创建非聚集索引,我们在主键RowID上创建一个过滤索引且SomeValue = 'JeffckyWang',然后返回数据,如下:
CREATE NONCLUSTERED INDEX idxwhere_noncls_somevalue

ON dbo.TestData(RowID)

WHERE SomeValue = 'JeffckyWang'
下面我们来对比建立过滤索引前后查询计划结果:
USE TSQL2012

GO

SELECT RowID, SomeValue, StartDate

FROM dbo.TestData WITH(INDEX([idx_pk_rowid]))

WHERE SomeValue = 'JeffckyWang'

SELECT RowID, SomeValue, StartDate

FROM dbo.TestData WITH(INDEX([idxwhere_noncls_somevalue]))

WHERE SomeValue = 'JeffckyWang'
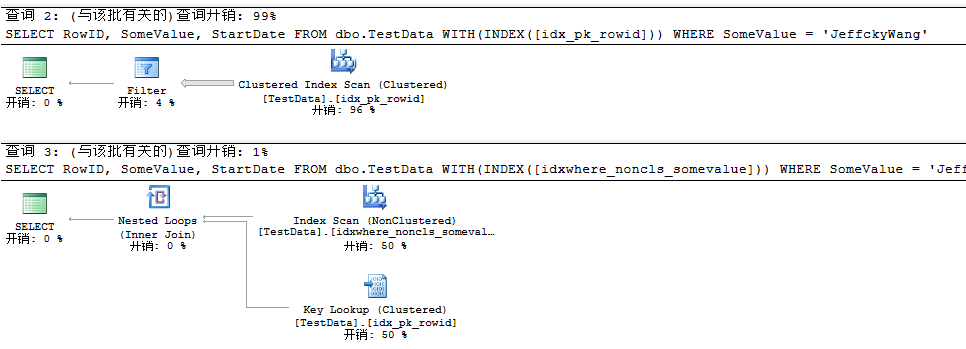
然后结合之前所学,移除Key Lookup,对创建的过滤索引进行INCLUDE。
CREATE NONCLUSTERED INDEX [idxwhere_noncls_somevalue] ON dbo.TestData(RowID) INCLUDE(SomeValue,StartDate)

WHERE SomeValue = 'JeffckyWang'
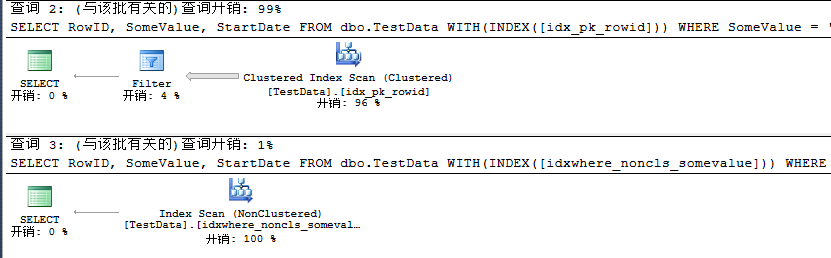
从这里看出,无论是对查询条件创建过滤索引还是对主键创建过滤索引,我们都可以通过结合之前所学来提高查询性能。
我们从开头就一直在讲创建过滤索引,那么创建过滤索引优点的条件到底是什么?
(1)只能通过非聚集索引进行创建。
(2)如果在视图上创建过滤索引,此视图必须是持久化视图。
(3)不能在全文索引上创建过滤索引。
过滤索引的优点
(1)减少索引维护成本:对于增、删、改等操作不会耗费太多的成本,因为一个过滤索引的重建不需要耗时太多时间。
(2)减少存储成本:过滤索引的存储占用空间很小。
(3)更精确的统计:通过在WHERE条件上创建过滤索引比全表统计结果更加精确。
(4)优化查询性能:通过查询计划可以看出其高效性。
讲到这里为止,一直陈述的是过滤索引的好处和优点,已经将其捧上天了,其实其缺点也是显而易见。
过滤索引缺点
最大的缺点则是查询条件的限制。其查询条件仅限于
<filter_predicate> ::=

    <conjunct> [ AND <conjunct> ]

<conjunct> ::=

    <disjunct> | <comparison>

<disjunct> ::=

        column_name IN (constant ,...n)
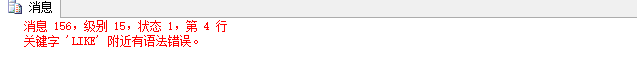
过滤条件仅限于AND、|、IN。比较条件仅限于 { IS | IS NOT | = | <> | != | > | >= | !> | < | <= | !< },所以如下利用LIKE不行
CREATE NONCLUSTERED INDEX [idxwhere_noncls_somevalue] ON dbo.TestData(RowID) INCLUDE(SomeValue,StartDate)

WHERE SomeValue LIKE 'JeffckyWang%'
如下可以
USE AdventureWorks2012

GO

CREATE NONCLUSTERED INDEX idx_SalesOrderDetail_ModifiedDate

ON Sales.SalesOrderDetail(ModifiedDate)

WHERE ModifiedDate >= '2008-01-01' AND ModifiedDate <= '2008-01-07'

GO
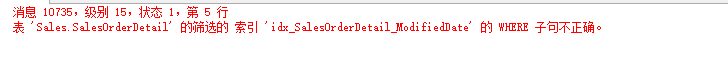
如下却不行
CREATE NONCLUSTERED INDEX idx_SalesOrderDetail_ModifiedDate

ON Sales.SalesOrderDetail(ModifiedDate)

WHERE ModifiedDate = GETDATE()

GO
变量对过滤索引影响
上述我们创建过滤索引在查询条件上直接定义的字符串,如下:
CREATE NONCLUSTERED INDEX idxwhere_SalesOrderDetail_UnitPrice

ON Sales.SalesOrderDetail(UnitPrice)

WHERE UnitPrice >
如果定义的是变量,利用变量来进行比较会如何呢?首先我们创建一个过滤索引
CREATE NONCLUSTERED INDEX idx_SalesOrderDetail_ProductID

ON Sales.SalesOrderDetail (ProductID)

WHERE ProductID =
利用变量来和查询条件比较,强制使用过滤索引(默认情况下走聚集索引)
USE AdventureWorks2012

GO

DECLARE @ProductID INT

SET @ProductID = 870

SELECT ProductID

FROM Sales.SalesOrderDetail WITH(INDEX([idx_SalesOrderDetail_ProductID]))

WHERE ProductID = @ProductID

查看查询执行计划结果却出错了,此时我们需要添加OPTION重新编译,如下:
USE AdventureWorks2012

GO

DECLARE @ProductID INT

SET @ProductID = 870

SELECT ProductID

FROM Sales.SalesOrderDetail

WHERE ProductID = @ProductID

OPTION(RECOMPILE)
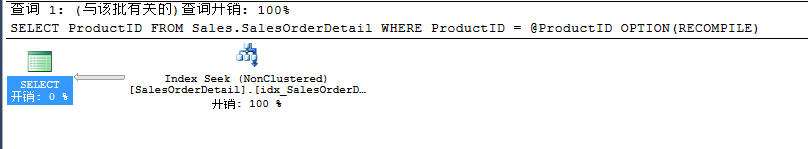
上述利用变量来查询最后通过OPTION重新编译在SQL Server 2012中测试好使,至于其他版本未知,参考资料【The Pains of Filtered Indexes】。
总结
本节我们学习了通过过滤索引来提高查询性能,同时也给出了其不同的场景以及其使用优点和明显的缺点。简短的内容,深入的理解,我们下节再会,good night。
SQL Server-聚焦过滤索引提高查询性能的更多相关文章
- SQL Server-聚焦过滤索引提高查询性能(十)
前言 这一节我们还是继续讲讲索引知识,前面我们讲了聚集索引.非聚集索引以及覆盖索引等,在这其中还有一个过滤索引,通过索引过滤我们也能提高查询性能,简短的内容,深入的理解,Always to revie ...
- SQL Server 百万级数据提高查询速度的方法
1.应尽量避免在 where 子句中使用!=或<>操作符,否则将引擎放弃使用索引而进行全表扫描. 2.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉 ...
- SQL Server 百万级数据提高查询速度的方法(转)
1.应尽量避免在 where 子句中使用!=或<>操作符,否则将引擎放弃使用索引而进行全表扫描.2.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及 ...
- T-SQL查询高级--理解SQL SERVER中非聚集索引的覆盖,连接,交叉和过滤
写在前面:这是第一篇T-SQL查询高级系列文章.但是T-SQL查询进阶系列还远远没有写完.这个主题放到高级我想是因为这个主题需要一些进阶的知识作为基础..如果文章中有错误的地方请不吝指正.本篇文章 ...
- 【SQL Server性能优化】运用SQL Server的全文检索来提高模糊匹配的效率
原文:[SQL Server性能优化]运用SQL Server的全文检索来提高模糊匹配的效率 今天去面试,这个公司的业务需要模糊查询数据,之前他们通过mongodb来存储数据,但他们说会有丢数据的问题 ...
- SQL Server优化技巧——如何避免查询条件OR引起的性能问题
原文:SQL Server优化技巧--如何避免查询条件OR引起的性能问题 之前写过一篇博客"SQL SERVER中关于OR会导致索引扫描或全表扫描的浅析",里面介绍了OR可能会引起 ...
- SQL Server 列存储索引强化
SQL Server 列存储索引强化 SQL Server 列存储索引强化 1. 概述 2.背景 2.1 索引存储 2.2 缓存和I/O 2.3 Batch处理方式 3 聚集索引 3.1 提高索引创建 ...
- SQL查询优化:详解SQL Server非聚集索引(转载)
本文是转载,原文地址 http://tech.it168.com/a2011/1228/1295/000001295176.shtml 在SQL SERVER中,非聚集索引其实可以看作是一个含有聚集索 ...
- SQL Server 列存储索引 第二篇:设计
列存储索引可以是聚集的,也可以是非聚集的,用户可以在表上创建聚集的列存储索引(Clustered Columnstore Index)或非聚集的列存储索引(Nonclustered Columnsto ...
随机推荐
- eoLinker上线两周年+ AMS V4.0 发布:全新UI界面,带来领先的API开发管理解决方案!
2018年7月,eoLinker 发布了<eoLinker AMS 2018年年中用户调研问卷>,前后经历一周的时间,共收集到超过1000份有效调查问卷.超过300个有效改进意见. eoL ...
- eas之EAS手工打包及快速部署工具
EAS手工打包及快速部署工具:jar包的命名是项目名就好了. 1. 在eas的工作空间下:E:\Easworkspace\Project_0 有classes和deployed_metas这两个文 ...
- [Ynoi2011]D2T1
题目大意: 给定一个数列$a$,有以下几种询问: 1. 给定$x$,在序列末尾插入$x$.2. 给定$l,r$,输出$\sum\limits_{i=l}^r a_i$.3. 给定$x$,将数列中的所有 ...
- [LeetCode] 20. 有效的括号 (栈)
思路: 首先用字典将三对括号存储,遍历字符串中每个字符,遇到左括号就入栈:遇到右括号就开始判断:是否与栈弹出的顶字符相同. 如果到最后栈被清空,说明全部匹配上了,为真. class Solution( ...
- 第一个GTK程序
/*我已经把代码写在此处 希望借鉴和完善!一起加油奥(PS:我的QQ是1693672542欢迎加我一起进行探讨学习奥!!!)*/#include <stdio.h>#include< ...
- Java开发编码规范
第一章 代码开发规范及其指南 一.1 目的 定义这个规范的目的是让项目中所有的文档都看起来像一个人写的,增加可读性,减少项目组中因为换人而带来的损失.(这些规范并不是一定要绝对遵守,但是一定要让程序有 ...
- 修改oracle客户端的字符集
客户端字符集环境select * from nls_instance_parameters,其来源于v$parameter, 表示客户端的字符集的设置,可能是参数文件,环境变量或者是注册表 方法有 : ...
- win10使用WampServer部署magento
1.安装wampserver及php.apache.mySQL组件,访问http://www.wampserver.com/en/#download-wrapper,下载以下文件并依次安装: ...
- root用户不能改动iptables
需求:因为防火墙做了IP和port限制,如今须要加入一条规则使之能够訪问指定的IP和port. vi /etc/sysconfig/iptables, 加入完毕后,wq保存,提示文件仅仅读无法保存.! ...
- Unity3D 射线指定层获取GameObject 注意 LayerMask
这一篇是纯技术讨论,看过我前面文章的童鞋应该清楚,我的奔跑是靠鼠标响应的,鼠标点到哪就跑到哪,后来又有了界面,麻烦就来了,我的界面居然能点 穿.我不希望点界面的时候还能点到界面后面的地面上,角色傻不拉 ...