
<转>如何用C++实现自动微分
转摘链接:https://www.zhihu.com/question/48356514/answer/123290631
来源:知乎
著作权归作者所有。
实现 AD 有两种方式,函数重载与代码生成。两种方式的原理都一样,链式法则。
不难想象,任何计算都可以由第1步到第k步的序列形式,其中第 i 步计算的输入,在之前的 i-1 步中已经计算(例如编译器生成的汇编指令序列)。因此,任何计算都可以看作形式如下图左侧的复合函数。微积分中的链式法则告诉我们,符合函数的导数可写作下图右侧的形式(假设每一步都可导)。请注意偏导数和全导数的区别。
图一
&amp;amp;lt;img src="https://pic4.zhimg.com/7152be19b866948c071caeabb32aa69b_b.png" data-rawwidth="817" data-rawheight="424" class="origin_image zh-lightbox-thumb" width="817" data-original="https://pic4.zhimg.com/7152be19b866948c071caeabb32aa69b_r.png"&amp;amp;gt;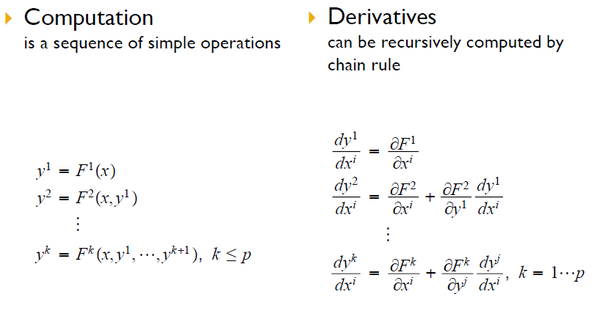
自动微分的第一个难点就在这,微积分中的链式法则。大家在课堂上学的链式法则的示例通常只有两到三个函数,而自动微分面对的计算,有无数个函数。许多人不习惯在这样大的规模上应用链式法则。不过一旦习惯,就会发现自动微分的原理十分简单。
如果上述内容过于抽象,请参看下面这个例子以后再看一遍。
图二
&amp;amp;lt;img src="https://pic4.zhimg.com/67efe239a248c8ca69ba71995d74c123_b.png" data-rawwidth="720" data-rawheight="506" class="origin_image zh-lightbox-thumb" width="720" data-original="https://pic4.zhimg.com/67efe239a248c8ca69ba71995d74c123_r.png"&amp;amp;gt;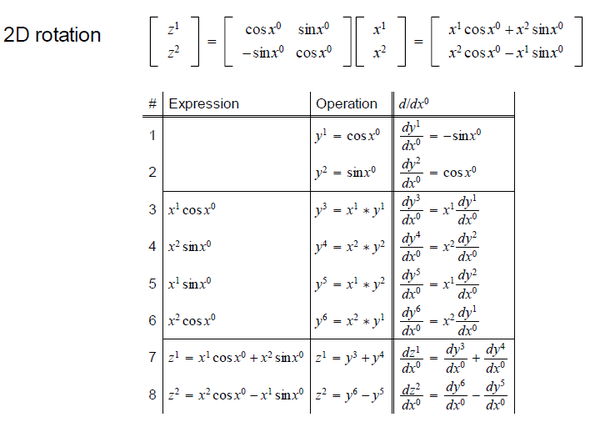
在上图中,顶部方程是二维旋转。输入 有三个变量,旋转角度及二维坐标。输出
有两个变量,即旋转后的二维坐标。上图列表第二列是该计算的序列形式,第一列是每一步对应的表达式,第三列是对应的链式法则(请对比图一)。
太繁琐了?看不出个所以然?不用担心。
如果把计算的序列形式及其导数计算每个步骤的依赖关系表示成图
图三
&amp;amp;lt;img src="https://pic3.zhimg.com/1d4a6263a53516e6daa84823e90f48f6_b.png" data-rawwidth="819" data-rawheight="436" class="origin_image zh-lightbox-thumb" width="819" data-original="https://pic3.zhimg.com/1d4a6263a53516e6daa84823e90f48f6_r.png"&amp;amp;gt;不难发现,两张图是等价的。也就是说,计算序列形式的每一步都与其导数计算的步骤有一一对应的关系。源程序怎么算,其导数就可以怎么算(从顺序上来说)。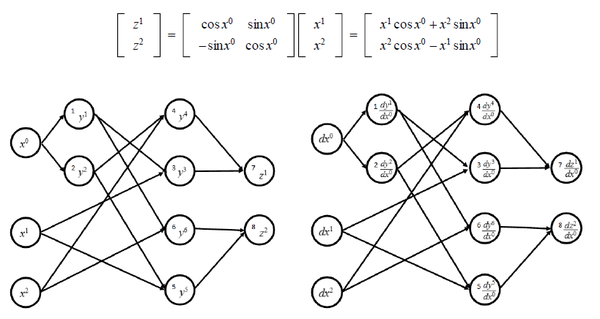
不难发现,两张图是等价的。也就是说,计算序列形式的每一步都与其导数计算的步骤有一一对应的关系。源程序怎么算,其导数就可以怎么算(从顺序上来说)。
以上便是自动微分的基本原理。下面我们来谈实现。
如图二,图三,我们有两种方式来考虑自动微分的实现。
- 用户提供图二第二列序列形式的源代码,按顺序生成第三列的微分计算。此种方法的特点是,读一行源代码,生成一行微分计算,因此可以动态生成。
若源代码这一行在做乘法,那么就依据乘法法则生成该步的微分计算。若源代码这一行是三角函数 cos(x),那么它对应的微分计算就是 -sin(x),以此类推。每一步计算的偏导数都根据链式法则组合,得出该步骤的全导数。
该种方法的常见手段是函数重载。优点是简单直接,缺点是动态生成成本较高。 - 用户提供源代码,在编译时生成图三左侧的程序结构图,并生成图三右侧对应的微分程序。
该种方法的常见手段是编译时的代码生成(比如用 flex-bison 做词法、语法分析)。优点是静态生成效率高,一次生成,多次使用。缺点是编译原理有门槛,非计算机专业望而却步。
力求简单,下面给出以函数重载实现的简单示例 SAD - Simple Automatic Differentiation。请对照图二中的列表阅读。
main 函数中对应图二表中第二列,2D 旋转的计算。ADV 里重载的 +, -, *, sin, cos 不仅完成本来的计算,还负责图二表中第三列导数的计算。
main 函数中 x, y, z 的序号都与图二中对应。
 #include <cmath>

 #include <vector>

 #include <iostream>

 namespace SAD  // Simple Automatic Differentiation

 {

     class ADV

     {

     public:

         ADV(double v = , double d = );

         // overloaded unary and binary operators

         ADV operator + (const ADV &x) const;

         ADV operator - (const ADV &x) const;

         ADV operator * (const ADV &x) const;

         friend ADV sin(const ADV &x);

         friend ADV cos(const ADV &x);

         double val;  // value of the variable

         double dval;  // derivative of the variable

     };

     ADV::ADV(double v, double d) : val(v), dval(d) {}

     ADV ADV::operator+(const ADV &x) const

     {

         ADV y;

         y.val = val + x.val;

         y.dval = dval + x.dval;

         return y;

     }

     ADV ADV::operator-(const ADV &x) const

     {

         ADV y;

         y.val = val - x.val;

         y.dval = dval - x.dval; // sum rule

         return y;

     }

     ADV ADV::operator*(const ADV &x) const

     {

         ADV y;

         y.val = val*x.val;

         y.dval = x.val*dval + val*x.dval; // product rule

         return y;

     }

     ADV sin(const ADV &x)

     {

         ADV y;

         y.val = std::sin(x.val);

         y.dval = std::cos(x.val)*x.dval; // chain rule

         return y;

     }

     ADV cos(const ADV &x)

     {

         ADV y;

         y.val = std::cos(x.val);

         y.dval = -std::sin(x.val)*x.dval; // chain rule

         return y;

     }

 }

 int main()

 {

     using namespace SAD;

     using namespace std;

     static const double PI = 3.1415926;

     vector<ADV> x;

     x.emplace_back(PI, );  // x = [PI, 2, 1]

     x.emplace_back(, );

     x.emplace_back(, );

     ADV y1 = cos(x[]);

     ADV y2 = sin(x[]);

     ADV y3 = x[] * y1;

     ADV y4 = x[] * y2;

     ADV y5 = x[] * y2;

     ADV y6 = x[] * y1;

     ADV z1 = y3 + y4;

     ADV z2 = y6 - y5;

     cout << "x = [" << x[].val << ", " << x[].val << ", " << x[].val << "]" << endl;

     cout << "z = [" << z1.val << ", " << z2.val << "]" << endl;

     cout << "[dz1/dx0, dz2/dx0] = [" << z1.dval << "," << z2.dval << "]" << endl;

 }
运行结果:
&amp;amp;lt;img src="https://pic3.zhimg.com/b25e13c3f8b3204d184ebae299df35b2_b.png" data-rawwidth="256" data-rawheight="59" class="content_image" width="256"&amp;amp;gt;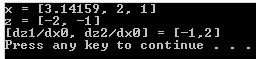
矢量 [2,1] 被旋转 180° , 变为 [-2,-1]。关于角度的导数为 [-1,2]。
自动微分的经典教材是该题目的奠基人 Griewank 著的 Evaluating Derivatives
(Society for Industrial and Applied Mathematics)
该书囊括了自动微分的所有方面,比如本文未介绍的 reverse mode, sparse Jacobian, Hessian 等。
如果不求全面,一本更通俗更面向代码实现的书是 The Art of Differentiating Computer Programs
(Society for Industrial and Applied Mathematics)
最后,自动微分是算导数的最优方法,比符号计算、有限微分更快更精确。
自动微分已经广泛应用在优化领域,包括人工神经网络的训练算法 back-propagation。
要解连续优化或非线性方程,自动微分是不二的选择。
几何福利(自动微分的张量推导)
刚才是科普,下面给出自动微分的张量公式,及其对应的,便于编程实现的矩阵公式。
图一的计算序列可以记作如下形式
其中是自变量
是中间变量
是因变量 他们可以是任意维度
微分流形上的矢量有两种:切空间 (Tangent space)的矢量,对偶空间 (Dual space)的矢量。
其中切空间的基 是关于坐标系的偏导算符
对偶空间的基是关于坐标系的微分
从切矢量出发 我们可以得到自动微分的正序模式 (forward mode)
从对偶矢量出发 我们可以得到自动微分的逆序模式 (reverse mode)
任意切矢量 的定义是其对应的方向导数算符
将它依次应用在计算序列的左边 便可获得下图左侧的张量公式
对张量缩并可得上图右侧的矩阵公式 其中 便是一阶导 Jacobian 矩阵
这种计算导数的方式与计算序列同序 故名正序模式
每一个方向导数的计算复杂度与计算序列相同 空间复杂度也相同
注意 若计算序列的自变量有 n 维 则获得 Jacobian 矩阵需要计算 n 个方向上的方向导数
任意对偶矢量 的定义是其对应方向的微分
对该矢量做关于坐标基 的坐标变换 便可获得下图左侧的张量公式
对涨量缩并可得上图右侧的矩阵公式 其中 D += TP 表示叠加 D = D + TP 便是关于
的一阶导
这种计算导数的方式与计算序列逆序 故名逆序模式
展开每一个基底 的计算复杂度与计算序列相同 但由于内存访问的顺序与计算序列相逆 所有中间结果都需要保存下来 因而空间复杂度与计算复杂度相当
若计算序列的因变量有 m 维 则获得 Jacobian 矩阵需要展开 m 个基底
<转>如何用C++实现自动微分的更多相关文章
- MindSpore多元自动微分
技术背景 当前主流的深度学习框架,除了能够便捷高效的搭建机器学习的模型之外,其自动并行和自动微分等功能还为其他领域的科学计算带来了模式的变革.本文我们将探索如何用MindSpore去实现一个多维的自动 ...
- 附录D——自动微分(Autodiff)
本文介绍了五种微分方式,最后两种才是自动微分. 前两种方法求出了原函数对应的导函数,后三种方法只是求出了某一点的导数. 假设原函数是$f(x,y) = x^2y + y +2$,需要求其偏导数$\fr ...
- pytorch学习-AUTOGRAD: AUTOMATIC DIFFERENTIATION自动微分
参考:https://pytorch.org/tutorials/beginner/blitz/autograd_tutorial.html#sphx-glr-beginner-blitz-autog ...
- 自动微分(AD)学习笔记
1.自动微分(AD) 作者:李济深链接:https://www.zhihu.com/question/48356514/answer/125175491来源:知乎著作权归作者所有.商业转载请联系作者获 ...
- (转)自动微分(Automatic Differentiation)简介——tensorflow核心原理
现代深度学习系统中(比如MXNet, TensorFlow等)都用到了一种技术——自动微分.在此之前,机器学习社区中很少发挥这个利器,一般都是用Backpropagation进行梯度求解,然后进行SG ...
- PyTorch自动微分基本原理
序言:在训练一个神经网络时,梯度的计算是一个关键的步骤,它为神经网络的优化提供了关键数据.但是在面临复杂神经网络的时候导数的计算就成为一个难题,要求人们解出复杂.高维的方程是不现实的.这就是自动微分出 ...
- 【tensorflow2.0】自动微分机制
神经网络通常依赖反向传播求梯度来更新网络参数,求梯度过程通常是一件非常复杂而容易出错的事情. 而深度学习框架可以帮助我们自动地完成这种求梯度运算. Tensorflow一般使用梯度磁带tf.Gradi ...
- PyTorch 自动微分示例
PyTorch 自动微分示例 autograd 包是 PyTorch 中所有神经网络的核心.首先简要地介绍,然后训练第一个神经网络.autograd 软件包为 Tensors 上的所有算子提供自动微分 ...
- PyTorch 自动微分
PyTorch 自动微分 autograd 包是 PyTorch 中所有神经网络的核心.首先简要地介绍,然后将会去训练的第一个神经网络.该 autograd 软件包为 Tensors 上的所有操作提供 ...
随机推荐
- org.apache.ibatis.binding.BindingException: Invalid bound statement
idea中出现了这个问题 我的解决方案是: 把mapper映射文件放到资源目录下 然后就行了. 当然,这个具体原因就是:mapper.xml和接口对不上引起的,具体问题还要具体解决 协助博客:http ...
- influxDB 0.9 C# 读写类
influxDB 0.9 C# 读写类 目前influxdb官网推荐的C#读写类是针对0.8版本的,截至本文写作之前,尚未发现有针对0.9的读写类. 我使用influxdb的是用于保存服务器的运行 ...
- url参数的转码和解码
encodeURI(str) //转码 decodeURI(str)//解码
- uoj #14.【UER #1】DZY Loves Graph
http://uoj.ac/problem/14 由于加入的边权递增,可以直接运行kruskal并支持撤销,但这样如果反复批量删边和撤销,时间复杂度会退化,因此需要对删边操作加上延时处理,只有在删边后 ...
- Java NIO系列教程(十一) Pipe
Java NIO 管道是2个线程之间的单向数据连接.Pipe有一个source通道和一个sink通道.数据会被写到sink通道,从source通道读取. 这里是Pipe原理的图示: 创建管道 通过Pi ...
- Java-Runoob-高级教程-实例-数组:14. Java 实例 – 在数组中查找指定元素
ylbtech-Java-Runoob-高级教程-实例-数组:14. Java 实例 – 在数组中查找指定元素 1.返回顶部 1. Java 实例 - 在数组中查找指定元素 Java 实例 以下实例 ...
- 学习笔记之Data analysis
Data analysis - Wikipedia https://en.wikipedia.org/wiki/Data_analysis Data analysis is a process of ...
- 敏捷软件开发——第8章 SRP:单一职责原则
第8章 SRP:单一职责原则 一个类应该只有一个发生变化的原因. 8.1 定义职责 在SRP中我们把职责定义为变化的原因.如果你想到多于一个的动机去改变一个类,那么这个类就具有多于一个的职责.同时,我 ...
- Redis禁用持久化功能的设置
原文转载至:https://www.cnblogs.com/rangeon/p/7067618.html 用过Redis的朋友都知道,这玩意有个比较强大的功能叫做持久化,就是在结束服务的时候把缓存中的 ...
- Android ImageView点击效果
ImageView设置点击效果需要注意两点,第一个设置android:clickable="true",第二个 <item android:drawable="@d ...