
STL测试3)优先级队列实现二叉堆
用法:
big_heap.empty();判断堆是否为空
big_heap.pop();弹出栈顶元素最大值
big_heap.push(x);将x添加到最大堆
big_heap.top();返回栈顶元素;
big_heap.size();返回堆中元素个数
简单的应用
#include<stdio.h>

#include<queue>

#include<vector>

#include<functional>

using namespace std;

int main()

{

priority_queue <int> big_heap;//默认构造是最大堆

priority_queue<int, vector<int>, greater<int> > small_heap;//最小堆

priority_queue<int, vector<int>, less<int> > big_heap2;//最大堆

if(big_heap.empty())

{

    printf("big_heap is empty\n");

}

int test[]={,,,,,,};

for(int i=;i< ;i++)

{

    big_heap.push(test[i]);

    small_heap.push(test[i]);

    printf("input %d,big_heap top is %d ,small_heap top is%d\n",test[i],big_heap.top(),small_heap.top());

}

big_heap.push();

small_heap.push();

printf("now big_heap top is %d\nnow small_heap top is %d\n",big_heap.top(),small_heap.top());

for(int i=;i<;i++)

{

    big_heap.pop();

    small_heap.pop();

}

printf("now heap has %d num,the max is %d,the min is%d\n",big_heap.size(),big_heap.top(),small_heap.top());

return ;

}
下面来一个简单的应用
在未排序的数组中找到第 k 个最大的元素。请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。
示例 1:
输入: [3,2,1,5,6,4] 和 k = 2
输出: 5
示例 2:
输入: [3,2,3,1,2,4,5,5,6] 和 k = 4
输出: 4
说明:
你可以假设 k 总是有效的,且 1 ≤ k ≤ 数组的长度。
来源:力扣(LeetCode)
链接:https://leetcode-cn.com/problems/kth-largest-element-in-an-array
著作权归领扣网络所有。商业转载请联系官方授权,非商业转载请注明出处。
思路:
维护一个K大小的最小堆,如果堆中栈顶的元素<k,直接入堆;此外情况如果堆顶的元素小于新元素的时候,弹出堆顶,将新元素入堆。
这样保证堆外的元素都是比堆顶小的,不然会把该元素和堆顶的元素置换,这样保证最后堆里存的是k个最大的元素,且堆顶是这k个元素里最小的。那么堆顶倒数第k小的就是第k大的了。
代码写在下面。
下面是一个利用最大堆和最小堆求中位数的问题。
中位数是有序列表中间的数。如果列表长度是偶数,中位数则是中间两个数的平均值。
例如,
[2,3,4] 的中位数是 3
[2,3] 的中位数是 (2 + 3) / 2 = 2.5
设计一个支持以下两种操作的数据结构:
void addNum(int num) - 从数据流中添加一个整数到数据结构中。
double findMedian() - 返回目前所有元素的中位数。
示例:
addNum(1)
addNum(2)
findMedian() -> 1.5
addNum(3)
findMedian() -> 2
进阶:
如果数据流中所有整数都在 0 到 100 范围内,你将如何优化你的算法?
如果数据流中 99% 的整数都在 0 到 100 范围内,你将如何优化你的算法?
来源:力扣(LeetCode)
链接:https://leetcode-cn.com/problems/find-median-from-data-stream
著作权归领扣网络所有。商业转载请联系官方授权,非商业转载请注明出处。
思路就是设计一个最大堆和最小堆分别存储一般数据,并维持两个堆中最大堆的堆顶比最小堆小。这样如果两个堆大小相同,那么中位数就是两个堆顶的平均值,如果是堆大小不同,那么中位数就是size大的那个堆的堆顶。
看到一个别人画的示意图,非常形象,这里搬过来方便以后理解。
addNum 函数设计
addNum() 函数在添加元素的过程中保持两个堆的动态平衡:
Condition 1.保证两堆元素个数相差不超过 1 |
case 1:
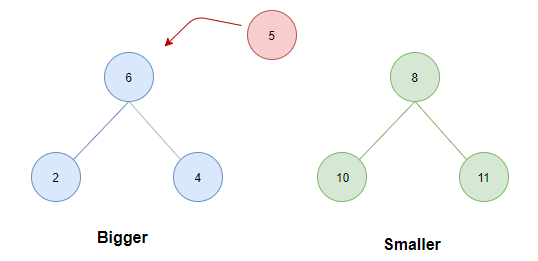
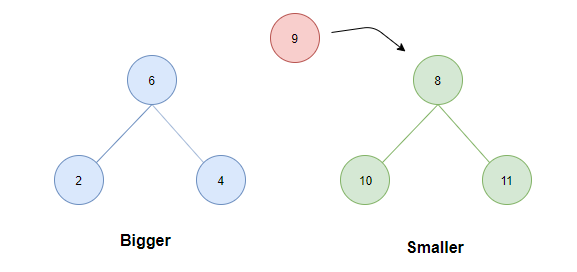
- 如果两堆中的元素个数相同。这个时候无论插入哪一个堆,条件 1 都不会被破坏,因此考虑条件 2 ,将待插入元素与两堆的堆顶比较:若待插入元素为 5,显然这个时候若插入smaller会破坏条件 2,因此因插入bigger中。而若待插入为 9 则显然应插入 smaller 中。
case 2:
- 如果大顶堆元素个数小于小顶堆的元素个数。此时,将待插入元素与两堆堆顶比较:
- 若小于等于Bigger.top则直接插入Bigger中;
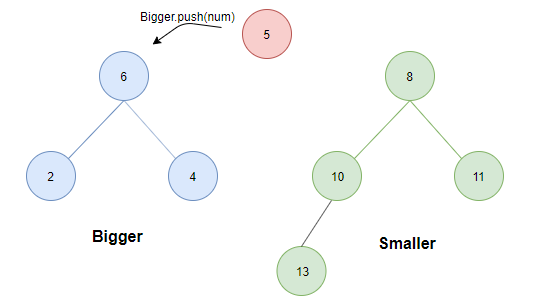
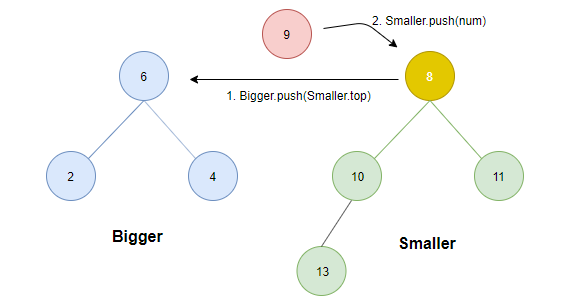
- 若大于smaller.top则为了保证条件1,需将smaller中的最小值(根)转存至Bigger中。
case 3:
- 如果大顶堆的元素个数大于小顶堆的元素个数。此时,将待插入元素与两堆堆顶比较:
- 若其大于等于Smaller.top则直接插入Smaller中;
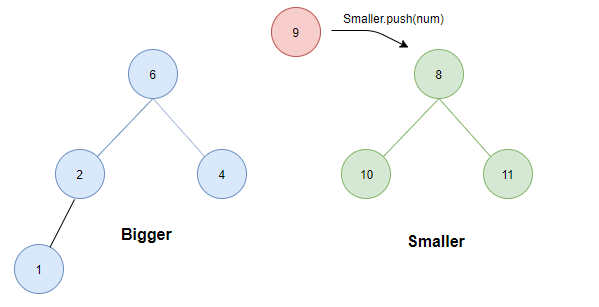
- 若小于Bigger.top则为了保证条件1,需将Bigger中的最大元素值(根)转存至Smaller中。
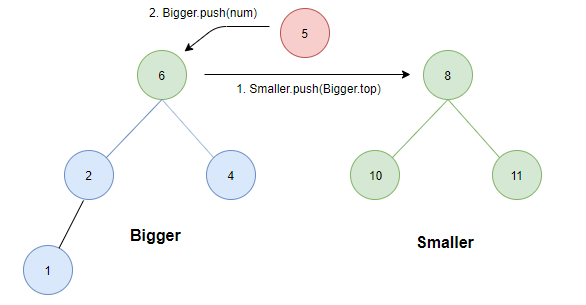
最后是实现以后的代码:
class MedianFinder {

public:

    priority_queue <int> big_queue;

    priority_queue<int, vector <int>, greater <int> > small_queue;

    /** initialize your data structure here. */

    MedianFinder() {

    }

    void addNum(int num) {

        if(big_queue.empty())

        {

            big_queue.push(num);

            return;

        }

        if(big_queue.size() == small_queue.size())

        {

            if(num < big_queue.top())

            {

                big_queue.push(num);

            }

            else

            {

                small_queue.push(num);

            }

        }

        else if(big_queue.size() > small_queue.size())

        {

            if(num > big_queue.top())

            {

                small_queue.push(num);

            }

            else

            {

                small_queue.push(big_queue.top());

                big_queue.pop();

                big_queue.push(num);

            }

        }

        else if(big_queue.size() < small_queue.size())

        {

            if(num < small_queue.top())

            {

                big_queue.push(num);

            }

            else

            {

                big_queue.push(small_queue.top());

                small_queue.pop();

                small_queue.push(num);

            }

        }

    }

    double findMedian() {

        if(big_queue.size() == small_queue.size())

            return ((big_queue.top()+small_queue.top())/2.0);

        else if(big_queue.size() > small_queue.size())

            return big_queue.top();

        else

            return small_queue.top();

    }

};
STL测试3)优先级队列实现二叉堆的更多相关文章
- 【数据结构与算法Python版学习笔记】树——利用二叉堆实现优先级队列
概念 队列有一个重要的变体,叫作优先级队列. 和队列一样,优先级队列从头部移除元素,不过元素的逻辑顺序是由优先级决定的. 优先级最高的元素在最前,优先级最低的元素在最后. 实现优先级队列的经典方法是使 ...
- STL中的优先级队列priority_queue
priority_queue(queue类似)完全以底部容器为根据,再加上二叉堆(大根堆或者小根堆)的实现原理,所以其实现非常简单,缺省情况下priority_queue以vector作为底部容器.另 ...
- 洛谷P2827 [NOIP2016 提高组] 蚯蚓 (二叉堆/队列)
容易想到的是用二叉堆来解决,切断一条蚯蚓,其他的都要加上一个值,不妨用一个表示偏移量的delta. 1.取出最大的x,x+=delta: 2.算出切断后的两个新长度,都减去delta和q: 3.del ...
- 纯数据结构Java实现(6/11)(二叉堆&优先队列)
堆其实也是树结构(或者说基于树结构),一般可以用堆实现优先队列. 二叉堆 堆可以用于实现其他高层数据结构,比如优先队列 而要实现一个堆,可以借助二叉树,其实现称为: 二叉堆 (使用二叉树表示的堆). ...
- Binary Heap(二叉堆) - 堆排序
这篇的主题主要是Heapsort(堆排序),下一篇ADT数据结构随笔再谈谈 - 优先队列(堆). 首先,我们先来了解一点与堆相关的东西.堆可以实现优先队列(Priority Queue),看到队列,我 ...
- 数据结构图文解析之:二叉堆详解及C++模板实现
0. 数据结构图文解析系列 数据结构系列文章 数据结构图文解析之:数组.单链表.双链表介绍及C++模板实现 数据结构图文解析之:栈的简介及C++模板实现 数据结构图文解析之:队列详解与C++模板实现 ...
- 二叉堆(binary heap)
堆(heap) 亦被称为:优先队列(priority queue),是计算机科学中一类特殊的数据结构的统称.堆通常是一个可以被看做一棵树的数组对象.在队列中,调度程序反复提取队列中第一个作业并运行,因 ...
- D&F学数据结构系列——二叉堆
二叉堆(binary heap) 二叉堆数据结构是一种数组对象,它可以被视为一棵完全二叉树.同二叉查找树一样,堆也有两个性质,即结构性和堆序性.对于数组中任意位置i上的元素,其左儿子在位置2i上,右儿 ...
- 【算法与数据结构】二叉堆和优先队列 Priority Queue
优先队列的特点 普通队列遵守先进先出(FIFO)的规则,而优先队列虽然也叫队列,规则有所不同: 最大优先队列:优先级最高的元素先出队 最小优先队列:优先级最低的元素先出队 优先队列可以用下面几种数据结 ...
随机推荐
- 一个基于Consul的.NET Leader选举类库
前段时间有传言说Consul将不能在我国继续使用,后被查明是因法律问题Vault企业版产品不能在国内销售.Valut和Consul都是HashiCorp公司的产品,并且都推出了开源版本,继续使用开源版 ...
- 一网打尽枚举操作 .net core
本文介绍如何使用枚举以及,如何将枚举类型更好的应用于项目中,看完本文可以有序的将项目中的枚举更容易的使用到每个角落. 1,分析枚举 /// <summary> /// 性别 /// < ...
- Verifying dml pool data
数据出错 ,硬件变动 解决方案: 1.移除外接设备 2.bios还原
- 关于wifi营销的看过来
亲测可用.对于一个开发者来说,终于如获至宝.详情联系qq2455994690.源码可二开.包括微信一键关注上网,手机验证码上网.
- Apache(httpd)详解
httpd详解(思维导图) 1. httpd服务 ASF 服务器类型 http服务器 应用程序服务器 httpd的特性 高度模块化 DSO机制 MPM httpd的并发响应模型 prefork wor ...
- 使用阿里云K8S 服务,丢失访问中原始IP 问题
解决步骤: 1. 利用kubectl 修改 k8s 配置, 设置 external** = Local 2. 在服务发现与负载均衡界面,选择对应的LB 服务, 设置服务LB 的 external** ...
- 2019-02-13 思考:1000瓶药水,1瓶有毒,老鼠毒发24h,如何用最少的老鼠在24h内找出毒药?
题目: 现在有1000瓶药水,其中一瓶有毒,一只老鼠喝了在24h后会准时死亡,药水无色无味,如何用最少的老鼠在24h内找出毒药? 分析: 时间限制为24h,说明我们只有一次喂老鼠的机会,需要一波找出来 ...
- Jmeter基础003----Jmeter组件之测试计划和线程组
一.测试计划 1.界面展示 测试计划是测试脚本的容器,主要是对测试脚本做总体设置.它定义了测试要执行什么,怎么执行(执行的).其界面如下图所示: 2.设置用户定义变量 在测试计划中定义的变量是在整 ...
- 0.1---selenium+java自动化测试进阶02----项目实战之登录代码重构
一.测试登录功能实现 以慕课网的登录为例,分析登录的功能需求,编写测试用例,找到要定位的元素以及需要的操作,编写登录功能的测试代码.代码实现如下: public static void main(St ...
- laravel查询常用的方式含义.
find($id) 传值并返回一个模型.如果不存在匹配的模型,则返回null.findOrFail($id) 传值并返回一个模型.如果不存在匹配的模型, 它会抛出异常.first() 返回在数据库中找 ...