
sklearn中实现随机梯度下降法(多元线性回归)
sklearn中实现随机梯度下降法
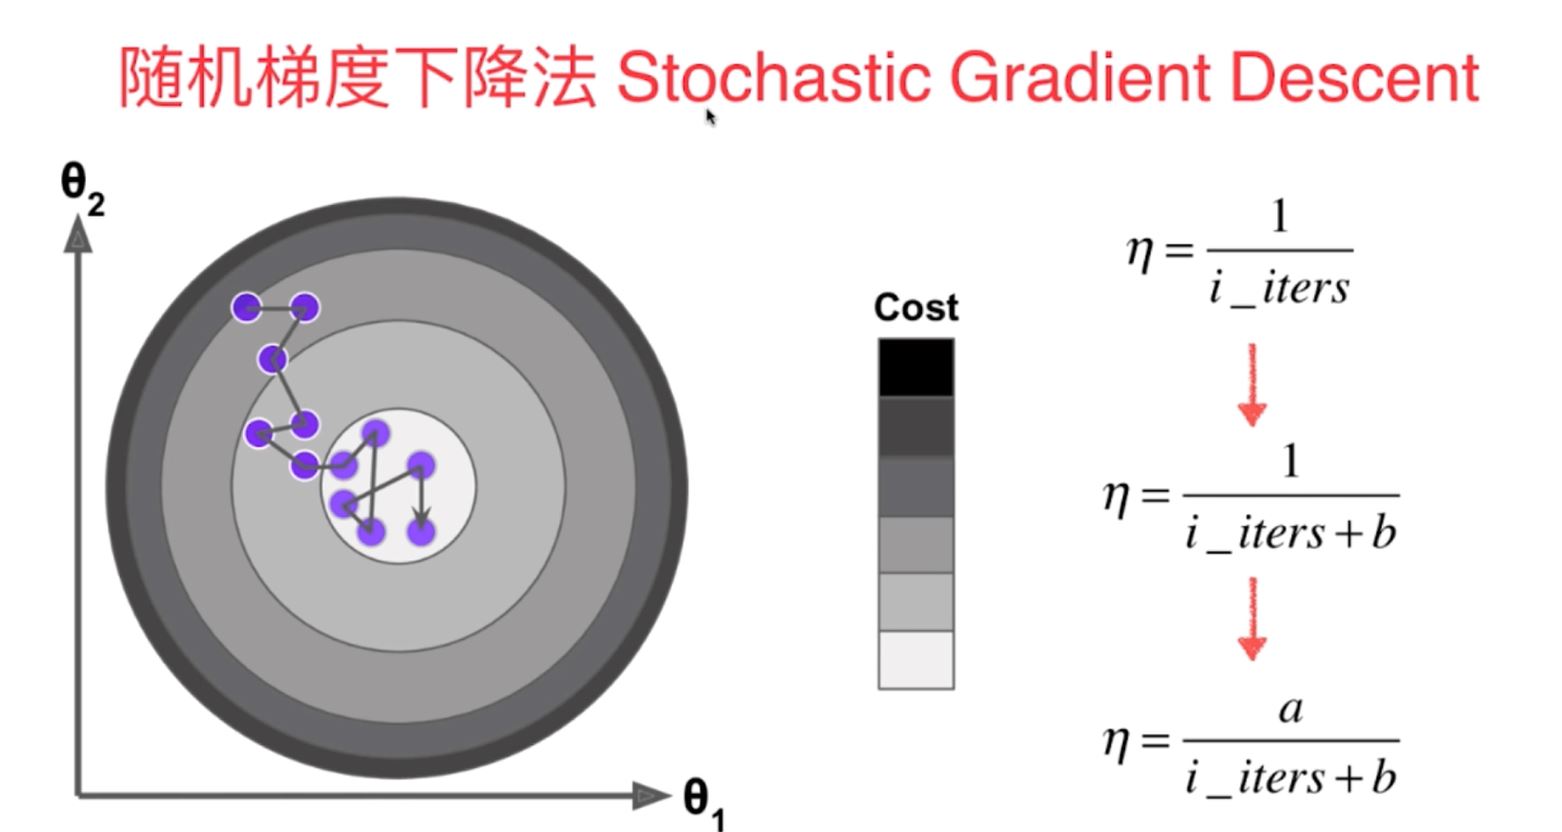
随机梯度下降法是一种根据模拟退火的原理对损失函数进行最小化的一种计算方式,在sklearn中主要用于多元线性回归算法中,是一种比较高效的最优化方法,其中的梯度下降系数(即学习率eta)随着遍历过程的进行在不断地减小。另外,在运用随机梯度下降法之前需要利用sklearn的StandardScaler将数据进行标准化。

#sklearn中实现随机梯度下降多元线性回归
#1-1导入相应的数据模块
import numpy as np
import matplotlib.pyplot as plt
np.random.seed(666)
#1-2导入相应的基础训练数据集
x=np.random.random(size=1000)
y=x*3.0+4+np.random.normal(size=1000)
x=x.reshape(-1,1)
from sklearn import datasets
d=datasets.load_boston()
x=d.data[d.target<50]
y=d.target[d.target<50]
from sklearn.model_selection import train_test_split
x_train1,x_test1,y_train1,y_test1=train_test_split(x,y,random_state=1)
#1-3进行数据的标准化
from sklearn.preprocessing import StandardScaler
stand1=StandardScaler()
stand1.fit(x_train1)
x_train_standard=stand1.transform(x_train1)
x_test_standard=stand1.transform(x_test1)
#1-4导入随机梯度下降法的多元线性回归算法进行数据的训练和预测
from sklearn.linear_model import SGDRegressor
sgd1=SGDRegressor()
sgd1.fit(x_train_standard,y_train1)
print(sgd1.coef_)
print(sgd1.intercept_)
print(sgd1.score(x_test_standard,y_test1))
sgd2=SGDRegressor()
sgd2.fit(x_train1,y_train1)
print(sgd2.coef_)
print(sgd2.intercept_)
print(sgd2.score(x_test1,y_test1))

注解:对于多元回归的随机梯度下降法需要对数据进行向量化和标准化
sklearn中实现随机梯度下降法(多元线性回归)的更多相关文章
- 机器学习---用python实现最小二乘线性回归算法并用随机梯度下降法求解 (Machine Learning Least Squares Linear Regression Application SGD)
在<机器学习---线性回归(Machine Learning Linear Regression)>一文中,我们主要介绍了最小二乘线性回归算法以及简单地介绍了梯度下降法.现在,让我们来实践 ...
- 线性回归(最小二乘法、批量梯度下降法、随机梯度下降法、局部加权线性回归) C++
We turn next to the task of finding a weight vector w which minimizes the chosen function E(w). Beca ...
- 一种利用 Cumulative Penalty 训练 L1 正则 Log-linear 模型的随机梯度下降法
Log-Linear 模型(也叫做最大熵模型)是 NLP 领域中使用最为广泛的模型之一,其训练常采用最大似然准则,且为防止过拟合,往往在目标函数中加入(可以产生稀疏性的) L1 正则.但对于这种带 L ...
- Gradient Descent 和 Stochastic Gradient Descent(随机梯度下降法)
Gradient Descent(Batch Gradient)也就是梯度下降法是一种常用的的寻找局域最小值的方法.其主要思想就是计算当前位置的梯度,取梯度反方向并结合合适步长使其向最小值移动.通过柯 ...
- 谷歌机器学习速成课程---降低损失 (Reducing Loss):随机梯度下降法
在梯度下降法中,批量指的是用于在单次迭代中计算梯度的样本总数.到目前为止,我们一直假定批量是指整个数据集.就 Google 的规模而言,数据集通常包含数十亿甚至数千亿个样本.此外,Google 数据集 ...
- 1. 批量梯度下降法BGD 2. 随机梯度下降法SGD 3. 小批量梯度下降法MBGD
排版也是醉了见原文:http://www.cnblogs.com/maybe2030/p/5089753.html 在应用机器学习算法时,我们通常采用梯度下降法来对采用的算法进行训练.其实,常用的梯度 ...
- 随机梯度下降法(Stochastic gradient descent, SGD)
BGD(Batch gradient descent)批量梯度下降法:每次迭代使用所有的样本(样本量小) Mold 一直在更新 SGD(Stochastic gradientdescent)随机 ...
- Stochastic Gradient Descent 随机梯度下降法-R实现
随机梯度下降法 [转载时请注明来源]:http://www.cnblogs.com/runner-ljt/ Ljt 作为一个初学者,水平有限,欢迎交流指正. 批量梯度下降法在权值更新前对所有样本汇总 ...
- sklearn中的随机森林
阅读了Python的sklearn包中随机森林的代码实现,做了一些笔记. sklearn中的随机森林是基于RandomForestClassifier类实现的,它的原型是 class RandomFo ...
随机推荐
- Nginx禁止使用ip访问,只允许使用域名访问
Nginx虚拟主机配置,vhosts下面有很多域名的配置: [root@external-lb01 vhosts]# pwd/data/nginx/conf/vhosts [root@external ...
- JAVA 常用包
JAVA是以包的形式进行语言结构组织的. 引入这些包的关键词就是 import 下面说说 JAVA常用包有下面的几个 1. java.lang 这个是默认引入的,也是一个最基础的包.其中lang不是中 ...
- Centos610无桌面安装Docker-内核升级
1.查看当前操作系统和系统内核 (此处只需要注意一项centos6的docker源只有64位的,x86_64,32位的直接换系统吧) 查看当前内核版本uname -r 2.6.32-754.el6.x ...
- SpringBoot 集成JUnit
项目太大,不好直接测整个项目,一般都是切割成多个单元,单独测试,即单元测试. 直接在原项目上测试,会把项目改得乱七八糟的,一般是单独写测试代码. 进行单元测试,这就需要集成JUnit. (1)在pom ...
- 信息论相关概念:熵 交叉熵 KL散度 JS散度
目录 机器学习基础--信息论相关概念总结以及理解 1. 信息量(熵) 2. KL散度 3. 交叉熵 4. JS散度 机器学习基础--信息论相关概念总结以及理解 摘要: 熵(entropy).KL 散度 ...
- QT无法读入txt文件内容
用vs写QT无法利用相对路径读入txt文件,应将此文件加入到资源文件中.
- Tachyon---基于内存的分布式存储系统
Tachyon是一个以内存为核心的开源分布式存储系统,也是目前发展最迅速的开源大数据项目之一.Tachyon为不同的大数据计算框架(如Apache Spark,Hadoop MapReduce, Ap ...
- python 基础之字符串方法
字符串 print('chenxi'*8) 测试 D:\python\python.exe D:/untitled/dir/for.py chenxichenxichenxichenxichenxic ...
- js里用 toLocaleString 实现给数字加三位一逗号间隔(有无小数点都适用)
<input type="hidden" id="totalLandArea" value="<%-info.totalLandArea% ...
- Java基础 -1.2
Shell是脚本程序的含义 在很多编程语言中为了方便使用者进行代码的开发 都会有shell交互式编程环境 可能是为了进行一些简短的程序验证 但是在java里面就必须编写很多的结果代码才可以实现 为了解 ...