
Win7+Eclipse+Hadoop2.6.4开发环境搭建
Hadoop开发环境搭建
感谢参考网站:http://www.cnblogs.com/huligong1234/p/4137133.html
一、软件准备
JDK:jdk-7u80-windows-x64.exe
http://www.oracle.com/technetwork/java/javase/archive-139210.html
Eclipse:eclipse-jee-mars-2-win32-x86_64.zip
http://www.eclipse.org/downloads/
Hadoop:hadoop-2.6.4.tar.gz
Hadoop-Src:hadoop-2.6.4-src.tar.gz
http://hadoop.apache.org/releases.html
Ant:apache-ant-1.9.6-bin.zip
http://ant.apache.org/bindownload.cgi
Hadoop-Common:hadoop2.6(x64)V0.2.zip (2.4以后)、(hadoop-common-2.2.0-bin-master.zip)
2.2:https://github.com/srccodes/hadoop-common-2.2.0-bin
2.6:http://download.csdn.net/detail/myamor/8393459
Hadoop-eclipse-plugin:hadoop-eclipse-plugin-2.6.0.jar
https://github.com/winghc/hadoop2x-eclipse-plugin
二、搭建环境
1. 安装JDK
执行“jdk-7u80-windows-x64.exe”,步骤选择默认下一步即可。
2. 配置JDK、Ant、Hadoop环境变量
解压hadoop-2.6.4.tar.gz、apache-ant-1.9.6-bin.zip、hadoop2.6(x64)V0.2.zip、hadoop-2.6.4-src.tar.gz到本地磁盘,位置任意。
配置系统环境变量JAVA_HOME、ANT_HOME、HADOOP_HOME,并将这些环境变量的bin子目录配置到path变量中。
将hadoop2.6(x64)V0.2下的hadoop.dll和winutils.exe复制到HADOOP_HOME/bin目录下。
3. 配置Eclipse
将hadoop-eclipse-plugin-2.6.0.jar复制到eclilpse的plugins目录下。
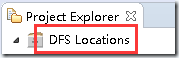
启动eclipse,并设置好workspace。插件安装成功的话,启动之后可以看到如下内容:
4. 配置hadoop
打开“window”-“Preferenes”-“Hadoop Mep/Reduce”,配置到Hadoop_Home目录。
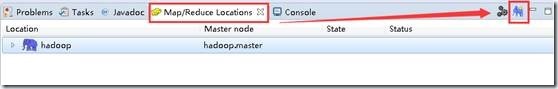
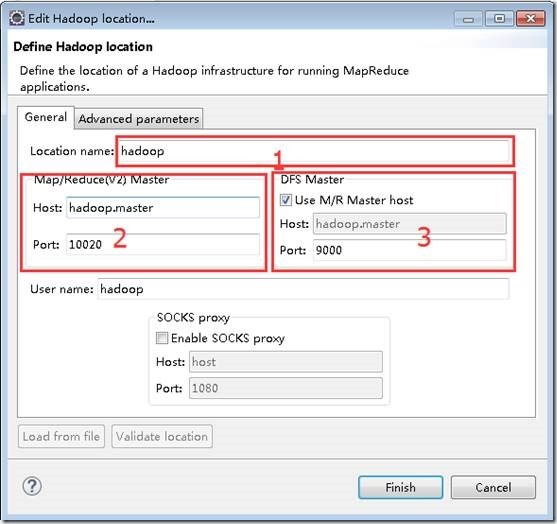
打开“window”-“show view” -“Mepreduce Tools” –“Mep/Reduce Locations”,创建一个Locations,配置如下。
1位置为配置的名称,任意。
2位置为mapred-site.xml文件中的mapreduce.jobhistory.address配置。
3位置为core-site.xml文件中的fs.default.name配置。
配置好以上信息之后,可以在Project Explorer中看到以下内容,即表示配置成功。
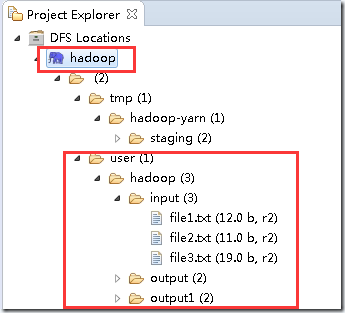
上图表示读取到了配置的hdfs信息,一共有3个文件夹input、output、output1,input目录下有3个文件。
注:以上内容为我自己环境中创建的,你看到的可能跟我的不一样。
内容可以通过在hadoop.master上执行
hadoop fs -mkdir input --创建文件夹
hadoop fs -put $localFilePath input --将本地文件上传到HDFS的input目录下
三、创建示例程序
1. 新建一个WordCount类
打开eclipse,创建一个Map/Reduce Project,并创建一个org.apache.hadoop.examples.WordCount类。
拷贝hadoop-2.6.4-src.tar.gz中hadoop-mapreduce-project\hadoop-mapreduce-examples\src\main\java\org\apache\hadoop\examples下的WordCount.java文件中的内容到新创建的类中。
2. 配置log4j
在src目录下,创建log4j.properties文件
log4j.rootLogger=debug,stdout,R

log4j.appender.stdout=org.apache.log4j.ConsoleAppender

log4j.appender.stdout.layout=org.apache.log4j.PatternLayout

log4j.appender.stdout.layout.ConversionPattern=%5p - %m%n

log4j.appender.R=org.apache.log4j.RollingFileAppender

log4j.appender.R.File=mapreduce_test.log

log4j.appender.R.MaxFileSize=1MB

log4j.appender.R.MaxBackupIndex=1

log4j.appender.R.layout=org.apache.log4j.PatternLayout

log4j.appender.R.layout.ConversionPattern=%p %t %c - %m%

log4j.logger.com.codefutures=DEBUG
3. 配置运行参数
选择“run”-“run configurations”,在“Arguments”里加入“hdfs://hadoop.master:9000/user/hadoop/input hdfs://hadoop.master:9000/user/hadoop/output1”。
格式为“输入路径 输出路径”,如果输出路径必须为空或未创建,否则会报错。
如下图:
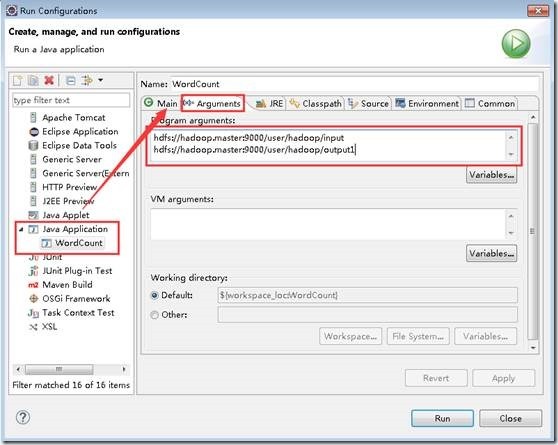
注:如果”Java Application”下面没有“WordCount”,可以选择右键,New一个即可。
4. 执行查看结果
配置好之后,执行。查看控制台输出以下内容,表示执行成功:
|
INFO - Job job_local1914346901_0001 completed successfully INFO - Counters: 38 FILE: Number of bytes read=4109 FILE: Number of bytes written=1029438 FILE: Number of read operations=0 FILE: Number of large read operations=0 FILE: Number of write operations=0 HDFS: Number of bytes read=134 HDFS: Number of bytes written=40 HDFS: Number of read operations=37 HDFS: Number of large read operations=0 HDFS: Number of write operations=6 Map-Reduce Framework Map input records=3 Map output records=7 Map output bytes=70 Map output materialized bytes=102 Input split bytes=354 Combine input records=7 Combine output records=7 Reduce input groups=5 Reduce shuffle bytes=102 Reduce input records=7 Reduce output records=5 Spilled Records=14 Shuffled Maps =3 Failed Shuffles=0 Merged Map outputs=3 GC time elapsed (ms)=21 CPU time spent (ms)=0 Physical memory (bytes) snapshot=0 Virtual memory (bytes) snapshot=0 Total committed heap usage (bytes)=1556611072 Shuffle Errors BAD_ID=0 CONNECTION=0 IO_ERROR=0 WRONG_LENGTH=0 WRONG_MAP=0 WRONG_REDUCE=0 File Input Format Counters Bytes Read=42 File Output Format Counters Bytes Written=40 |
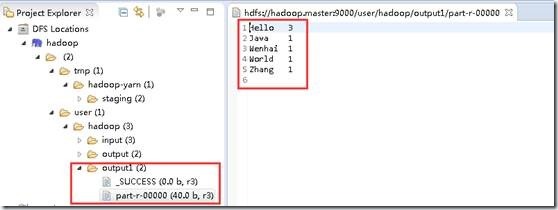
在“DFS Locations”下,刷新刚创建的“hadoop”看到本次任务的输出目录下是否有输出文件。
四、问题FAQ
1. 问题1:NativeCrc32.nativeComputeChunkedSumsByteArray错误
【问题描述】启动示例程序时,报nativeComputeChunkedSumsByteArray异常。控制台日志显示如下:
Exception in thread "main" java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava/lang/String;JZ)V
at org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(Native Method)
【原因分析】hadoop.dll文件版本错误,替换对应的版本文件。由于hadoop.dll 版本问题出现的,这是由于hadoop.dll 版本问题,2.4之前的和自后的需要的不一样,需要选择正确的版本(包括操作系统的版本),并且在 Hadoop/bin和 C:\windows\system32 上将其替换。
【解决措施】下载对应的文件替换即可。http://download.csdn.net/detail/myamor/8393459 (2.6.X_64bit)
Win7+Eclipse+Hadoop2.6.4开发环境搭建的更多相关文章
- Spark+ECLIPSE+JAVA+MAVEN windows开发环境搭建及入门实例【附详细代码】
http://blog.csdn.net/xiefu5hh/article/details/51707529 Spark+ECLIPSE+JAVA+MAVEN windows开发环境搭建及入门实例[附 ...
- Hadoop-2.8.0 开发环境搭建(Mac)
Hadoop是一个由Apache基金会开发的分布式系统架构,简称HDFS,具有高容错性.可伸缩性等特点,并且可以部署在低配置的硬件上:同时,提供了高吞吐量的数据访问性能,适用于超大数据集的应用程序,以 ...
- 【hadoop之翊】——windows 7使用eclipse下hadoop应用开发环境搭建
由于一些缘故,这节内容到如今才写.事实上弄hadoop有一段时间了,能够编写一些小程序了,今天来还是来说说环境的搭建.... 说明一下:这篇文章的步骤是接上一篇的hadoop文章的:http://bl ...
- hadoop2.6---windows下开发环境搭建
一.准备插件 1.自己编译 1.1 安装Ant 官网下载Ant,apache-ant-1.9.6-bin.zip 配置环境变量,新建ANT_HOME,值是E:\apache-ant-1.9.6:PAT ...
- Windows下基于eclipse的Spark应用开发环境搭建
原创文章,转载请注明: 转载自www.cnblogs.com/tovin/p/3822985.html 一.软件下载 maven下载安装 :http://10.100.209.243/share/so ...
- Ubuntu+Eclipse+ADT+Genymotion+VirtualBox开发环境搭建
1.Eclispe安装就不说了 2.以下说说怎样安装ADT插件.有两种途径: (1)在线安装: 地址:https://dl-ssl.google.com/android/eclipse/(只是近期天朝 ...
- Android开发环境搭建(图文教程)
昨天又搭建了一次Android的开发环境,尝试了好几种方式,也遇到了一些问题,在此分享一下. 注意:官网公布的最新版本号的SDK和ADT(23.0.0),对于和Eclipse集成的开发环境是有BUG存 ...
- [转]Android开发环境搭建(图文教程)
转自:http://www.cnblogs.com/yxwkf/p/3853046.html 昨天又搭建了一次Android的开发环境,尝试了好几种方式,也遇到了一些问题,在此分享一下. 注意:官网公 ...
- mac10.9下eclipse的storm开发环境搭建
--------------------------------------- 博文作者:迦壹 博客地址:http://idoall.org/home.php?mod=space&uid=1& ...
随机推荐
- sql语句 之聚合函数
聚合分析 在访问数据库时,经常需要对表中的某列数据进行统计分析,如求其最大值.最小值.平均值等.所有这些针对表中一列或者多列数据的分析就称为聚合分析. 在SQL中,可以使用聚合函数快速实现数据的聚 ...
- 72. 求m到n之和
求m到n之和 int sum(int m, int n) { int i, result = 0; for (i=m; i<=n; i++) result = result+i; return ...
- Mac下,使用sshpass让iterm2支持多ssh登录信息保存
windows里有个Xshell非常的方便好使,因为它能保存你所有的ssh登录帐号信息.MAC下并没有xshell,有些也提供这样的功能,但效果都不好.iterm2是很好的终端,但却不能很好的支持多p ...
- 史上最全的java随机数生成算法分享(转)
这篇文章主要介绍了史上最全的java随机数生成算法,我分享一个最全的随机数的生成算法,最代码的找回密码的随机数就是用的这个方法 String password = RandomUtil.generat ...
- 代码阅读分析工具Understand 2.0试用
Understand 2.0是一款源代码阅读分析软件,功能强大.试用过一段时间后,感觉相当不错,确实可以大大提高代码阅读效率.由于Understand功能十分强大,本文不可能详尽地介绍它的所有功能,所 ...
- SQL常用代码段
--STUFF 函数将字符串插入另一字符串.它在第一个字符串中从开始位置删除指定长度的字符:然后将第二个字符串插入第一个字符串的开始位置. STUFF ( character_expression , ...
- xcode中使用正则表达式来搜索替换代码
有这样的需求: 类似于 GLOBAL_STR(@"请继续添加"); 这样的代码,需要批量修改为: GLOBAL_STR(@"请继续添加", nil); 这里使用 ...
- CSS之viewport 2
在这个迷你系列的文章里边我将会解释viewport,以及许多重要元素的宽度是如何工作的,比如<html>元素,也包括窗口和屏幕. 这篇文章我们来聊聊关于移动浏览器的内容.如果你对移动开发完 ...
- shell十三问
1) 为何叫做 shell ?在介绍 shell 是甚幺东西之前,不妨让我们重新检视使用者与计算机系统的关系:图(FIXME)我们知道计算机的运作不能离开硬件,但使用者却无法直接对硬件作驱动,硬件的驱 ...
- [SharePoint 2013] Set value for people editor with JSOM
function PeoplePicker() { this.context = null; this.web = null; this.currentUser = null; this.parent ...