
Spark 学习笔记之 union/intersection/subtract
union/intersection/subtract:
import org.apache.spark.SparkContext

import org.apache.spark.rdd.RDD

import org.apache.spark.sql.SparkSession

object TransformationsDemo {

  def main(args: Array[String]): Unit = {

    val sparkSession = SparkSession.builder().appName("TransformationsDemo").master("local[1]").getOrCreate()

    val sc = sparkSession.sparkContext

    testUnion(sc)

    testIntersection(sc)

    testSubtract(sc)

  }

  private def testSubtract(sc: SparkContext) = {

    val rdd1 = sc.parallelize(1 to 3, 1)

    val rdd2 = sc.parallelize(3 to 5, 1)

    //返回在当前RDD中出现,并且不在另一个RDD中出现的元素,不去重。

    rdd1.subtract(rdd2).collect().foreach(println)

    println(s"partitions: ${rdd1.subtract(rdd2, 1).partitions.size}")

    println(s"partitions: ${rdd1.subtract(rdd2, 2).partitions.size}")

    val rdd3 = sc.parallelize(List(List(1, 2, 3), List(4, 5, 6)), 1)

    val rdd4 = sc.parallelize(List(List(4, 5, 6), List(7, 8, 9)), 1)

    rdd3.subtract(rdd4).collect().foreach(println)

  }

  private def testIntersection(sc: SparkContext) = {

    val rdd1 = sc.parallelize(1 to 2, 1)

    val rdd2 = sc.parallelize(3 to 5, 1)

    //返回两个RDD的交集,并且去重。

    rdd1.intersection(rdd2).collect().foreach(println)

    println(s"partitions: ${rdd1.intersection(rdd2, 1).partitions.size}")

    println(s"partitions: ${rdd1.intersection(rdd2, 2).partitions.size}")

    val rdd3 = sc.parallelize(List(List(1, 2, 3), List(4, 5, 6)), 1)

    val rdd4 = sc.parallelize(List(List(4, 5, 6), List(7, 8, 9)), 1)

    rdd3.intersection(rdd4).collect().foreach(println)

  }

  private def testUnion(sc: SparkContext) = {

    val rdd1 = sc.parallelize(1 to 3, 1)

    val rdd2 = sc.parallelize(3 to 5, 1)

    //将两个RDD进行合并,不去重。

    rdd1.union(rdd2).collect().foreach(println)

    val rdd3 = sc.parallelize(List(List(1, 2, 3), List(4, 5, 6)), 1)

    val rdd4 = sc.parallelize(List(List(4, 5, 6), List(7, 8, 9)), 1)

    rdd3.union(rdd4).collect().foreach(println)

  }

}
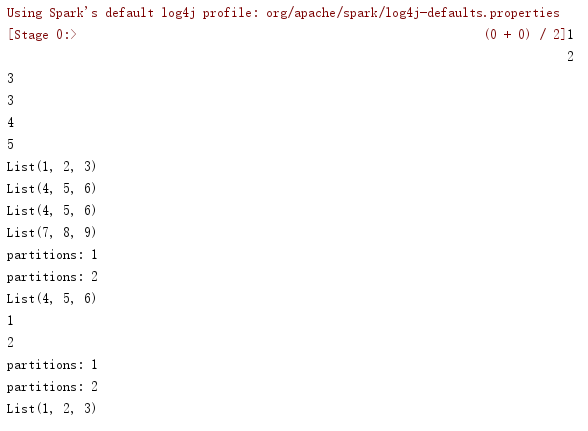
运行结果:
Spark 学习笔记之 union/intersection/subtract的更多相关文章
- Spark学习笔记3——RDD(下)
目录 Spark学习笔记3--RDD(下) 向Spark传递函数 通过匿名内部类 通过具名类传递 通过带参数的 Java 函数类传递 通过 lambda 表达式传递(仅限于 Java 8 及以上) 常 ...
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- Spark学习笔记2——RDD(上)
目录 Spark学习笔记2--RDD(上) RDD是什么? 例子 创建 RDD 并行化方式 读取外部数据集方式 RDD 操作 转化操作 行动操作 惰性求值 Spark学习笔记2--RDD(上) 笔记摘 ...
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- Spark学习笔记3(IDEA编写scala代码并打包上传集群运行)
Spark学习笔记3 IDEA编写scala代码并打包上传集群运行 我们在IDEA上的maven项目已经搭建完成了,现在可以写一个简单的spark代码并且打成jar包 上传至集群,来检验一下我们的sp ...
- Spark学习笔记-GraphX-1
Spark学习笔记-GraphX-1 标签: SparkGraphGraphX图计算 2014-09-29 13:04 2339人阅读 评论(0) 收藏 举报 分类: Spark(8) 版权声明: ...
- Spark学习笔记0——简单了解和技术架构
目录 Spark学习笔记0--简单了解和技术架构 什么是Spark 技术架构和软件栈 Spark Core Spark SQL Spark Streaming MLlib GraphX 集群管理器 受 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
随机推荐
- POJ2723 Get Luffy Out解题报告tarjan+2-SAT+二分
今天看到讲2-SAT比较好的blog,感觉微微的理解了2-SAT 传送门 参考: https://blog.csdn.net/leolin_/article/details/6680144 题意:你有 ...
- poj1986 Distance Queries(lca又是一道模版题)
题目链接:http://poj.org/problem?id=1986 题意:就是老问题求val[u]+val[v]-2*val[root]就行.还有这题没有给出不联通怎么输出那么题目给出的数据一定 ...
- 并发Bug之源有三,请睁大眼睛看清它们
写在前面 生活中你一定听说过--能者多劳 作为 Java 程序员,你一定听过--这个功能请求慢,能加一层缓存或优化一下 SQL 吗? 看过中国古代神话故事的也一定听过--天上一天,地上一年 一切设计来 ...
- mybatis 批量插入时候的一个注意点
<insert id="batchInsert" parameterType="java.util.List" useGeneratedKeys=&quo ...
- 单点登录(两种单点登录类型:SSO/CAS、相同一级域名的SSO)
单点登录:SSO(Single Sign On) 什么是单点登录:大白话就是多个网站共享一个用户名和密码的技术,对于普通用户来说,只需要登录其中任意一个网站,登录其他网站的时候就能够自动登陆,不需要再 ...
- Android 开发系列教程之(一)Android基础知识
什么是Android Android一词最早是出现在法国作家维里耶德利尔·亚当1986年发表的<未来夏娃>这部科幻小说中,作者利尔·亚当将外表像人类的机器起名为Android,这就是And ...
- xshell使用小技巧
1. 方便复制:Tool --> options --> right buttion(paste the clipboard contents) and copy selected te ...
- Python Flask高级编程之RESTFul API前后端分离精讲 (网盘免费分享)
Python Flask高级编程之RESTFul API前后端分离精讲 (免费分享) 点击链接或搜索QQ号直接加群获取其它资料: 链接:https://pan.baidu.com/s/12eKrJK ...
- python实现经典算法
1,快速排序 题目形式:手写一下快速排序算法. 题目难度:中等. 出现概率:约50%.手写快排绝对是手撕代码面试题中的百兽之王,掌握了它就是送分题,没有掌握它就是送命题. 参考代码: def quic ...
- 高性能最终一致性框架Ray之基本概念原理
一.Actor介绍 Actor是一种并发模型,是共享内存并发模型的替代方案. 共享内存模型的缺点: 共享内存模型使用各种各样的锁来解决状态竞争问题,性能低下且让编码变得复杂和容易出错. 共享内存受限于 ...