
hadoop-2.6.0源码编译
运行hadoop环境时,常常会出现这种提示
WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
意思是无法加载本地native库。
这里就需要我们自己本地进行编译hadoop源码,用生成的文件来替换原有的native库。
下面就是我整理的hadoop编译流程
首先介绍一下我的环境
centos6.5
jdk-7u79-linux-x64.tar.gz
apache-maven-3.3.9-bin.tar.gz
protobuf-2.5.0.tar.gz
hadoop-2.6.0-cdh5.12.0-src.tar.gz
接下来就进行步骤介绍
第一步,安装jdk
解压
tar -zxvf jdk-7u79-linux-x64.tar.gz
环境变量
vi /etc/profile
#JAVA_HOME

export JAVA_HOME=/home/hadoop/jdk1..0_79

export PATH=$JAVA_HOME/bin:$PATH

export CLASSPATH=.:$JAVA_HOME/lib/tools.jar:$JAVA_HOME/lib/dt.jar
测试是否安装成功
source /etc/profile

java -version
第二步,安装maven
>>提君博客原创 http://www.cnblogs.com/tijun/ <<
解压
tar -zxvf apache-maven-3.3.9-bin.tar.gz
更改名称
mv apache-maven-3.3. maven339
环境变量
vi /etc/profile
#MAVEN_HOME

export MAVEN_HOME=/home/hadoop/maven339

export PATH=$MAVEN_HOME/bin:$PATH
测试是否安装成功
source /etc/profile

mvn -version
第三步,根据多次踩坑,准备编译时需要的安装
 yum install gcc

 yum intall gcc-c++

 yum install make
或者是直接运行
yum install g++ autoconf automake libtool cmake zlib1g-dev pkg-config libssl-dev
第四步安装protoc
解压编译,逐步执行
 tar -zxvf protobuf-2.5..tar.gz

 cd protobuf-2.5.

 ./configure --prefix=/home/hadoop/protobuf250

 make

 make install
环境变量
vi /etc/profile

#PROTOC_HOME

export PROTOC_HOME=/home/hadoop/protobuf250

export PATH=$PROTOC_HOME/bin:$PATH
测试
source /etc/profile
protoc --version
第四步,编译hadoop
 tar -zxvf hadoop-2.6.-cdh5.12.0-src.tar.gz

 mv hadoop-2.6.-cdh5.12.0  hadoop260-src

 cd hadoop-2.6.-src

 mvn clean package -Dmaven.javadoc.skip=true -Pdist,native -DskipTests -Dtar
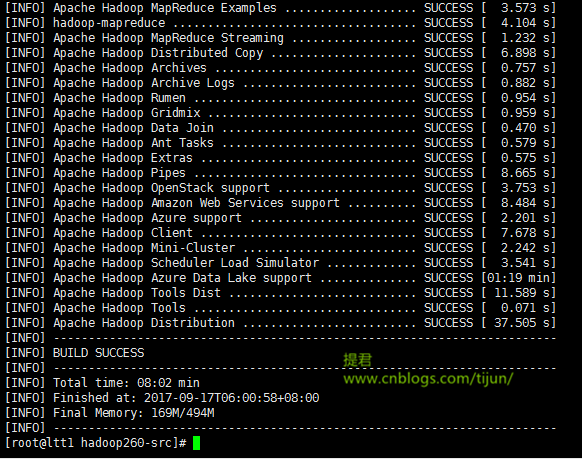
经过一段时间的等待,出现 build success ,说明编译成功。
>>提君博客原创 http://www.cnblogs.com/tijun/ <<
编译源码生成的部分都在hadoop260-src/hadoop-dist/target/目录下
将编译后的native文件夹下的东西替换到原来的native目录
cp -r hadoop260-src/hadoop-dist/target/hadoop-2.6.-cdh5.12.0/lib/native/ /home/hadoop/hadoop260/lib/
同样,其他机器的文件同样替换
 scp -r hadoop260-src/hadoop-dist/target/hadoop-2.6.-cdh5.12.0/lib/native/ hadoop@ltt2.bg.cn:/home/hadoop/hadoop260/lib/

 ..

 ..

 ..
注意:不同的linux环境,编译过程中会有不同,有可能会出一些编译过程的错误,我将再接下来的一篇文章中整理出来,供大家参考。
>>提君博客原创 http://www.cnblogs.com/tijun/ <<
hadoop-2.6.0源码编译的更多相关文章
- hadoop-1.2.0源码编译
以下为在CentOS-6.4下hadoop-1.2.0源码编译步骤. 1. 安装并且配置ant 下载ant,将ant目录下的bin文件夹加入到PATH变量中. 2. 安装git,安装autoconf, ...
- hadoop-2.6.0源码编译问题汇总
在上一篇文章中,介绍了hadoop-2.6.0源码编译的一般流程,因个人计算机环境的不同, 编译过程中难免会出现一些错误,下面是我编译过程中遇到的错误. 列举出来并附上我解决此错误的方法,希望对大家有 ...
- Spark1.0.0 源码编译和部署包生成
问题导读:1.如何对Spark1.0.0源码编译?2.如何生成Spark1.0的部署包?3.如何获取包资源? Spark1.0.0的源码编译和部署包生成,其本质只有两种:Maven和SBT,只不过针对 ...
- ambari 2.5.0源码编译安装
参考:https://www.ibm.com/developerworks/cn/opensource/os-cn-bigdata-ambari/index.html Ambari 是什么 Ambar ...
- 使用Maven将Hadoop2.2.0源码编译成Eclipse项目
编译环境: OS:RHEL 6.3 x64 Maven:3.2.1 Eclipse:Juno SR2 Linux x64 libprotoc:2.5.0 JDK:1.7.0_51 x64 步骤: 1. ...
- hadoop-2.0.0-mr1-cdh4.2.0源码编译总结
准备编译hadoop-2.0.0-mr1-cdh4.2.0的同学们要谨慎了.首先看一下这篇文章: Hadoop作业提交多种方案 http://www.blogjava.net/dragonHadoop ...
- 基于cdh5.10.x hadoop版本的apache源码编译安装spark
参考文档:http://spark.apache.org/docs/1.6.0/building-spark.html spark安装需要选择源码编译方式进行安装部署,cdh5.10.0提供默认的二进 ...
- Spark2.0.0源码编译
Hive默认使用MapReduce作为执行引擎,即Hive on mr,Hive还可以使用Tez和Spark作为其执行引擎,分别为Hive on Tez和Hive on Spark.由于MapRedu ...
- Ubantu16.04进行Android 8.0源码编译
参考这篇博客 经过测试,8.0源码下载及编译之后,占用100多G的硬盘空间,尽量给ubantu系统多留一些硬盘空间,如果后续需要在编译好的源码上进行开发,需要预留更多的控件,为了防止后续出现文件权限问 ...
- jmeter4.0 源码编译 二次开发
准备: 1.jmeter4.0源码 - apache-jmeter-4.0_src.zip 2.IDE Eclipse - Oxygen.3 Release (4.7.3) 3.JDK - 1.8.0 ...
随机推荐
- vector中删除第k个元素的巧妙方法
假设我们定义了一个vector如下: vector<int> v;v.push_back(1);...v.push_back(255); 如果要删除第k个元素的话,应该这样写: (1)如果 ...
- CORS跨域资源共享你该知道的事儿
"唠嗑之前,一些客套话" CORS跨域资源共享,这个话题大家一定不陌生了,吃久了大转转公众号的深度技术好文,也该吃点儿小米粥溜溜胃里的缝儿了,今天咱们就再好好屡屡CORS跨域资源共 ...
- 常用的Linux发行版
Linux发行版百花齐放 [内容摘要] 如今,众多的Linux发行版百花齐放,linux的阵营日益壮大,每一款发行版都拥有一大批用户,开发者自愿为相关项目投入精力.Linux发行版可谓是形形色色,它们 ...
- 【Linux Shell】uname命令行
常用命令uname -v # uname -i #uname -a dream361@master:~$ uname -n #主机名称 master dream361@master:~$ uname ...
- Ubuntu 14.04下Redis安装报错:“You need tcl 8.5 or newer in order to run the Redis test”问题解决
Redis简介: Redis是一个开源的使用ANSI C语言编写.支持网络.可基于内存亦可持久化的日志型.Key-Value数据库,并提供多种语言的API.从2010年3月15日起,Redis的开发工 ...
- 【Spring 核心】装配bean(三)XML配置
项目包结构: src/main/java com.bonc.pojo--|-CompactDisc.java (接口) |-SgtPeppers.java (实现类 实现 CompactDis ...
- Java 垃圾回收机制(早期版本)
Java 垃圾回收机制在我们普通理解来看,应该视为一种低优先级的后台进程来实现的,其实早期版本的Java虚拟机并非以这种方式实现的. 先从一种很简单的垃圾回收方式开始. 引用计数 引用计数是一种简单但 ...
- SpringMVC的@RequestParam的解释
自SpringMVC4.2之后,RequestParam内部有4个参数: 1.String name 2.String value 3.boolean required 4.String defaul ...
- Redis[三] @Hash 哈希
Redis的哈希值是字符串字段和字符串值之间的映射,所以他们是表示对象的完美数据类型 在Redis中的哈希值,可存储超过400十亿键值对. redis 提供了2套操纵 一种是批量 一种是非批量 假设需 ...
- spring mvc:Error scanning entry module-info.class from jar错误
项目从jdk1.6升级到jdk1.8,启动的时候出现如下错误: java.lang.RuntimeException: Error scanning entry module-info.class f ...