
python模块之numpy,pandas基本用法
numpy:
是 Python 的一个扩展程序库,支持大量的维度数组与矩阵运算,此外也针对数组运算提供大量的数学函数库
简单来说:就是支持一维数组和多维数组的创建和操作,并有丰富的函数库。
直接看例子
一维数组:
k=np.array([1,2,3,4])

np.ndim(k) #查看维数

1

np.shape(k) #显示维度的元素个数

(4,)

k.size     #总共多少个数字

4
二维数组:
m=np.array([[1,2,3,4],[0.1,0.2,0.3,0.4]])

np.shape(m) #

(2, 4)      #两个维度,一个维度4个数字

m

array([[1. , 2. , 3. , 4. ],

       [0.1, 0.2, 0.3, 0.4]])

m.size

8
m[:,0:2] #显示每个维度里面第一和第二个数字
array([[1. , 2. ],
[0.1, 0.2]])
下面看看一个图

pandas
是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的,它本身有很多的函数去处理维度层面的数据。
例如:
datas=pd.date_range('20191125',periods=6)
df=pd.DataFrame(np.random.randn(6,4),index=datas,columns=list('abcd')) #通过numpy生成(6,4)的随机数字

df

                   a         b         c         d

2019-11-25 -0.050400  1.399334 -0.747377 -0.246388

2019-11-26 -1.737346 -0.398420 -0.109420  0.532931

2019-11-27  1.960727 -0.267495 -0.069288  0.071406

2019-11-28  0.430069 -1.064840 -0.046383  1.358375

2019-11-29 -0.648332 -1.448899 -1.246229 -0.331214

2019-11-30 -0.468561 -0.995754  0.750662  0.335533
查看某列,某行数据,有个缺陷:写了行不能写列,写了列不能写行
df['a'] #查看a名称列的数据

2019-11-25   -0.050400

2019-11-26   -1.737346

2019-11-27    1.960727

2019-11-28    0.430069

2019-11-29   -0.648332

2019-11-30   -0.468561

Freq: D, Name: a, dtype: float64
#查看某行或者某几行数据
df['2019-11-25':'2019-11-28'] #注意
a b c d
2019-11-25 -0.050400 1.399334 -0.747377 -0.246388
2019-11-26 -1.737346 -0.398420 -0.109420 0.532931
2019-11-27 1.960727 -0.267495 -0.069288 0.071406
2019-11-28 0.430069 -1.064840 -0.046383 1.358375
df['2019-11-25':'2019-11-25'] #注意
a b c d
2019-11-25 -0.0504 1.399334 -0.747377 -0.246388
重要方法一:loc 根据数组里面存在的元素查找需要的部分
下面以df为例子
datas=pd.date_range('20191125',periods=6)
df=pd.DataFrame(np.random.randn(6,4),index=datas,columns=list('abcd'))

df

                   a         b         c         d

2019-11-25 -0.050400  1.399334 -0.747377 -0.246388

2019-11-26 -1.737346 -0.398420 -0.109420  0.532931

2019-11-27  1.960727 -0.267495 -0.069288  0.071406

2019-11-28  0.430069 -1.064840 -0.046383  1.358375

2019-11-29 -0.648332 -1.448899 -1.246229 -0.331214

2019-11-30 -0.468561 -0.995754  0.750662  0.335533
df.loc['2019-11-25':'2019-11-25','a':'b'] #查看日期2019-11-25的 a,b两列
a b
2019-11-25 -0.0504 1.399334
#需要取行中不连续的,要使用index,例如上面的index=datas,相当于把时间放入一个列表里面
df.loc[datas[0::2],'a':'b']
a b
2019-11-25 -0.050400 1.399334
2019-11-27 1.960727 -0.267495
2019-11-29 -0.648332 -1.448899
重要方法之二:iloc,它的原理将行列转化成列表的索引表示
df.iloc[0:1,1:2] #就不会出现数组里面的元素了

                   b

2019-11-25  1.399334

df.iloc[::2,0:2]

                   a         b

2019-11-25 -0.050400  1.399334

2019-11-27  1.960727 -0.267495

2019-11-29 -0.648332 -1.448899
pandas重要方法之三:groupby 根据某个列值取排列某个列或者多个列,用来计算
>>> df1=pd.DataFrame({'Data1':np.random.randint(0,10,5),'Data2':np.random.randint(10,20,5),'key1':list('aabba'),'key2':list('xyyxy')})

>>> df1

   Data1  Data2 key1 key2

0      7     15    a    x

1      3     11    a    y

2      3     18    b    y

3      6     15    b    x

4      9     10    a    y

根据单列来对单列分组计算
>>> mm=df1['Data1'].groupby(df1['key1'])
查看mm的分组情况
>>> mm.groups #'key1'列排序后就两个字符串 a,b 然后分别根据a,b来对'Data1'列进行分组
{'a': Int64Index([0, 1, 4], dtype='int64'), 'b': Int64Index([2, 3], dtype='int64')}
#对mm进行求平均
>>> mm.mean()
key1
a 6.333333
b 4.500000
Name: Data1, dtype: float64
#根据多列对多列分组
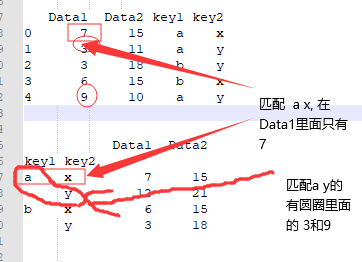
>>> df1.groupby([df1['key1'],df1['key2']]).sum()
Data1 Data2
key1 key2
a x 7 15
y 12 21
b x 6 15
y 3 18
根据多列对多列分组看下图
python模块之numpy,pandas基本用法的更多相关文章
- python模块之numpy
Numpy是一个第三方库,是数组相关的运算 通过pip安装:pip install numpy Anaconda python的一个科学计算发行版本,安装后将不必单独安装numpy,下面的库模块也将不 ...
- python模块之numpy与pandas
一.numpy numpy是python数据分析和机器学习的基础模块之一.它有两个作用:1.区别于list列表,提供了数组操作.数组运算.以及统计分布和简单的数学模型:2.计算速度快[甚至要由于pyt ...
- python 安装anaconda, numpy, pandas, matplotlib 等
如果没安装anaconda,则这样安装这些库: pip install numpy pip install pandas pip install matplotlib sudo apt-get ins ...
- Python——数据分析,Numpy,Pandas,matplotlib
由于图片内容太多,请拖动至新标签页再查看
- python库之numpy学习---nonzero()用法
当使用布尔数组直接作为下标对象或者元组下标对象中有布尔数组时,都相当于用nonzero()将布尔数组转换成一组整数数组,然后使用整数数组进行下标运算. nonzeros(a)返回数组a中值不为零的元素 ...
- 有关python numpy pandas scipy 等 能在YARN集群上 运行PySpark
有关这个问题,似乎这个在某些时候,用python写好,且spark没有响应的算法支持, 能否能在YARN集群上 运行PySpark方式, 将python分析程序提交上去? Spark Applicat ...
- Python之路-numpy模块
这里是首先需要安装好Anaconda Anaconda的安装参考Python之路-初识python及环境搭建并测试 配置好环境之后开始使用Jupyter Notebook 1.打开cmd,输入 jup ...
- Python学习day18-常用模块之NumPy
figure:last-child { margin-bottom: 0.5rem; } #write ol, #write ul { position: relative; } img { max- ...
- Ipython自动导入Numpy,pandas等模块
一.引言 最近在学习numpy,书上要求安装一个Ipythpn,可以自动导入Numpy,pandas等数据分析的模块,可是当我安装后,并不能自动导入numpy模块,还需要自己import.我就去查了一 ...
随机推荐
- Android中对Apk加固(加壳)续篇之---对Native层(so文件)进行加固
有人说Android程序用Java代码写的,再怎么弄都是不安全的,很容易破解的,现在晚上关于应用加固的技术也很多了,当然这些也可以用于商业发展的,梆梆加密和爱加密就是很好的例子,当然这两家加固的Apk ...
- Hadoop ”No room for reduce task“问题处理
早上发现一个任务有20个reduce,但是只有四个正常完成,剩余16个等待了8个小时才分配执行(集群槽位资源充足) 解决方法:查看了集群的log,发现有这种warn: -- ::, WARN org. ...
- 【ABAP系列】SAP ABAP基础-abap数据类型的解析整理
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[ABAP系列]SAP ABAP基础-abap数 ...
- 【EWM系列】SAP EWM模块-部分流程图
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[EWM系列]SAP EWM模块-部分流程图 ...
- Entity Framework 中遇到的一些小问题
一.在多表关联中,一个表中有另一个表的model累,在Include方法里提示lambda表达式不是委托类型,这时候需要using System.Data.Entity; 二.插入数据时,主键并非自增 ...
- [暑假集训Day3T2]骑士问题
标准的广搜. 采用队列保存形态,如果不会广搜的可以多看看PJ知识点.由于输入多组数据,每次标记数组要清空,每次队列元素也都要清空. 参考代码如下: #include<iostream> # ...
- Pandas处理缺失的数据
处理丢失数据 有两种丢失数据: None np.nan(NaN) import numpy as np import pandas from pandas import DataFrame 1. No ...
- [Linux Test Project] [PATCH] Fix an bad variable name erro in runltp script
[PATCH] Fix an bad variable name erro in runltp script (/opt/ltp/runltp) Hi All, I got an error fo ...
- wireshark自动化之tshark命令行
tshark是wireshark安装目录下命令行工具 使用tshark可以通过自动化方式调用wireshark tshark -a duration:30 抓包30秒-w cap.cap 保存为cap ...
- C Sleepy Kaguya
链接:https://ac.nowcoder.com/acm/contest/338/C来源:牛客网 题目描述 Houraisan☆Kaguya is the princess who lives i ...