
大数据笔记(一)——Hadoop的起源与背景知识
一.大数据的5个特征(IBM提出):
Volume(大量)
Velocity(高速)
Variety(多样)
Value(价值)
Varacity(真实性)
二.OLTP与OLAP
1.OLTP:联机事务处理过程,也称面向交易的处理过程,是对用户操作快速响应的方式之一。OLTP是传统的关系型数据库的主要应用,主要是基本的、日常的事务处理,例如银行交易:
开启事务——>从转出账号中扣钱——>往转入账号中加钱——>提交事务
2.OLAP:联机分析处理过程,是数据仓库系统的主要应用,支持复杂的分析操作,侧重决策支持,并且提供直观易懂的查询结果。例如商品推荐:
抽取(读取)历史订单——>分析历史订单,找到最受欢迎的商品——>展示结果
3.OLTP和OLAP的区别:
| OLTP | OLAP | |
| 用户 | 操作人员 | 决策人员,高级管理人员 |
| 功能 | 日常操作处理 | 分析决策 |
| DB设计 | 面向应用 | 面向主题 |
| 数据 | 当前的,最新的细节的,二维的分立的 | 历史的,聚集的,多位的,集成的,统一的 |
| 存取 | 读/写数十条记录 | 读上百万条记录 |
| 工作单位 | 简单的事务 | 复杂的事务 |
| DB大小 | 100MB-GB | 100GB-TB |
三.数据仓库
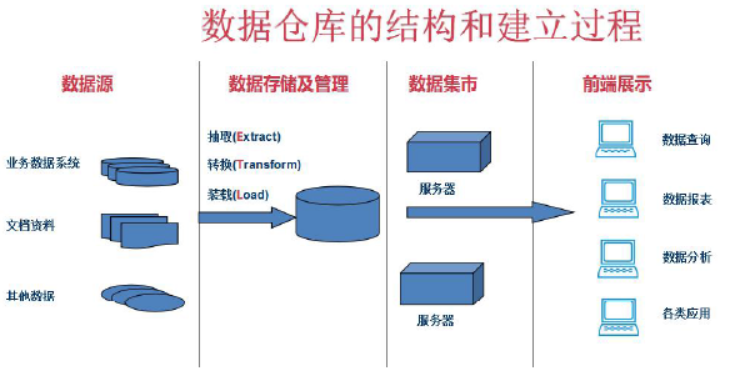
为企业所有级别的决策制定过程,提供所有类型数据支持的战略集合。
四.Google的基本思想
Hadoop的思想来源:Google
1.Google的低成本之道
- 不使用超级计算机,不使用存储(淘宝的去i,去e,去o之路)
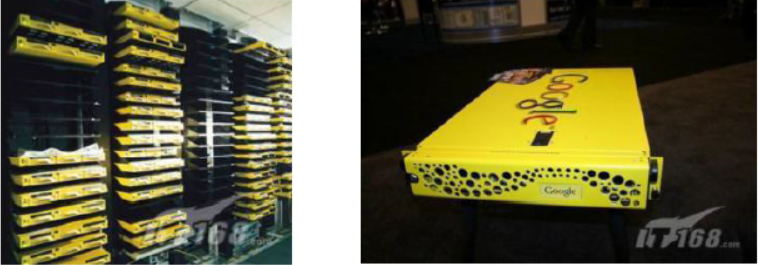
- 大量使用普通的pc服务器,提供有冗余的集群服务
- 全世界多个数据中心
- 运营商向Google倒付费
2.Google的三篇论文(Hadoop的思想来源)
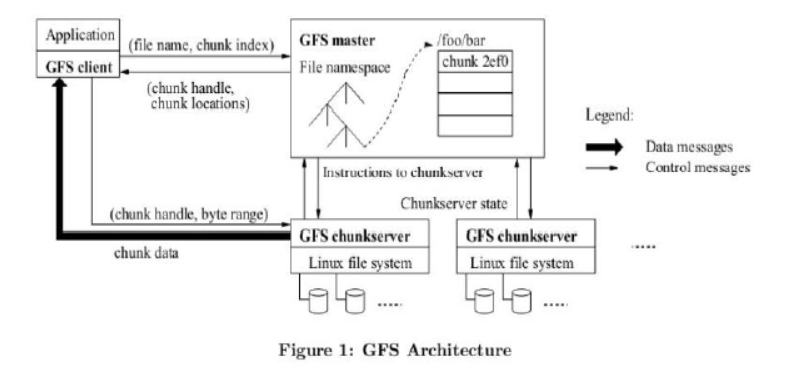
- GFS(Google File System:Google的文件系统)
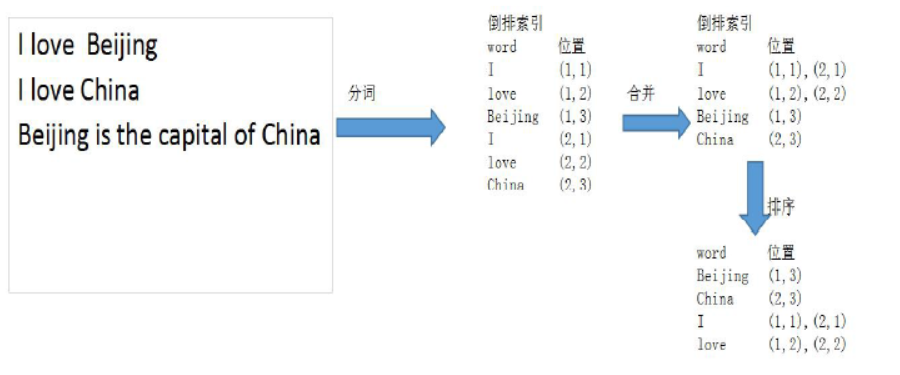
- 倒排索引
把文件ID对应到关键词的映射转换为关键词到文件ID的映射,每个关键词都对应着一系列的文件,这些文件中都出现这个关键词。
- Page Rank(排名先后)
- BigTable(大表):Google设计的分布式数据存储系统,用来处理海量数据的一种非关系型数据库。
常见的NoSQL数据库(Key-value值):
- HBase:基于HDFS,面向列的:region
- Redis:基于内存、支持持久化:rdb和aof
- MongoDB:面向文档,Json型
大数据笔记(一)——Hadoop的起源与背景知识的更多相关文章
- 大数据时代之hadoop(五):hadoop 分布式计算框架(MapReduce)
大数据时代之hadoop(一):hadoop安装 大数据时代之hadoop(二):hadoop脚本解析 大数据时代之hadoop(三):hadoop数据流(生命周期) 大数据时代之hadoop(四): ...
- 大数据测试之初识Hadoop
大数据测试之初识Hadoop POPTEST老李认为测试开发工程师是面向测试的开发,也就是说,写代码就是为完成测试任务服务的,写自动化测试(性能自动化,功能自动化,安全自动化,接口自动化等等)的cas ...
- 一篇了解大数据架构及Hadoop生态圈
一篇了解大数据架构及Hadoop生态圈 阅读建议,有一定基础的阅读顺序为1,2,3,4节,没有基础的阅读顺序为2,3,4,1节. 第一节 集群规划 大数据集群规划(以CDH集群为例),参考链接: ht ...
- 大数据笔记01:大数据之Hadoop简介
1. 背景 随着大数据时代来临,人们发现数据越来越多.但是如何对大数据进行存储与分析呢? 单机PC存储和分析数据存在很多瓶颈,包括存储容量.读写速率.计算效率等等,这些单机PC无法满足要求. 2. ...
- 从Hadoop Summit 2016看大数据行业与Hadoop的发展
前言: 好吧我承认已经有四年多没有更新博客了.... 在这四年中发生了很多事情,换了工作,换了工作的方向.在工作的第一年的时候接触机器学习,从那之后的一年非常狂热的学习机器学习的相关技术,也写了一些自 ...
- ASP.NET + SqlSever 大数据解决方案 PK HADOOP
半个月前看到博客园有人说.NET不行那篇文章,我只想说你们有时间去抱怨不如多写些实在的东西. 1.SQLSERVER优点和缺点? 优点:支持索引.事务.安全性以及容错性高 缺点:数据量达到100万以 ...
- 大数据 --> Spark与Hadoop对比
Spark与Hadoop对比 什么是Spark Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法 ...
- 白话大数据 | Spark和Hadoop到底谁更厉害?
要想搞清楚spark跟Hadoop到底谁更厉害,首先得明白spark到底是什么鬼. 经过之前的介绍大家应该非常了解什么是Hadoop了(不了解的点击这里:白话大数据 | hadoop究竟是什么鬼),简 ...
- 大数据计算框架Hadoop, Spark和MPI
转自:https://www.cnblogs.com/reed/p/7730338.html 今天做题,其中一道是 请简要描述一下Hadoop, Spark, MPI三种计算框架的特点以及分别适用于什 ...
随机推荐
- [转帖]linux screen 命令详解,xshell关掉窗口或者断开连接,查看断开前执行的命令
linux screen 命令详解,xshell关掉窗口或者断开连接,查看断开前执行的命令 https://binwaer.com/post/12.html yun install -y screen ...
- 将从model中获得的数据传到js函数中
刚遇到了一种情况,从controller中获得的model是一个集合,需要将这个集合循环放到标签中,并且需要为这些标签添加点击事件,每个值传入对应的点击事件函数中,由于model中的值是通过${ite ...
- Nginx 的方向代理及配置
最近有打算研读nginx源代码,看到网上介绍nginx可以作为一个反向代理服务器完成负载均衡.所以搜罗了一些关于反向代理服务器的内容,整理综合. 一 概述 反向代理(Reverse Proxy)方式 ...
- Vue 2.0 入门系列(14)学习 Vue.js 需要掌握的 es6 (1)
针对之前学习 Vue 用到的 es6 特性,以及接下来进一步学习 Vue 要用到的 es6 特性,做下简单总结. var.let 与 const var 与 let es6 之前,JavaScript ...
- Redis 内存满了怎么办……
我们知道Redis是基于内存的key-value数据库,因为系统的内存大小有限,所以我们在使用Redis的时候可以配置Redis能使用的最大的内存大小. 1.通过配置文件配置 通过在Redis安装目录 ...
- P1540翻译机器
这是2010提高组第一题,是一个使用队列的模拟题(然而洛谷很多大佬用了最短路) 这道题首先要判断内存中是否已有解释(因为题目已经说了长度很小,所以可以用桶排序),没有的话便去外存找,找到后,存到内存的 ...
- 05: jwt原理&使用
1.1 COOKIE使用和优缺点 参考博客:https://baijiahao.baidu.com/s?id=1608021814182894637&wfr=spider&for= ...
- read、readline 和 readlines 的区别?
假设a.txt的内容如下所示: 1 Hello 2 Welcome 3 What is the fuck... read:读取整个文件. read([size])方法从文件当前位置起读取size个字节 ...
- 广播即时通信src和des
package 第十二章; import java.io.IOException; import java.net.DatagramPacket; import java.net.InetAddres ...
- vue中获取滚动table的可视页面宽度,调整表头与列对齐(每列宽度不都相同)
mounted() { // 在mounted中监听表格scroll事件 this.$refs.scrollTable.addEventListener( 'scroll',(event) => ...