
【经典爬虫案例】用Python爬取微博热搜榜!
一、爬取目标
您好,我是@马哥python说,一名10年程序猿。
本次爬取的目标是: 微博热搜榜
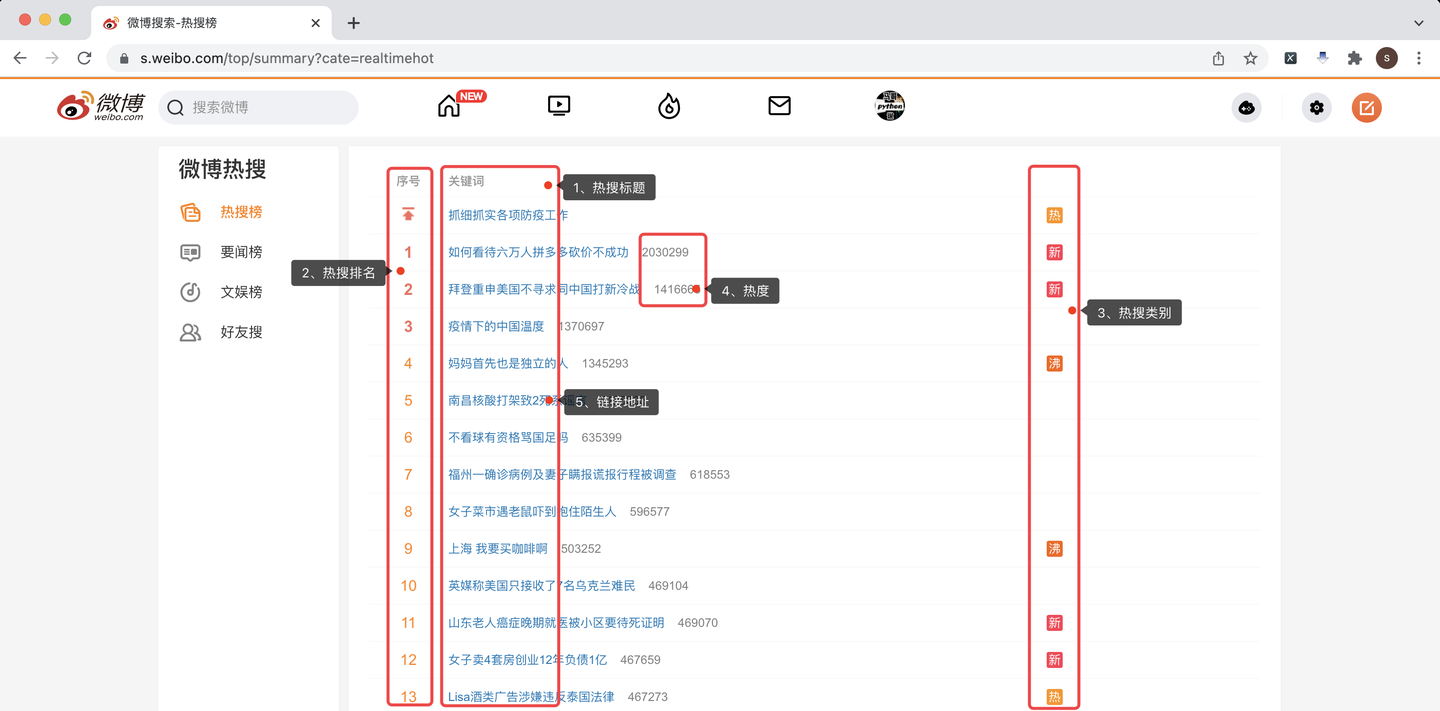
分别爬取每条热搜的:
热搜标题、热搜排名、热搜类别、热度、链接地址。
下面,对页面进行分析。
经过分析,此页面没有XHR链接通过,也就是说,没有采用AJAX异步技术。
所以,只能针对原页面进行爬取。
二、编写爬虫代码
2.1 前戏
首先,导入需要用到的库:
import pandas as pd  # 存入excel数据

import requests  # 向页面发送请求

from bs4 import BeautifulSoup as BS  # 解析页面
定义一个爬取目标地址:
# 目标地址

url = 'https://s.weibo.com/top/summary?cate=realtimehot'
定义一个请求头:
# 请求头

header = {

	'User-Agent': 'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.51 Mobile Safari/537.36',

	'Host': 's.weibo.com',

	'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

	'Accept-Language': 'zh-CN,zh-Hans;q=0.9',

	'Accept-Encoding': 'gzip, deflate, br',

	# 定期更换Cookie

	'Cookie': '换成自己的Cookie值'

}
其中,Cookie需要换成自己的Cookie值。
2.2 获取cookie
怎么查看自己的Cookie?
Chrome浏览器,按F12打开开发者模式,按照以下步骤操作:
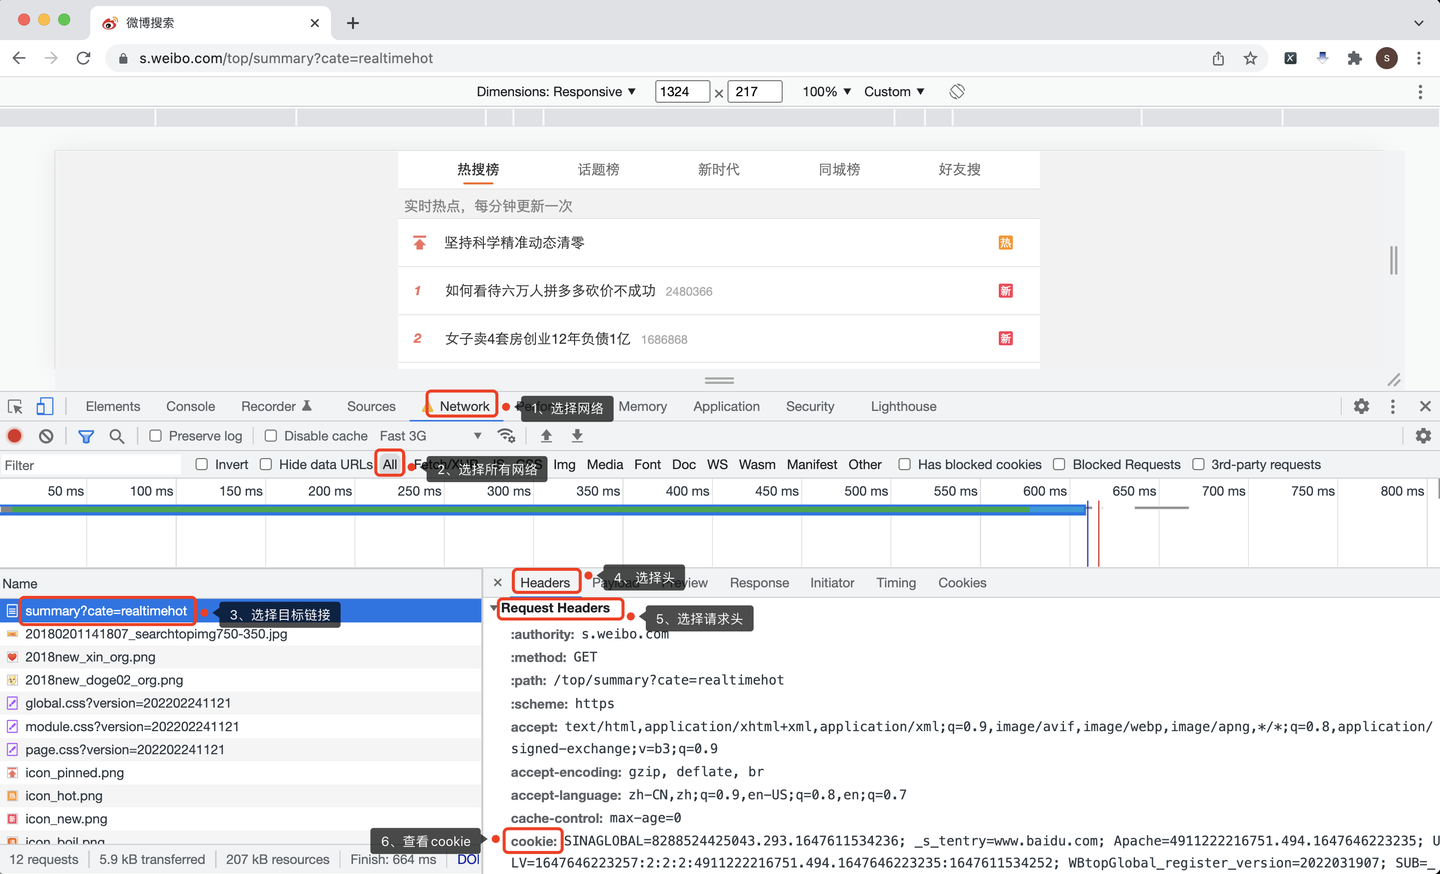
- 选择网络:Network
- 选择所有网络:All
- 选择目标链接地址
- 选择头:Headers
- 选择请求头:Request Headers
- 查看cookie值
2.3 请求页面
下面,向页面发送请求:
r = requests.get(url, headers=header) # 发送请求
2.4 解析页面
接下来,解析返回的页面:
soup = BS(r.text, 'html.parser')
```
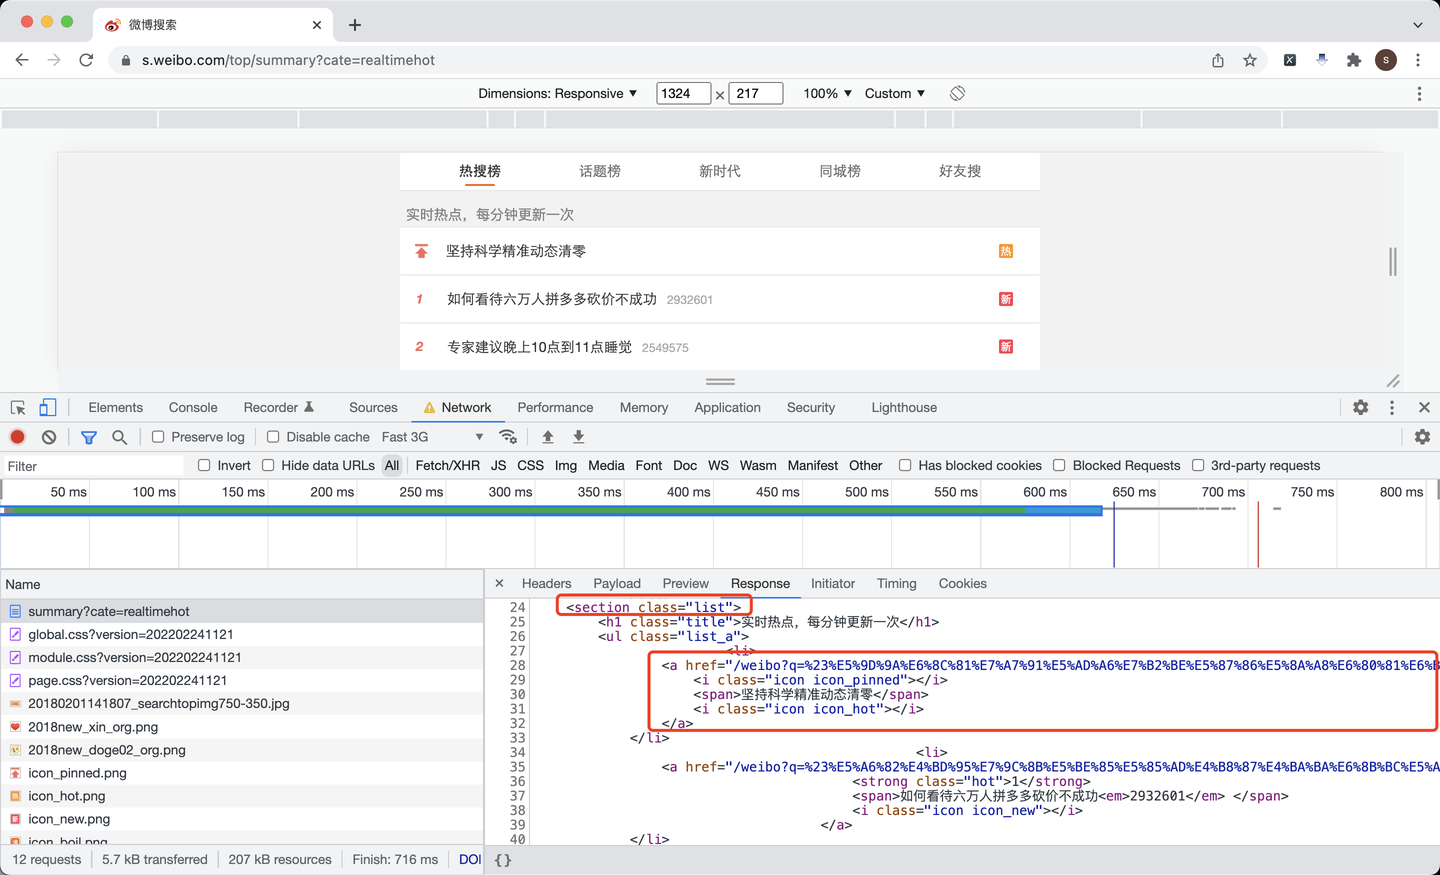
根据页面分析,每条热搜都放在了标签为section的、class值为list的数据里,里面每条热搜,又是一个a标签。
所以,根据这个逻辑,解析页面,以获取链接地址为例:
```python
items = soup.find('section', {'class': 'list'})
for li in items.find_all('li'):
# 链接地址
href = li.find('a').get('href')
href_list.append('https://s.weibo.com' + href)
页面其他元素,热搜标题、排名、热度、类别等获取代码,不再一一赘述。
2.5 转换热搜类别
其中,热搜类别这个元素需要注意,在页面上是一个个图标,背后对应的是class值,是个英文字符串,需要转换成对应的中文含义,定义以下函数进行转换:
def trans_icon(v_str):

	"""转换热搜类别"""

	if v_str == 'icon_new':

		return '新'

	elif v_str == 'icon_hot':

		return '热'

	elif v_str == 'icon_boil':

		return '沸'

	elif v_str == 'icon_recommend':

		return '商'

	else:

		return '未知'
目前的转换函数包括了"新"、"热"、"沸"、"商"等类别。
我记得,微博热搜类别,是有个"爆"的,就是热度最高的那种,突然蹿升的最热的热点,爆炸性的。但是现在没有爆炸性新闻,所以我看不到"爆"背后的class值是什么。
后续如果有爆炸性热点,可以按照代码的逻辑,加到这个转换函数里来。
2.6 保存结果
依然采用我最顺手的to_excel方式,存入爬取的数据:
df = pd.DataFrame(  # 拼装爬取到的数据为DataFrame

		{

			'热搜标题': text_list,

			'热搜排名': order_list,

			'热搜类别': type_list,

			'热度': view_count_list,

			'链接地址': href_list

		}

	)

df.to_excel('微博热搜榜.xlsx', index=False)  # 保存结果数据
至此,整个爬取过程完毕。
2.7 查看结果数据
查看一下,保存到excel里的数据:
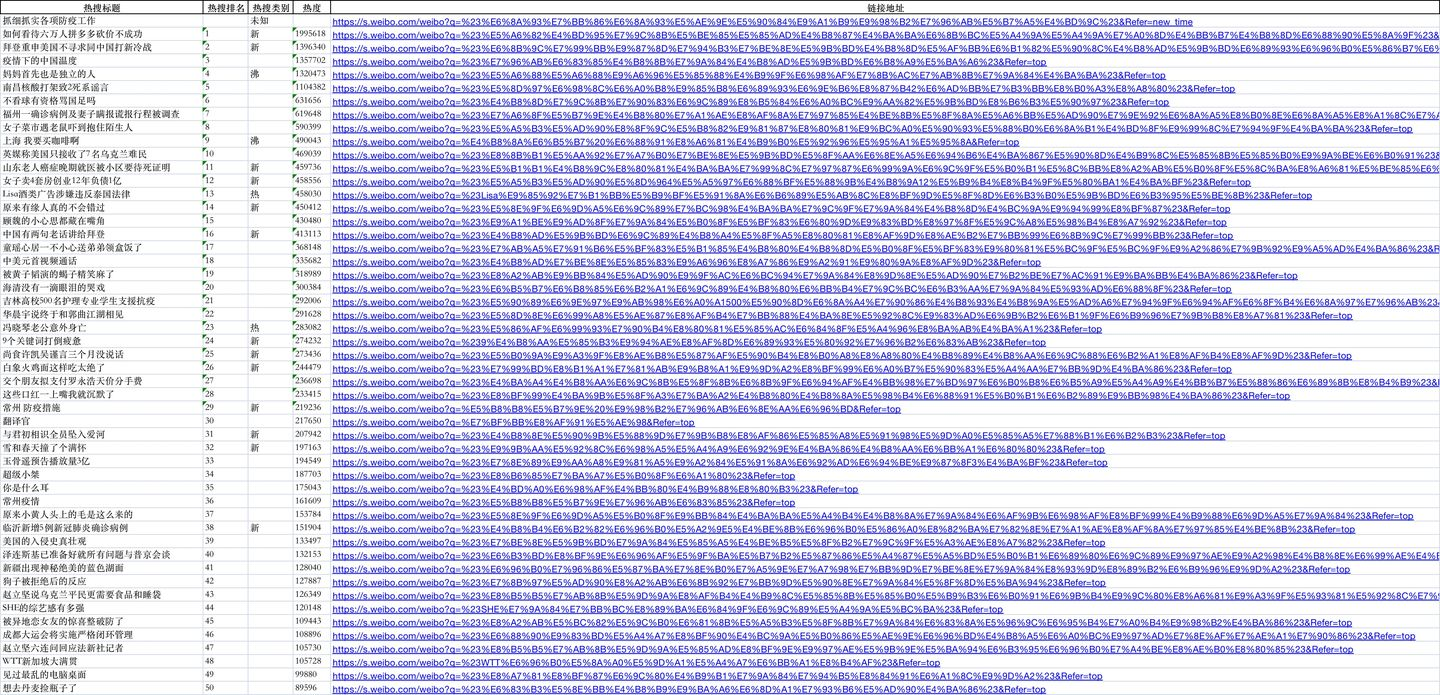
其中,第一条是置顶热搜,所以一共是 (1+50=51) 条数据。
演示视频:
https://www.bilibili.com/video/BV1Xb4y1p7Ka
三、获取完整源码
get完整代码:【最新爬虫案例】用Python爬取微博热搜榜!
我是@马哥python说,持续分享python源码干货中!
【经典爬虫案例】用Python爬取微博热搜榜!的更多相关文章
- BeautifulSoup爬取微博热搜榜
获取url 设定请求头 requests发出get请求 实例化BeautifulSoup对象 BeautifulSoup提取数据 import requests 2 from bs4 import B ...
- Python爬取微博热搜以及链接
基本操作,不再详述 直接贴源码(根据当前时间创建文件): import requests from bs4 import BeautifulSoup import time def input_to_ ...
- nodejs实现定时爬取微博热搜
The summer is coming " 我知道,那些夏天,就像青春一样回不来. - 宋冬野 青春是回不来了,倒是要准备渡过在西安的第三个夏天了. 废话 我发现,自己对 coding 这 ...
- Python网络爬虫-爬取微博热搜
微博热搜的爬取较为简单,我只是用了lxml和requests两个库 url=https://s.weibo.com/top/summary?Refer=top_hot&topnav=1& ...
- 【网络爬虫】【java】微博爬虫(一):小试牛刀——网易微博爬虫(自定义关键字爬取微博数据)(附软件源码)
一.写在前面 (本专栏分为"java版微博爬虫"和"python版网络爬虫"两个项目,系列里所有文章将基于这两个项目讲解,项目完整源码已经整理到我的Github ...
- 爬虫系列(1)-----python爬取猫眼电影top100榜
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天在整理代码时,整理了一下之前自己学习爬虫的一些代码,今天先上一个简单的例子,手把手教你入门Python爬虫,爬取 ...
- 2020不平凡的90天,Python分析三个月微博热搜数据带你回顾
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:刘早起早起 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- 【python网络编程】新浪爬虫:关键词搜索爬取微博数据
上学期参加了一个大数据比赛,需要抓取大量数据,于是我从新浪微博下手,本来准备使用新浪的API的,无奈新浪并没有开放关键字搜索的API,所以只能用爬虫来获取了.幸运的是,新浪提供了一个高级搜索功能,为我 ...
- 用python爬取微博数据并生成词云
很早之前写过一篇怎么利用微博数据制作词云图片出来,之前的写得不完整,而且只能使用自己的数据,现在重新整理了一下,任何的微博数据都可以制作出来,放在今天应该比较应景. 一年一度的虐汪节,是继续蹲在角落默 ...
- Python爬取酷狗飙升榜前十首(100)首,写入CSV文件
酷狗飙升榜,写入CSV文件 爬取酷狗音乐飙升榜的前十首歌名.歌手.时间,是一个很好的爬取网页内容的例子,对爬虫不熟悉的读者可以根据这个例子熟悉爬虫是如何爬取网页内容的. 需要用到的库:requests ...
随机推荐
- 测试开发之系统篇-安装KVM虚拟机
虚拟机(Virtual Machine)和容器(Container)是两种流行的虚拟化技术. 虚拟机模拟机器的硬件,包括了完整的操作系统和应用,它一旦被开启,预分配给它的资源将全部被占用.容器是运行在 ...
- 花式栈溢出 CTFshowpwn88
花式栈溢出 在这之前确实对这方面了解很少,一般这种花式栈溢出不仅仅要求你能发现漏洞,最主要的是你要有随机应变的能力 这个题是一个64位的题目看一下保护 canary 和 nx保护都开了,我们用ida打 ...
- 使用OHOS SDK构建libsamplerate
参照OHOS IDE和SDK的安装方法配置好开发环境. 从github下载源码. 执行如下命令: git clone --depth=1 https://github.com/libsndfile/l ...
- 【中秋国庆不断更】OpenHarmony定义可动画属性:@AnimatableExtend装饰器
[中秋国庆不断更]OpenHarmony定义可动画属性:@AnimatableExtend装饰器 @AnimatableExtend装饰器用于自定义可动画的属性方法,在这个属性方法中修改组件不可动画的 ...
- 学习如何使用 Python 连接 MongoDB: PyMongo 安装和基础操作教程
Python 可以用于数据库应用程序.最流行的 NoSQL 数据库之一是 MongoDB MongoDB MongoDB 将数据存储在类似 JSON 的文档中,使数据库非常灵活和可扩展. 您可以在 M ...
- 家庭实验室系列文章-如何迁移树莓派系统到更大的 SD 卡?
前言 其实这个专题很久很久之前就想写了,但是一直因为各种原因拖着没动笔. 因为没有资格,也没有钱在一线城市买房 (); 但是在要结婚之前,婚房又是刚需. 我和太太最终一起在一线城市周边的某二线城市买了 ...
- 前端使用 Konva 实现可视化设计器(3)
github/gitee Star 终于有几个了! 从这章开始,难度算是(或者说细节较多)升级,是不是值得更多的 Star 呢?! 继续求 Star ,希望大家多多一键三连,十分感谢大家的支持~ 创作 ...
- 安全工具分析系列-Londly01
前言 原创作者:Super403,文章分析主要用于研究教学 本期研究:[Londly01-safety-tool]工具源码 简介:自动化资产探测及漏扫脚本 工具来源:https://github.co ...
- CentOS 6.5编译安装httpd-2.4.7
CentOS 6.5编译安装httpd-2.4.7 CentOS 编译安装 Apache 2.4 准备: [root@NFSServer ~]# yum groupinstall "Deve ...
- linux 性能自我学习 ———— 软中断 [五]
前言 linux 性能的自我学习. 正文 什么是软中断呢? 举一个网络的例子. linux 将中断处理过程分为两个阶段: 上半部用来快速处理中断,他在中断禁止模式下运行,注意是处理跟硬件紧密相关或时间 ...