
理解HashMap的原理

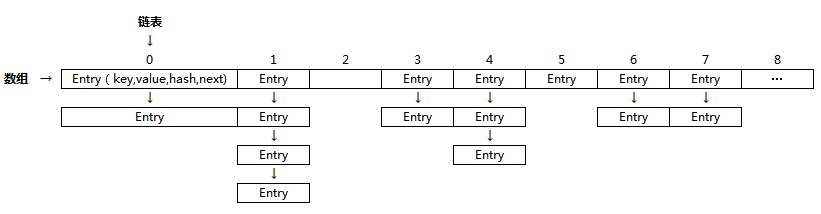
static int hash( int h ) {

             // This function ensures that hashCodes that differ only by

             // constant multiples at each bit position have a bounded

             // number of collisions (approximately 8 at default load factor).

             h ^= (h >>> 20) ^ ( h >>> 12) ;

             return h ^ (h >>> 7 ) ^ (h >>> 4);

       }
说明:该hash算法的内部实现乍一看的确很晦涩难懂。参数值h是key.hashCode(),很明显,该方法的意图就是根据key.hasCode()的值进行重新计算。为什么要这么做呢?因为HashMap要求key的hashCode值分布越均匀性能就越好(见上图,若hash函数计算出的hash值越均匀,链表的长度也就越均衡,就不会造成有的链表长度很短,而有的链表长度特别长的情况,我们知道,链表长度越长,检索效率就越慢)。而put到HashMap作为key的对象的hashCode可能五花八门,有的对象的hashCode可能还进行过重写,这可能导致put到HashMap中的key的hashCode值分布可能会不均衡,所以HashMap就利用这样一个算法对hashCode进行重新计算,以期望得到更加分布均衡的hashCode值。
static int indexFor( int h , int length) {

             return h & (length - 1 );

       }
说明:在计算机数学里有这么一个法则: 当SIZE满足大小是2的幂的时候,X % SIZE(取模操作)和 X & (SIZE-1)是等价的,不信?自己动手演算一下?因此我们知道了为什么HashMap要求我们提供的capacity大小是2的幂的原因了吧?用户提供给HashMap构造函数的capacity值可能不是2的幂,所以hashmap内部进行了验证并将其重设为最接近指定capacity值的2的幂的那个值:
int capacity = 1;

while (capacity < initialCapacity)

     capacity <<= 1;
介绍了前两个重要方法,下面欢迎我们熟悉的put方法出场:
public V put ( K key , V value ) {

             if ( key == null)

                   return putForNullKey ( value) ;

             int hash = hash (key . hashCode()) ;

             int i = indexFor (hash , table . length) ;

             for ( Entry <K , V> e = table [ i ]; e != null ; e = e. next ) {

                   Object k ;

                   //

                   if ( e .hash == hash && ((k = e .key ) == key || key .equals ( k))) {

                        V oldValue = e. value ;

                         e .value = value ;

                         e .recordAccess ( this) ;

                         return oldValue ;

                   }

             }

             modCount ++;

             addEntry (hash , key , value , i ) ;

             return null ;

       }
- http://blog.csdn.net/csfreebird/article/details/7355282
- http://stackoverflow.com/questions/9335169/understanding-strange-java-hash-function
- http://stackoverflow.com/questions/299304/why-does-javas-hashcode-in-string-use-31-as-a-multiplier
理解HashMap的原理的更多相关文章
- 深入理解HashMap(原理,查找,扩容)
面试的时候闻到了Hashmap的扩容机制,之前只看到了Hasmap的实现机制,补一下基础知识,讲的非常好 原文链接: http://www.iteye.com/topic/539465 Hashmap ...
- 理解HashMap底层原理,一个简单的HashMap例子
package com.jl.testmap; /** * 自定义一个HashMap * @author JiangLai * */ public class MyHashMap<K,V> ...
- java基础之hashcode理解及hashmap实现原理及MD5
HashCode值 1. hashcode值是int的,64位.int hashCode(). 2. java object类默认的hashcode()计算方法是根据对象的内存地址来计算的.所以可由此 ...
- HashMap实现原理及源码分析
哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表,而HashMap的实现原理也常常出 ...
- JVM里面hashtable和hashmap实现原理
JVM里面hashtable和hashmap实现原理 文章分类:Java编程 转载 在hashtable和hashmap是java里面常见的容器类, 是Java.uitl包下面的类, 那么Hash ...
- 基础进阶(一)之HashMap实现原理分析
HashMap实现原理分析 1. HashMap的数据结构 数据结构中有数组和链表来实现对数据的存储,但这两者基本上是两个极端. 数组 数组存储区间是连续的,占用内存严重,故空间复杂的很大.但数组的二 ...
- Java HashMap工作原理及实现
Java HashMap工作原理及实现 2016/03/20 | 分类: 基础技术 | 0 条评论 | 标签: HASHMAP 分享到:3 原文出处: Yikun 1. 概述 从本文你可以学习到: 什 ...
- HashMap实现原理及源码分析(JDK1.7)
转载:https://www.cnblogs.com/chengxiao/p/6059914.html 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技 ...
- HashMap 实现原理
深入Java集合学习系列:HashMap的实现原理 参考文献 引用文献:深入Java集合学习系列:HashMap的实现原理,大部分参考这篇博客,只对其中进行稍微修改 自己曾经写过的:Hashmap ...
随机推荐
- 使用PrintWriter out=response.getWriter();输出script脚本时乱码解决
使用PrintWriter out=response.getWriter();输出script脚本时乱码解决 最近遇到了一个奇怪的事情,仅仅用out.print("<script ty ...
- 2018.09.21 atcoder An Invisible Hand(贪心)
传送门 简单贪心啊. 这题显然跟t并没有关系,取差量最大的几组买入卖出就行了. 于是我们统计一下有几组差量是最大的就行了. 代码: #include<bits/stdc++.h> #def ...
- modelsim读写TXT文件
//open the file Initial Begin step_file = $fopen("F:/Company/Src/txt/step.v","r" ...
- ArcGIS Desktop python Add-in 创建一个插件
1)创建一个项目 首先创建一个插件项目,本节介绍如何利用向导创建一个插件项目. 创建任何一个ArcGIS插件产品的过程都是一样的. 创建一个Python插件项目包括2个步骤: a) 选择一个插件项目文 ...
- [翻译]Spring MVC RESTFul Web Service CRUD 例子
Spring MVC RESTFul Web Service CRUD 例子 本文主要翻译自:http://memorynotfound.com/spring-mvc-restful-web-serv ...
- (转) MVC 中 @help 用法
ASP.NET MVC 3支持一项名为“Razor”的新视图引擎选项(除了继续支持/加强现有的.aspx视图引擎外).当编写一个视图模板时,Razor将所需的字符和击键数减少到最小,并保证一个快速.通 ...
- 常用的SLAM解决方案
ORB SLAM 可以去Github上自己搜索现成的SLAM程序包 在此基础上做优化 视觉SLAM的分类方法:按摄像头的多少分为单目和双目,按是否使用概率方法分为概率法和图法 链接 学习SLAM重要的 ...
- C++中的矩阵运算
C++中的矩阵运算 1. 2阶矩阵的逆矩阵公式
- java:从消息机制谈到观察者模式
从简单的例子开始 同样,我们还是先看一个简单例子:创建一个窗口实现加法的计算功能.其效果如下: 图1: 加法计算 Calculator.java: import javax.swing.*; impo ...
- hdu 1000 真水题
#include <iostream> #include <cstdio> #include <cstring> #include <string.h> ...