
分布式调度任务-ElasticJob
一:问题的引出与复现
在一个风和日丽的工作日,公司运营发现系统的任务数据没有推送执行,整个流程因此停住了。我立马远程登陆服务器,查看日志,好家伙,系统在疯狂的打印相同的一段日志:c.d.d.j.i.e.LeaderElectionService [traceId=] - Elastic job: leader node is electing, waiting for 100 ms at server '192.168.0.6'
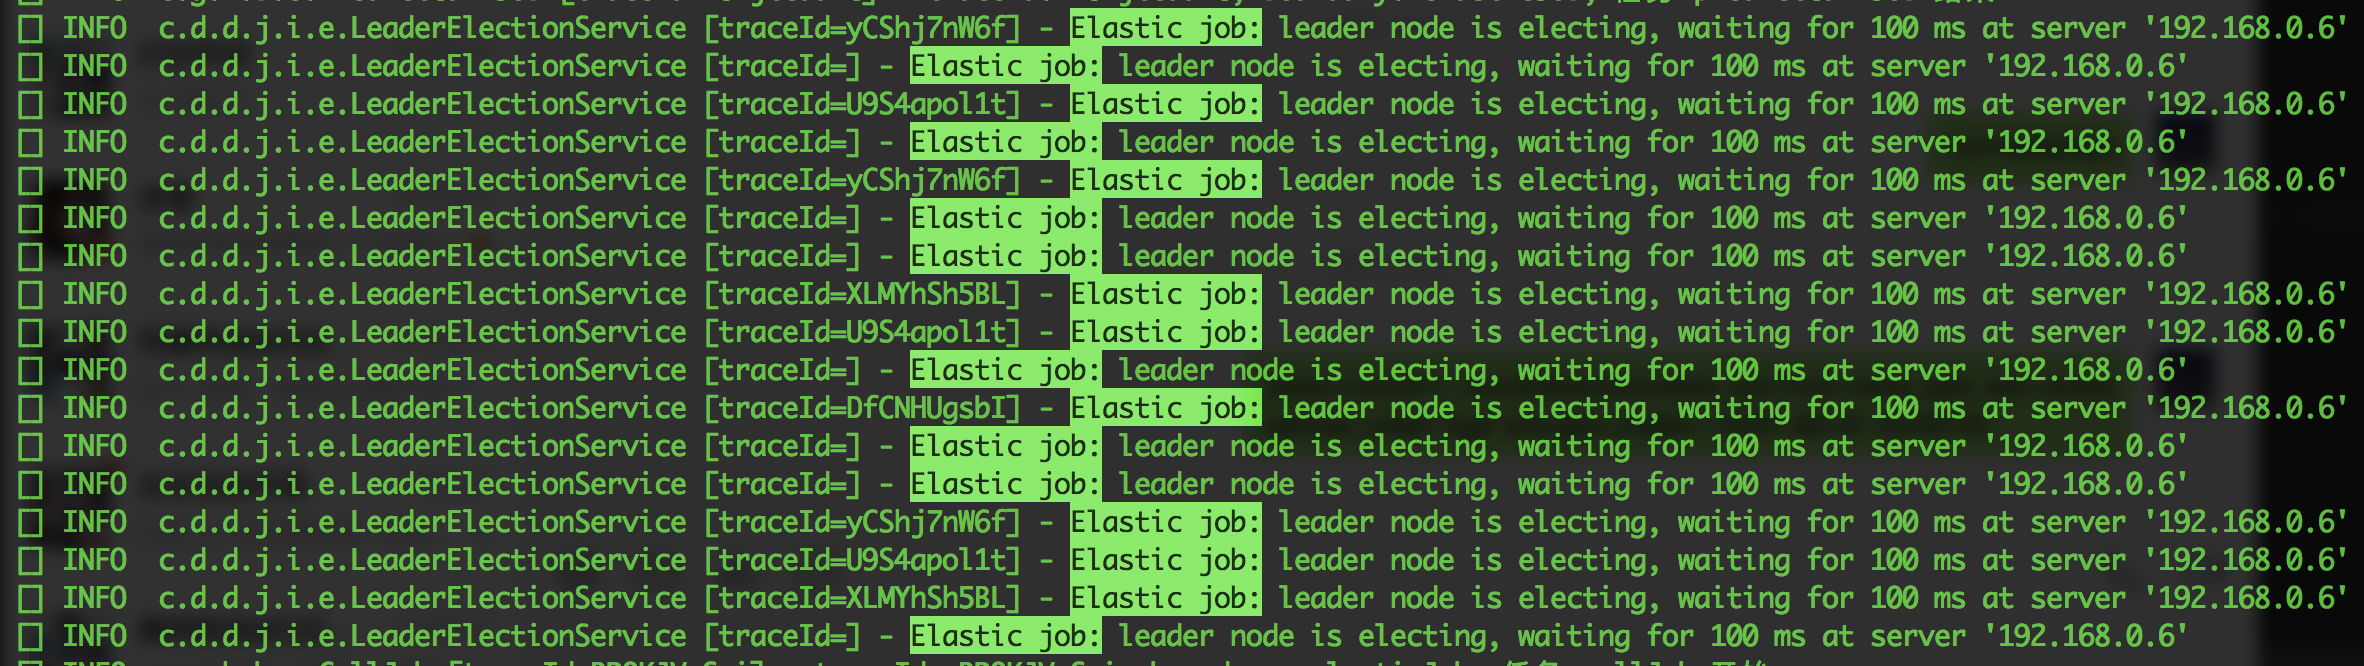
第一反应就是基建出问题了,无奈和运营商量,准备重启项目服务,重启后,问题立刻解决,业务也正常运行了。
有句话说得好,你觉得可能再次出现的问题,一定会再次出现。忘记了多少天后(开发初期,业务很紧张,这个问题没有时间及时去处理),又有别的定时任务也不执行了,出现的问题也是一模一样。
同一个问题在生产出现了两次,已经必须要去解决了,首先去网上搜索下,也有网友遇到过这种问题,但是下面的回复却是说:”Elastic job正在选举主节点,等它选完就正常了。“
先说下当时生产正在用的就是 com.dangdang.elastic-job-core,是当当网开源的一个分布式调度的组件,在上家公司三个机器节点做的集群用了很长时间也重来没有遇到这个问题,
当时就纳闷了,难道是有什么配置设置的不对,导致它无法正常选主吗?
然后花了点时间,自己搭了一个项目,准备去仔细分析debug下它的源码,在这儿就发现,每次远程debug的时候,一两分钟后,项目日志就会复现 c.d.d.j.i.e.LeaderElectionService [traceId=] - Elastic job: leader node is electing, waiting for 100 ms at server '192.168.0.6' 。
因此大胆猜测,因为debug导致Elastic job和注册中心心跳链接超时了,而生产环境的系统也可能因为网络抖动或者IO的压力,导致这个问题。
二:ElasticJob简单使用
2020年6月,经过Apache ShardingSphere社区投票,接纳ElasticJob为其子项目。目前ElasticJob的四个子项目已经正式迁入Apache仓库。
http://shardingsphere.apache.org/elasticjob/index_zh.html 最新的3.x版本在开源社区的帮助下,相比之前已经有了很大的优化,当然经过测试,也完美解决了选主的问题。
大致翻阅一下官方文档,下面就准备接入测试下。
引入maven依赖
<dependency>

    <groupId>org.apache.shardingsphere.elasticjob</groupId>

    <artifactId>elasticjob-lite-core</artifactId>

    <version>${latest.release.version}</version>

</dependency>

# Spring 命名空间,可以与 Spring 容器配合使用
<dependency>
    <groupId>org.apache.shardingsphere.elasticjob</groupId>
    <artifactId>elasticjob-lite-spring-namespace</artifactId>
    <version>3.0.0-beta</version>
</dependency>
# zk的版本要求3.6.0 以上
<dependency>
    <groupId>org.apache.zookeeper</groupId>
    <artifactId>zookeeper</artifactId>
    <version>3.6.2</version>
</dependency>
elasticjob.xml
<?xml version="1.0" encoding="UTF-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"

           xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

           xmlns:elasticjob="http://shardingsphere.apache.org/schema/elasticjob"

           xsi:schemaLocation="http://www.springframework.org/schema/beans

                        http://www.springframework.org/schema/beans/spring-beans.xsd

                        http://shardingsphere.apache.org/schema/elasticjob

                        http://shardingsphere.apache.org/schema/elasticjob/elasticjob.xsd

                        ">

    <elasticjob:zookeeper id="regCenter2" server-lists="${zkHost}" namespace="${elastic.job.namespace}"

                   base-sleep-time-milliseconds="${elastic.job.baseSleepTimeMilliseconds}"

                   max-sleep-time-milliseconds="${elastic.job.maxSleepTimeMilliseconds}" max-retries="${elastic.job.maxRetries}"/>


    <elasticjob:job id="apacheTestJob"

                job-ref="apacheTestJob"

                registry-center-ref="regCenter2" sharding-total-count="${apacheTestJob.shardingTotalCount}"

                cron="${apacheTestJob.cron}"

                failover="${apacheTestJob.failover}" description="${apacheTestJob.description}"

                disabled="${apacheTestJob.disabled}"

                overwrite="${apacheTestJob.overwrite}"

                job-executor-service-handler-type="SINGLE_THREAD"/>

    <bean id="apacheTestJob" class="com.yxy.nova.elastic.job.ApacheTestJob" />

</beans>
可配置属性:
| 属性名 | 是否必填 |
|---|---|
| id | 是 |
| class | 否 |
| job-ref | 否 |
| registry-center-ref | 是 |
| tracing-ref | 否 |
| cron | 是 |
| sharding-total-count | 是 |
| sharding-item-parameters | 否 |
| job-parameter | 否 |
| monitor-execution | 否 |
| failover | 否 |
| misfire | 否 |
| max-time-diff-seconds | 否 |
| reconcile-interval-minutes | 否 |
| job-sharding-strategy-type | 否 |
| job-executor-service-handler-type | 否 |
| job-error-handler-type | 否 |
| job-listener-types | 否 |
| description | 否 |
| props | 否 |
| disabled | 否 |
| overwrite | 否 |
1:cron 定时执行的表达式
2:sharding-total-count 总的分片数
3:job-sharding-strategy-type 分片策略
可以看它内置的三种策略,说明比较详细,默认的是 平均分片策略。
下面再说说如何自定义分片策略,ElasticJob加载分片策略使用的是JDK的spi (Service Provider Interface)加载的。
要使用SPI比较简单,只需要按照以下几个步骤操作即可:
- 在META-INF/services目录下创建一个以"接口全限定名"为命名的文件,内容为实现类的全限定名
- 接口实现类所在的jar包在classpath下
- 主程序通过java.util.ServiceLoader动态状态实现模块,它通过扫描META-INF/services目录下的配置文件找到实现类的全限定名,把类加载到JVM
- SPI的实现类必须带一个无参构造方法
首先自定义一个策略类MyJobShardingStrategy,实现 JobShardingStrategy
package com.nova.elastic.job;

import org.apache.shardingsphere.elasticjob.infra.handler.sharding.JobInstance;

import org.apache.shardingsphere.elasticjob.infra.handler.sharding.JobShardingStrategy;

import java.util.ArrayList;

import java.util.HashMap;

import java.util.List;

import java.util.Map;

public class MyJobShardingStrategy implements JobShardingStrategy {

    /**

     * Sharding job.

     *

     * @param jobInstances       all job instances which participate in sharding

     * @param jobName            job name

     * @param shardingTotalCount sharding total count

     * @return sharding result

     */

    @Override

    public Map<JobInstance, List<Integer>> sharding(List<JobInstance> jobInstances, String jobName, int shardingTotalCount) {

        Map<JobInstance, List<Integer>> result = new HashMap<>();

        List<Integer> shardingItems = new ArrayList<>(shardingTotalCount + 1);

        for (int i=0; i<shardingTotalCount; i++) {

            shardingItems.add(i);

        }

        result.put(jobInstances.get(0), shardingItems);

        return result;

    }

    /**

     * Get type.

     *

     * @return type

     */

    @Override

    public String getType() {

        return "MY_TEST";

    }

}
然后我们只需要在自己项目的resources下,建一个META-INF/services的文件夹,再创建以 a接口的全限定名(org.apache.shardingsphere.elasticjob.infra.handler.sharding.JobShardingStrategy),内容则为”com.nova.elastic.job.MyJobShardingStrategy“

这样ElasticJob的主程序通过java.util.ServiceLoader就可以把我们自定义的策略类加载好。
最后就可以在xml中,job-sharding-strategy-type="MY_TEST", 配置使用自定义的分片策略。
三:存在的问题
我模拟了 1 台作业服务器且分片总数为2,则分片结果为:1=[0,1],然后我再自己的调度任务中打印了 shardingContext,
2021-06-08 16:33:35.029 [] INFO  c.y.n.e.j.ApacheTestJob [traceId=] - ShardingContext(jobName=apacheTestJob-no-repeat, taskId=apacheTestJob-no-repeat@-@0,1@-@READY@-@172.16.0.4@-@23146, shardingTotalCount=2, jobParameter=, shardingItem=0, shardingParameter=null)

2021-06-08 16:33:35.029 [] INFO  c.y.n.e.j.ApacheTestJob [traceId=] - ShardingContext(jobName=apacheTestJob-no-repeat, taskId=apacheTestJob-no-repeat@-@0,1@-@READY@-@172.16.0.4@-@23146, shardingTotalCount=2, jobParameter=, shardingItem=1, shardingParameter=null)
可以看到,在这种配置条件下,ApacheTestJob 是同时执行两次,只有 shardingItem 有区别,那么这样就会存在一个问题,我job的代码逻辑就会执行两次,只不过每次的shardingItem不同而已。
如果业务逻辑需要查询数据库,那么这样就select了多次,在数据库有瓶颈的系统下,效率肯定低。
反之,如果在这个配置下,调度任务只被调度一次,但是 ShardingContext 可以保存一个 shardingItem的列表,这样就可以解决多次查询数据库的问题。
这也是用了这两种ElasticJob后,感受到的最大的区别。
不知道有没有正在使用 shardingsphere.elasticjob的小伙伴,你们的系统是如何使用的?有没有存在相同的疑惑?又是如何解决这个问题的?
分布式调度任务-ElasticJob的更多相关文章
- Elastic-Job 分布式调度平台
概述 referred:http://elasticjob.io/docs/elastic-job-lite/00-overview Elastic-Job是一个分布式调度解决方案,由两个相互独立的子 ...
- elastic-job分布式调度与zookeeper的简单应用
一.对分布式调度的理解 调度->定时任务,分布式调度->在分布式集群环境下定时任务这件事 Elastic-job(当当⽹开源的分布式调度框架) 1 定时任务的场景 定时任务形式:每隔⼀定时 ...
- ElasticJob 3.0.0:打造面向互联网生态和海量任务的分布式调度解决方案
ElasticJob 于 2020 年 5 月 28 日重启并成为 Apache ShardingSphere 子项目.新版本借鉴了 ShardingSphere 可拔插架构的设计理念,对内核进行了大 ...
- Elastic-Job-一个分布式调度解决方案
注:Elastic-Job是一个分布式调度解决方案,由两个相互独立的子项目Elastic-Job-Lite和Elastic-Job-Cloud组成.Elastic-Job-Lite定位为轻量级无中心化 ...
- 基于Quartz编写一个可复用的分布式调度任务管理WebUI组件
前提 创业小团队,无论选择任何方案,都优先考虑节省成本.关于分布式定时调度框架,成熟的候选方案有XXL-JOB.Easy Scheduler.Light Task Scheduler和Elastic ...
- 详解应对平台高并发的分布式调度框架TBSchedule
转载: 详解应对平台高并发的分布式调度框架TBSchedule
- spring boot / cloud (十五) 分布式调度中心进阶
spring boot / cloud (十五) 分布式调度中心进阶 在<spring boot / cloud (十) 使用quartz搭建调度中心>这篇文章中介绍了如何在spring ...
- Spring整合Quartz分布式调度
前言 为了保证应用的高可用和高并发性,一般都会部署多个节点:对于定时任务,如果每个节点都执行自己的定时任务,一方面耗费了系统资源,另一方面有些任务多次执行,可能引发应用逻辑问题,所以需要一个分布式的调 ...
- Spring整合Quartz分布式调度(山东数漫江湖)
前言 为了保证应用的高可用和高并发性,一般都会部署多个节点:对于定时任务,如果每个节点都执行自己的定时任务,一方面耗费了系统资源,另一方面有些任务多次执行,可能引发应用逻辑问题,所以需要一个分布式的调 ...
随机推荐
- 关于js中的回调函数callback,通俗易懂
前言 其实我一直很困惑关于js 中的callback,困惑的原因是,学习中这块看的资料少,但是平时又经常见,偶尔复制一下前人代码,功能实现了也就不再去追其原由,这么着,这个callback的概念就越来 ...
- 【Springboot】FastJson与Jackson全局序列化方式的配置和相关工具类
springboot 版本: <parent> <groupId>org.springframework.boot</groupId> <artifactId ...
- hdu5105给你一个方程,让你求极值(直接暴力)
题意: 给你一个方程f[x] = abss(a * x * x * x + b * x * x + c * x + d); 然后给你各个参数还有x(-100<x<100)的取值 ...
- POJ 2396 构造矩阵(上下流)
题意: 要求构造一个矩阵,给你行和,列和,还有一些点的上下范围,输出一个满足题意的矩阵. 思路: 这个题目很经典,这是自己看上下流后接触的第一道题,感觉很基础的一道题目,现在我 ...
- Python 爬虫 BeautifulSoup4 库的使用
BeautifulSoup4库 和 lxml 一样,Beautiful Soup 也是一个HTML/XML的解析器,主要的功能也是如何解析和提取 HTML/XML 数据.lxml 只会局部遍历,而Be ...
- PhpStorm 配置本地文件自动上传至服务器
目的:本地文件夹下的文件实时同步至指定服务器的文件夹,减少代码移植的成本和风险 添加一个SFTP连接 Tools - Deployment - Browse Remote Host 配置连接参数 Co ...
- jpa查找数据库最新一条消息
主要字段说明: pid:指导记录主键 user_pid:用户主键 competition_project_pid:用户作品 Mysql表 Repository /** * 指导记录 * @date 2 ...
- Flink去重统计-基于自定义布隆过滤器
一.背景说明 在Flink中对流数据进行去重计算是常有操作,如流量域对独立访客之类的统计,去重思路一般有三个: 基于Hashset来实现去重 数据存在内存,容量小,服务重启会丢失. 使用状态编程Val ...
- C# 给PDF签名时添加时间戳的2种方法(附VB.NET代码)
在PDF添加签名时,支持添加可信时间戳来保证文档的法律效应.本文,将通过C#程序代码介绍如何添加可信时间戳,可通过2种方法来实现.文中附上VB.NET代码,有需可供参考. 一.程序运行环境 编译环境: ...
- [Qt] 基本概念
QObject :所有 Qt 类的基类 QWidget类:包含所有组件的类 Widgets:组件,组成Qt界面的基本元素 window:界面,是不含有父组件的组件 Child Widgets:子组件, ...